はじめに
これまで Web 上のオーディオはかなり原始的であり、ごく
最近まで Flash や
QuickTime などのプラグインを通じて提供する必要がありました。
HTML5 に
audio
要素が導入されたことは
非常に重要であり、基本的なストリーミングオーディオ再生が可能になりました。しかし、
より複雑なオーディオアプリケーションを扱うには十分な機能がありません。
高度な Web ベースのゲームや対話型アプリケーションには、別の
解決策が必要です。この仕様の目標は、現代のゲームオーディオエンジンに見られる
機能に加えて、現代の
デスクトップオーディオ制作アプリケーションに見られるミキシング、処理、フィルタリング処理の一部を
含めることです。
API は、さまざまなユースケース [webaudio-usecases] を念頭に置いて設計されています。理想的には、 スクリプトによって制御され、ブラウザーで実行される 最適化された C++ エンジンで合理的に実装可能な あらゆるユースケースをサポートできる必要があります。とはいえ、 現代のデスクトップオーディオソフトウェアは非常に高度な 機能を備えている場合があり、その一部はこのシステムで構築することが 困難または不可能です。Apple の Logic Audio はそのようなアプリケーションの一つであり、 外部 MIDI コントローラー、任意のプラグインオーディオエフェクト およびシンセサイザー、高度に最適化されたディスクへの直接オーディオファイル 読み書き、緊密に統合されたタイムストレッチなどをサポートしています。 それでも、提案されているシステムは、 音楽関連のものを含む、かなり複雑なゲームや対話型アプリケーションの 広い範囲を十分にサポートできます。また、 WebGL が提供するより高度なグラフィックス機能を非常によく補完できます。API は、 後からより高度な機能を追加できるように 設計されています。
機能
API は次の主要な機能をサポートします:
-
単純または複雑な ミキシング/エフェクト構成のためのモジュール式ルーティング。
-
内部処理に 32 ビット浮動小数点数を使用する高ダイナミックレンジ。
-
サンプル精度でスケジュールされたサウンド再生を、 ドラムマシンやシーケンサーなど、非常に高いリズム精度を必要とする 音楽アプリケーション向けに低いレイテンシーで提供します。 これにはエフェクトを 動的に作成できることも含まれます。
-
エンベロープ、フェードイン / フェードアウト、グラニュラーエフェクト、フィルタースイープ、LFO などのためのオーディオパラメーターの自動化。
-
オーディオストリーム内のチャンネルを柔軟に処理し、 分割および結合できるようにします。
-
getUserMedia()からのMediaStreamを使用したライブオーディオ入力の処理。 -
WebRTC との統合
-
MediaStreamTrackAudioSourceNodeおよび [webrtc] を使用してリモートピアから受信したオーディオを処理します。 -
MediaStreamAudioDestinationNodeおよび [webrtc] を使用して、 生成または処理されたオーディオストリームをリモートピアに送信します。
-
-
オーディオストリームの合成と処理をスクリプトを使用して 直接行います。
-
幅広い 3D ゲームや没入型環境をサポートする空間化オーディオ:
-
パンニングモデル: equalpower、HRTF、パススルー
-
距離減衰
-
サウンドコーン
-
遮蔽 / オクルージョン
-
音源 / リスナー基準
-
-
幅広い 線形エフェクト、特に非常に高品質なルームエフェクトのための畳み込みエンジン。 可能なエフェクトの例を次に示します:
-
小さい / 大きい部屋
-
大聖堂
-
コンサートホール
-
洞窟
-
トンネル
-
廊下
-
森
-
円形劇場
-
出入口越しに聞こえる遠くの部屋の音
-
極端なフィルター
-
奇妙な逆再生エフェクト
-
極端なコームフィルターエフェクト
-
-
ミックス全体の制御と音質調整のためのダイナミクス圧縮
-
ローパス、ハイパス、およびその他の一般的なフィルター向けの効率的なバイクアッドフィルター。
-
歪みやその他の非線形エフェクトのためのウェーブシェーピングエフェクト
-
オシレーター
モジュール式ルーティング
モジュール式ルーティングでは、異なる
AudioNode
オブジェクト間を任意に接続できます。各ノードは
入力および/または 出力を持つことができます。
ソースノードは入力を持たず、
1 つの出力を持ちます。
デスティネーションノード
は 1 つの入力を持ち、出力を持ちません。フィルターなどの他のノードは、
ソースノードとデスティネーションノードの間に配置できます。
2 つのオブジェクトを接続するとき、開発者は低水準のストリーム形式の
詳細を気にする必要はありません。
適切な処理が自動的に行われます。
たとえば、モノラルオーディオストリームを
ステレオ入力に接続すると、左右のチャンネルへ
適切にミックスされます。
最も単純な場合、単一のソースを出力へ直接ルーティングできます。
すべてのルーティングは、単一の AudioDestinationNode
を含む AudioContext
内で行われます:
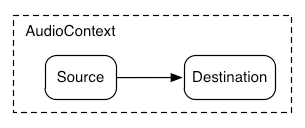
この単純なルーティングを示す、単一のサウンドを再生する簡単な例を次に示します:
const context= new AudioContext(); function playSound() { const source= context. createBufferSource(); source. buffer= dogBarkingBuffer; source. connect( context. destination); source. start( 0 ); }
3 つのソースと、最終出力段にダイナミクスコンプレッサーを備えた 畳み込みリバーブセンドを使用する、より複雑な例を次に示します:
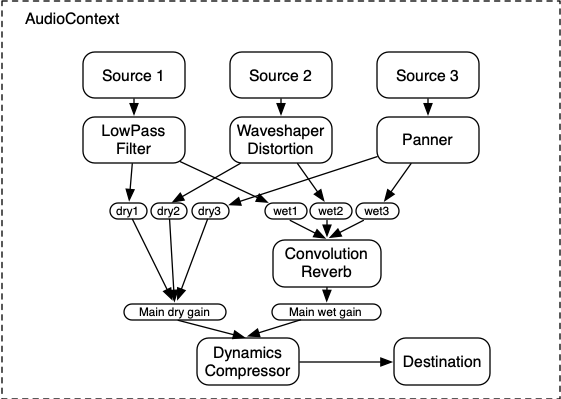
let context; let compressor; let reverb; let source1, source2, source3; let lowpassFilter; let waveShaper; let panner; let dry1, dry2, dry3; let wet1, wet2, wet3; let mainDry; let mainWet; function setupRoutingGraph() { context= new AudioContext(); // エフェクトノードを作成する。 lowpassFilter= context. createBiquadFilter(); waveShaper= context. createWaveShaper(); panner= context. createPanner(); compressor= context. createDynamicsCompressor(); reverb= context. createConvolver(); // メインのウェットとドライを作成する。 mainDry= context. createGain(); mainWet= context. createGain(); // 最終コンプレッサーを最終デスティネーションに接続する。 compressor. connect( context. destination); // メインのドライとウェットをコンプレッサーに接続する。 mainDry. connect( compressor); mainWet. connect( compressor); // リバーブをメインのウェットに接続する。 reverb. connect( mainWet); // いくつかのソースを作成する。 source1= context. createBufferSource(); source2= context. createBufferSource(); source3= context. createOscillator(); source1. buffer= manTalkingBuffer; source2. buffer= footstepsBuffer; source3. frequency. value= 440 ; // source1 を接続する dry1= context. createGain(); wet1= context. createGain(); source1. connect( lowpassFilter); lowpassFilter. connect( dry1); lowpassFilter. connect( wet1); dry1. connect( mainDry); wet1. connect( reverb); // source2 を接続する dry2= context. createGain(); wet2= context. createGain(); source2. connect( waveShaper); waveShaper. connect( dry2); waveShaper. connect( wet2); dry2. connect( mainDry); wet2. connect( reverb); // source3 を接続する dry3= context. createGain(); wet3= context. createGain(); source3. connect( panner); panner. connect( dry3); panner. connect( wet3); dry3. connect( mainDry); wet3. connect( reverb); // ソースを今すぐ開始する。 source1. start( 0 ); source2. start( 0 ); source3. start( 0 ); }
モジュール式ルーティングでは、
AudioNode
の出力を、
別の AudioNode
の動作を制御する
AudioParam
パラメーターへルーティングすることもできます。この場合、
ノードの出力は入力信号ではなく
変調信号として機能できます。
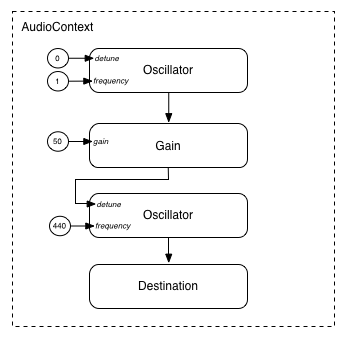
function setupRoutingGraph() { const context= new AudioContext(); // 変調信号を供給する低周波オシレーターを作成する const lfo= context. createOscillator(); lfo. frequency. value= 1.0 ; // 変調される高周波オシレーターを作成する const hfo= context. createOscillator(); hfo. frequency. value= 440.0 ; // ゲインによって変調信号の振幅が決まるゲインノードを作成する const modulationGain= context. createGain(); modulationGain. gain. value= 50 ; // グラフを構成し、オシレーターを開始する lfo. connect( modulationGain); modulationGain. connect( hfo. detune); hfo. connect( context. destination); hfo. start( 0 ); lfo. start( 0 ); }
API の概要
定義されるインターフェイスは次のとおりです:
-
AudioContext インターフェイス。
AudioNode間の接続を表す オーディオ信号グラフを含みます。 -
AudioNodeインターフェイス。オーディオソース、オーディオ出力、および中間処理モジュールを 表します。AudioNodeは モジュール式に動的に接続できます。AudioNodeはAudioContextのコンテキスト内に存在します。 -
AnalyserNodeインターフェイス。音楽ビジュアライザーや その他の可視化アプリケーションで使用するAudioNodeです。 -
AudioBufferインターフェイス。メモリー上に存在する オーディオ資産を扱うためのものです。これらは単発のサウンドや、 より長いオーディオクリップを表すことができます。 -
AudioBufferSourceNodeインターフェイス。 AudioBuffer からオーディオを生成するAudioNodeです。 -
AudioDestinationNodeインターフェイス。レンダリングされたすべてのオーディオの最終 デスティネーションを表すAudioNodeサブクラスです。 -
AudioParamインターフェイス。音量など、AudioNodeの 動作の個々の側面を制御するためのものです。 -
AudioListenerインターフェイス。空間化のためにPannerNodeとともに動作します。 -
AudioWorkletインターフェイス。スクリプトを使用してオーディオを直接処理できる カスタムノードを作成するファクトリーを 表します。 -
AudioWorkletGlobalScopeインターフェイス。AudioWorkletProcessor の処理スクリプトが実行される コンテキストです。 -
AudioWorkletNodeインターフェイス。AudioWorkletProcessor 内で処理されるノードを表すAudioNodeです。 -
AudioWorkletProcessorインターフェイス。 オーディオワーカー内の単一のノードインスタンスを表します。 -
BiquadFilterNodeインターフェイス。次のような一般的な低次フィルター用のAudioNodeです:-
ローパス
-
ハイパス
-
バンドパス
-
ローシェルフ
-
ハイシェルフ
-
ピーキング
-
ノッチ
-
オールパス
-
-
ChannelMergerNodeインターフェイス。複数の オーディオストリームのチャンネルを単一のオーディオストリームへ結合するためのAudioNodeです。 -
ChannelSplitterNodeインターフェイス。ルーティンググラフ内の オーディオストリームの個々のチャンネルへアクセスするためのAudioNodeです。 -
ConstantSourceNodeインターフェイス。値の自動化を可能にするAudioParamを使用して、名目上一定の出力値を生成するAudioNodeです。 -
ConvolverNodeインターフェイス。リアルタイムの 線形エフェクト(コンサートホールの響きなど)を適用するためのAudioNodeです。 -
DynamicsCompressorNodeインターフェイス。ダイナミクス圧縮のためのAudioNodeです。 -
IIRFilterNodeインターフェイス。汎用 IIR フィルター用のAudioNodeです。 -
MediaElementAudioSourceNodeインターフェイス。audio、video、 またはその他のメディア要素からのオーディオソースとなるAudioNodeです。 -
MediaStreamAudioSourceNodeインターフェイス。ライブオーディオ入力やリモートピアなどのMediaStreamからのオーディオソースとなるAudioNodeです。 -
MediaStreamTrackAudioSourceNodeインターフェイス。MediaStreamTrackからのオーディオソースとなるAudioNodeです。 -
MediaStreamAudioDestinationNodeインターフェイス。 リモートピアへ送信されるMediaStreamへのオーディオデスティネーションとなるAudioNodeです。 -
PannerNodeインターフェイス。3D 空間内でオーディオを 空間化 / 配置するためのAudioNodeです。 -
PeriodicWaveインターフェイス。OscillatorNodeで使用するカスタム周期波形を指定するためのものです。 -
OscillatorNodeインターフェイス。周期波形を生成するためのAudioNodeです。 -
StereoPannerNodeインターフェイス。ステレオストリーム内のオーディオ 入力を等電力で配置するためのAudioNodeです。 -
WaveShaperNodeインターフェイス。歪みやその他のより微妙な温かみを加える効果のために 非線形ウェーブシェーピング エフェクトを適用するAudioNodeです。 -
AudioPlaybackStatsインターフェイス。AudioContextから再生されたオーディオに関する統計を提供します。
Web Audio API には非推奨となったものの、 代替機能の実装経験が得られるまでまだ削除されていない 機能もいくつかあります:
-
ScriptProcessorNodeインターフェイス。スクリプトを使用してオーディオを直接生成または処理するためのAudioNodeです。 -
AudioProcessingEventインターフェイス。ScriptProcessorNodeオブジェクトで使用されるイベント型です。
1. オーディオ API
1.1.
BaseAudioContext
インターフェイス
このインターフェイスは、AudioNode
オブジェクトの集合とその接続を表します。信号を
AudioDestinationNode
へ任意にルーティングできます。
ノードは
コンテキストから作成され、その後互いに接続されます。
BaseAudioContext
は直接インスタンス化されず、
代わりに具象インターフェイスである
AudioContext
(リアルタイムレンダリング用)および
OfflineAudioContext
(オフラインレンダリング用)によって拡張されます。
BaseAudioContext
は、最初は空である Promise の順序付きリストである
内部スロット
[[pending promises]] を持って作成されます。
各 BaseAudioContext
は一意の
メディア要素イベントタスクソースを持ちます。
さらに、BaseAudioContext
は、AudioContextState
の値を取り、どちらも最初は "suspended"
に設定される、複数のプライベートスロット [[rendering thread state]] および
[[control thread state]] と、
同じく AudioContextState
の値を取り、最初は
null に設定される [[state before interruption]]
、および符号なし整数であるプライベートスロット [[render quantum
size]] を持ちます。
enum {AudioContextState "suspended" ,"running" ,"closed" ,"interrupted" };
| 列挙値 | 説明 |
|---|---|
"suspended"
| このコンテキストは現在一時停止中です(コンテキスト時間は 進行しておらず、オーディオハードウェアは電源を切られているか解放されている場合があります)。 |
"running"
| オーディオが処理されています。 |
"closed"
| このコンテキストは解放されており、オーディオの処理には これ以上使用できません。すべてのシステムオーディオリソースが解放されています。 |
"interrupted"
| このコンテキストは現在中断されており、中断が終了するまでオーディオを処理できません。 |
enum {AudioContextRenderSizeCategory "default" ,"hardware" };
| 列挙型の説明 | |
|---|---|
"default"
| AudioContext のレンダー量子サイズは既定値の 128 フレームです。 |
"hardware"
|
ユーザーエージェントは、現在の構成に最適なレンダー量子サイズを選択します。
注: これはホストに関する情報を公開し、 フィンガープリンティングに使用される可能性があります。 |
callback DecodeErrorCallback =undefined (DOMException );error callback DecodeSuccessCallback =undefined (AudioBuffer ); [decodedData Exposed =Window ]interface BaseAudioContext :EventTarget {readonly attribute AudioDestinationNode destination ;readonly attribute float sampleRate ;readonly attribute double currentTime ;readonly attribute AudioListener listener ;readonly attribute AudioContextState state ;readonly attribute unsigned long renderQuantumSize ; [SameObject ,SecureContext ]readonly attribute AudioWorklet audioWorklet ;attribute EventHandler onstatechange ;AnalyserNode createAnalyser ();BiquadFilterNode createBiquadFilter ();AudioBuffer createBuffer (unsigned long ,numberOfChannels unsigned long ,length float );sampleRate AudioBufferSourceNode createBufferSource ();ChannelMergerNode createChannelMerger (optional unsigned long numberOfInputs = 6);ChannelSplitterNode createChannelSplitter (optional unsigned long numberOfOutputs = 6);ConstantSourceNode createConstantSource ();ConvolverNode createConvolver ();DelayNode createDelay (optional double maxDelayTime = 1.0);DynamicsCompressorNode createDynamicsCompressor ();GainNode createGain ();IIRFilterNode createIIRFilter (sequence <double >,feedforward sequence <double >);feedback OscillatorNode createOscillator ();PannerNode createPanner ();PeriodicWave createPeriodicWave (sequence <float >,real sequence <float >,imag optional PeriodicWaveConstraints = {});constraints ScriptProcessorNode createScriptProcessor (optional unsigned long bufferSize = 0,optional unsigned long numberOfInputChannels = 2,optional unsigned long numberOfOutputChannels = 2);StereoPannerNode createStereoPanner ();WaveShaperNode createWaveShaper ();Promise <AudioBuffer >decodeAudioData (ArrayBuffer ,audioData optional DecodeSuccessCallback ?,successCallback optional DecodeErrorCallback ?); };errorCallback
1.1.1. 属性
audioWorklet, 型は AudioWorklet、 読み取り専用-
[HTML] および
AudioWorkletによって定義されたアルゴリズムを介して、AudioWorkletProcessorクラス定義を含むスクリプトをインポートできるWorkletオブジェクトへのアクセスを可能にします。 currentTime, 型は double、読み取り専用-
これは、コンテキストのレンダリンググラフが直近に処理した オーディオブロック内の最後のサンプルフレームの 直後のサンプルフレームの時刻(秒)です。 コンテキストのレンダリンググラフがまだオーディオブロックを 処理していない場合、
currentTimeの値は 0 です。currentTimeの時間座標系では、 0 の値はグラフによって処理される最初のブロック内の最初の サンプルフレームに対応します。このシステムでの経過時間は、BaseAudioContextによって生成されるオーディオストリーム内の経過時間に対応しますが、 システム内の他のクロックと同期していない場合があります。(OfflineAudioContextでは、ストリームが どのデバイスでも実際に再生されていないため、実時間への 近似すらありません。)Web Audio API のすべてのスケジュール時刻は、
currentTimeの値を基準とします。BaseAudioContextが "running" 状態にある場合、この属性の値は単調増加し、 レンダリングスレッドによって一定の増分で更新されます。 これは 1 つのレンダー量子に対応します。したがって、実行中の コンテキストでは、システムがオーディオブロックを処理するにつれてcurrentTimeは着実に増加し、 常に次に処理されるオーディオブロックの開始時刻を 表します。また、現在の状態でスケジュールされた変更が 効果を発揮し得る最も早い時刻でもあります。currentTimeは返される前に、制御スレッド上でアトミックに読み取られなければなりません。 destination, 型は AudioDestinationNode、読み取り専用-
すべてのオーディオの最終デスティネーションを表す単一の入力を持つ
AudioDestinationNodeです。通常、これは実際のオーディオハードウェアを表します。 オーディオを実際にレンダリングしているすべてのAudioNodeは、直接または間接的にdestinationに接続されます。 listener, 型は AudioListener、 読み取り専用-
3D 空間化に使用される
AudioListenerです。 onstatechange, 型は EventHandler-
AudioContext の状態が変更されたとき(すなわち、 対応する Promise が解決されるとき)に
BaseAudioContextへ配送されるイベントのイベントハンドラーを設定するために使用されるプロパティです。 このイベントハンドラーのイベント型は、statechangeです。Eventインターフェイスを使用するイベントがイベント ハンドラーへ配送され、ハンドラーは AudioContext の状態を直接照会できます。 新しく作成された AudioContext は常にsuspended状態から開始し、状態が別の状態へ変化するたびに 状態変更イベントが発火します。この イベントはcompleteイベントが発火する前に発火します。 sampleRate, 型は float、読み取り専用-
BaseAudioContextがオーディオを扱うサンプルレート(1 秒あたりのサンプルフレーム数)です。 コンテキスト内のすべてのAudioNodeはこのレートで動作すると想定されます。この想定により、 リアルタイム処理ではサンプルレートコンバーターや "varispeed" プロセッサーは サポートされません。 ナイキスト周波数は、このサンプルレート値の半分です。 state, 型は AudioContextState、読み取り専用-
BaseAudioContextの現在の状態を記述します。この 属性を取得すると、[[control thread state]]スロットの内容が返されます。 renderQuantumSize, 型は unsigned long、読み取り専用-
この属性を取得すると、
[[render quantum size]]スロットの値が返されます。
1.1.2. メソッド
createAnalyser()-
パラメーターなし。戻り値の型:
AnalyserNode createBiquadFilter()-
複数の一般的なフィルター型のいずれかとして構成できる 2 次フィルターを表す
BiquadFilterNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:BiquadFilterNode createBuffer(numberOfChannels, length, sampleRate)-
指定されたサイズの AudioBuffer を作成します。バッファー内のオーディオデータは 0 で初期化されます(無音)。 いずれかの引数が負、0、または 規定の範囲外の場合、
NotSupportedError例外を投げなければなりません。BaseAudioContext.createBuffer() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 numberOfChannelsunsigned long✘ ✘ バッファーが持つチャンネル数を決定します。実装は少なくとも 32 チャンネルをサポートしなければなりません。 lengthunsigned long✘ ✘ バッファーのサイズをサンプルフレーム単位で決定します。これは少なくとも 1 でなければなりません。 sampleRatefloat✘ ✘ バッファー内のリニア PCM オーディオデータのサンプルレートを、 1 秒あたりのサンプルフレーム数で記述します。必要なサポート範囲については、 § 2.4 サポートされるサンプルレートを参照してください。 戻り値の型:AudioBuffer createBufferSource()-
AudioBufferSourceNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:AudioBufferSourceNode createChannelMerger(numberOfInputs)-
チャンネルマージャーを表す
ChannelMergerNodeのファクトリーメソッドです。numberOfInputsが 1 未満、またはサポートされるチャンネル数を超える場合、IndexSizeError例外を投げなければなりません。BaseAudioContext.createChannelMerger(numberOfInputs) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 numberOfInputsunsigned long✘ ✔ 入力数を決定します。32 までの値をサポートしなければなりません。指定されない場合、 6が使用されます。戻り値の型:ChannelMergerNode createChannelSplitter(numberOfOutputs)-
チャンネルスプリッターを表す
ChannelSplitterNodeのファクトリーメソッドです。numberOfOutputsが 1 未満、またはサポートされるチャンネル数を超える場合、IndexSizeError例外を投げなければなりません。BaseAudioContext.createChannelSplitter(numberOfOutputs) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 numberOfOutputsunsigned long✘ ✔ 出力数です。32 までの値をサポートしなければなりません。指定されない場合、 6が使用されます。戻り値の型:ChannelSplitterNode createConstantSource()-
ConstantSourceNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:ConstantSourceNode createConvolver()-
パラメーターなし。戻り値の型:
ConvolverNode createDelay(maxDelayTime)-
DelayNodeのファクトリーメソッドです。 初期の既定の 遅延時間は 0 秒です。BaseAudioContext.createDelay(maxDelayTime) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 maxDelayTimedouble✘ ✔ ディレイラインで許容される最大遅延時間を秒単位で指定します。指定する場合、この値は 0 より大きく 3 分未満でなければならず、 そうでなければ NotSupportedError例外を投げなければなりません。 指定されない場合、1が使用されます。戻り値の型:DelayNode createDynamicsCompressor()-
DynamicsCompressorNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:DynamicsCompressorNode createGain()-
GainNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:GainNode createIIRFilter(feedforward, feedback)-
BaseAudioContext.createIIRFilter() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 feedforwardsequence<double>✘ ✘ IIR フィルターの伝達関数の フィードフォワード(分子)係数の配列です。この配列の最大長は 20 です。すべての値が 0 の場合、 InvalidStateErrorを投げなければなりません。配列長が 0 または 20 より大きい場合、NotSupportedErrorを投げなければなりません。feedbacksequence<double>✘ ✘ IIR フィルターの伝達関数のフィードバック(分母)係数の配列です。 この配列の最大長は 20 です。配列の最初の要素が 0 の場合、 InvalidStateErrorを投げなければなりません。配列長が 0 または 20 より大きい場合、NotSupportedErrorを投げなければなりません。戻り値の型:IIRFilterNode createOscillator()-
パラメーターなし。戻り値の型:
OscillatorNode createPanner()-
PannerNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:PannerNode createPeriodicWave(real, imag, constraints)-
PeriodicWaveを作成するファクトリーメソッドです。このメソッドを呼び出すときは、 次の手順を実行します:-
realとimagの長さが同じでない場合、IndexSizeErrorを投げなければなりません。 -
o を
PeriodicWaveOptions型の新しいオブジェクトとします。 -
このファクトリーメソッドに渡された
realおよびimagパラメーターを、それぞれ o 上の 同名の属性に設定します。 -
o の
disableNormalization属性を、 ファクトリーメソッドに渡されたconstraints属性のdisableNormalization属性の値に設定します。 -
新しい
PeriodicWavep を構築し、このファクトリー メソッドが呼び出されたBaseAudioContextを第 1 引数として、さらに o を渡します。 -
p を返します。
BaseAudioContext.createPeriodicWave() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 realsequence<float>✘ ✘ 余弦パラメーターのシーケンスです。より詳しい説明については、 realコンストラクター引数を参照してください。imagsequence<float>✘ ✘ 正弦パラメーターのシーケンスです。より詳しい説明については、 imagコンストラクター引数を参照してください。constraintsPeriodicWaveConstraints✘ ✔ 指定されない場合、波形は正規化されます。それ以外の場合、波形は constraintsで指定された値に従って正規化されます。戻り値の型:PeriodicWave -
createScriptProcessor(bufferSize, numberOfInputChannels, numberOfOutputChannels)-
ScriptProcessorNodeのファクトリーメソッドです。 このメソッドは、AudioWorkletNodeに置き換えられることを意図しているため、非推奨です。 スクリプトを使用してオーディオを直接処理するためのScriptProcessorNodeを作成します。bufferSizeまたはnumberOfInputChannelsまたはnumberOfOutputChannelsが有効範囲外の場合、IndexSizeError例外を投げなければなりません。numberOfInputChannelsとnumberOfOutputChannelsの両方を 0 にすることは無効です。 この場合、IndexSizeError例外を投げなければなりません。BaseAudioContext.createScriptProcessor(bufferSize, numberOfInputChannels, numberOfOutputChannels) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 bufferSizeunsigned long✘ ✔ bufferSizeパラメーターは、サンプルフレーム単位でバッファーサイズを決定します。渡されない場合、 または値が 0 の場合、実装は 指定された環境に最適なバッファーサイズを選択します。この値は ノードの存続期間を通じて一定の 2 の累乗になります。それ以外の場合、作者が明示的に bufferSize を指定するなら、 次のいずれかの値でなければなりません: 256, 512, 1024, 2048, 4096, 8192, 16384。この値は、audioprocessイベントが配送される頻度と、各呼び出しで処理する必要があるサンプルフレーム数を制御します。bufferSizeの値が小さいほど、より低い(より良い)レイテンシーになります。値が大きいほど、 オーディオの途切れやグリッチを回避するために必要になります。 作者は、このバッファーサイズを指定せず、 レイテンシーとオーディオ品質のバランスが取れた適切なバッファーサイズを実装に 選択させることが推奨されます。このパラメーターの値が 上記の許可された 2 の累乗値のいずれでもない場合、IndexSizeErrorを投げなければなりません。numberOfInputChannelsunsigned long✘ ✔ このパラメーターは、このノードの入力のチャンネル数を決定します。既定値は 2 です。32 までの値をサポートしなければなりません。チャンネル数がサポートされていない場合、 NotSupportedErrorを投げなければなりません。numberOfOutputChannelsunsigned long✘ ✔ このパラメーターは、このノードの出力のチャンネル数を決定します。既定値は 2 です。32 までの値をサポートしなければなりません。チャンネル数がサポートされていない場合、 NotSupportedErrorを投げなければなりません。戻り値の型:ScriptProcessorNode createStereoPanner()-
StereoPannerNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:StereoPannerNode createWaveShaper()-
非線形歪みを表す
WaveShaperNodeのファクトリーメソッドです。パラメーターなし。戻り値の型:WaveShaperNode decodeAudioData(audioData, successCallback, errorCallback)-
ArrayBufferに含まれるオーディオファイルデータを非同期にデコードします。ArrayBufferは、たとえばresponseTypeを"arraybuffer"に設定した後、XMLHttpRequestのresponse属性から読み込むことができます。オーディオ ファイルデータは、audio要素がサポートする任意の形式にできます。decodeAudioData()に渡されるバッファーの content-type は、[mimesniff] に記述されているとおり、スニッフィングによって決定されます。この関数とやり取りする主な方法は Promise の戻り値を介するものですが、コールバックパラメーターは レガシー上の理由で提供されています。
ファイルが破損している場合、実装が作者へ警告することが推奨されます。 これは破壊的変更になるため、例外を投げることはできません。
注: 圧縮オーディオデータのバイトストリームが破損しているものの、 デコード自体は続行できる場合、実装は たとえば開発者ツールを通じて作者へ警告することが推奨されます。decodeAudioDataが 呼び出されたとき、次の手順を制御 スレッド上で実行しなければなりません:-
this の関連するグローバルオブジェクトの関連付けられた Document が完全にアクティブでない場合、 "
InvalidStateError"DOMExceptionで拒否された Promiseを返します。 -
promise を新しい Promise とします。
-
audioDataが切り離されていない場合、次の手順を実行します:-
promise を
[[pending promises]]に追加します。 -
audioDataArrayBufferを切り離します。 この操作が例外を投げた場合、手順 4.1 へ移動します。 -
別のスレッドで実行するデコード操作をキューに入れます。
-
-
それ以外の場合、次のエラー手順を実行します:
-
error を
DataCloneErrorとします。 -
promise を error で拒否し、
[[pending promises]]から削除します。 -
メディア要素タスクをキューに入れ、
errorCallbackを error とともに呼び出します。
-
-
promise を返します。
別のスレッドで実行するデコード操作をキューに入れるとき、 次の手順は制御スレッド でもレンダリング スレッドでもないスレッド上で実行しなければならず、 これをデコードスレッドと呼びます。注: 複数の
デコードスレッドを 並列に実行して、decodeAudioDataの複数の呼び出しを処理できます。-
can decode を、最初は true に設定されたブーリアンフラグとします。
-
audioDataの MIME 型を、 MIME スニッフィング § 6.2 オーディオまたは動画型パターンへのマッチングを使用して 判定することを試みます。オーディオ または動画型パターンマッチングアルゴリズムがundefinedを返した場合、can decode を false に設定します。 -
can decode が true の場合、エンコードされた
audioDataをリニア PCMへ デコードすることを試みます。 失敗した場合、can decode を false に設定します。メディアバイトストリームに複数のオーディオトラックが含まれている場合、 最初のトラックだけをリニア PCMへデコードします。
注: デコード処理をより細かく制御する必要がある 作者は、 [WEBCODECS] を使用できます。
-
can decode が
falseの場合、 メディア要素タスクをキューに入れ、次の手順を実行します:-
error を、名前が
EncodingErrorであるDOMExceptionとします。-
promise を error で拒否し、
[[pending promises]]から削除します。
-
-
errorCallbackが 欠けていない場合、errorCallbackを error とともに呼び出します。
-
-
それ以外の場合:
-
デコードされたリニア PCM オーディオデータを表す結果を取得し、 そのサンプルレートが
audioDataのサンプルレートと異なる場合は、BaseAudioContextのサンプルレートへリサンプリングします。 -
メディア要素タスクをキューに入れ、次の手順を実行します:
-
buffer を、 最終結果 (必要に応じてサンプルレート変換を実行した後)を含む
AudioBufferとします。 -
promise を buffer で解決します。
-
successCallbackが欠けていない場合、successCallbackを buffer とともに呼び出します。
-
-
BaseAudioContext.decodeAudioData() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 audioDataArrayBuffer✘ ✘ 圧縮されたオーディオデータを含む ArrayBuffer。 successCallbackDecodeSuccessCallback?✔ ✔ デコードが完了したときに呼び出されるコールバック関数。このコールバックへの唯一の 引数は、デコードされた PCM オーディオデータを表す AudioBuffer です。 errorCallbackDecodeErrorCallback?✔ ✔ オーディオファイルのデコード中にエラーが発生した場合に呼び出されるコールバック関数。 戻り値の型:Promise<AudioBuffer> -
1.1.3.
コールバック DecodeSuccessCallback()
のパラメーター
decodedData, 型はAudioBuffer-
デコードされたオーディオデータを含む AudioBuffer。
1.1.4.
コールバック DecodeErrorCallback()
のパラメーター
error, 型はDOMException-
デコード中に発生したエラー。
1.1.5. ライフタイム
一度作成されると、AudioContext
は、再生するサウンドがなくなるか、ページがなくなるまで
サウンドの再生を続けます。
1.1.6. イントロスペクションまたはシリアライズプリミティブの欠如
Web Audio API は、オーディオソースのスケジューリングに
発行したら忘れる方式を採用しています。つまり、ソースノードは、AudioContext
のライフタイム中に各ノートごとに作成され、
グラフから明示的に削除されることはありません。これは
シリアライズ API とは互換性がありません。シリアライズできる
安定したノード集合が存在しないためです。
さらに、イントロスペクション API があると、コンテンツスクリプトが ガベージコレクションを観測できるようになります。
1.1.7.
BaseAudioContext
サブクラスに関連付けられたシステムリソース
サブクラス AudioContext
および OfflineAudioContext
は、コストの高いオブジェクトと見なすべきです。これらのオブジェクトの作成では、
優先度の高いスレッドの作成や、低レイテンシーの
システムオーディオストリームの使用が伴う場合があり、どちらもエネルギー消費に影響します。
通常、1 つの文書内に複数の
AudioContext
を作成する必要はありません。
BaseAudioContext
サブクラスを構築または再開することには、そのコンテキスト用の
システムリソースの
取得が伴います。
AudioContext
の場合、これにはさらに
システムオーディオストリームの作成が必要です。これらの操作は、コンテキストが
関連付けられたオーディオグラフから出力の生成を開始した時点で返ります。
さらに、ユーザーエージェントは、実装で定義された
AudioContext
の最大数を持つことができ、それを超えて
新しい AudioContext
を作成しようとすると失敗し、NotSupportedError
を投げます。
suspend
および close
により、作者はスレッド、
プロセス、およびオーディオストリームを含むシステム
リソースを解放できます。BaseAudioContext
を一時停止すると、実装はそのリソースの一部を解放でき、
後で resume
を呼び出すことによって動作を続けられます。
AudioContext
を閉じると、実装はそのすべての
リソースを解放でき、その後は再び使用または再開できなくなります。
注: たとえば、これには オーディオコールバックが定期的に 発火するのを待つことや、ハードウェアが 処理可能になるまで待つことが含まれる場合があります。
1.2.
AudioContext
インターフェイス
このインターフェイスは、その
AudioDestinationNode
が、ユーザーに向けた信号を生成するリアルタイムの
出力デバイスへルーティングされるオーディオグラフを表します。ほとんどの
ユースケースでは、文書ごとに 1 つの AudioContext
だけが使用されます。
enum {AudioContextLatencyCategory "balanced" ,"interactive" ,"playback" };
| 列挙値 | 説明 |
|---|---|
"balanced"
| オーディオ出力のレイテンシーと消費電力のバランスを取ります。 |
"interactive"
| グリッチを発生させずに可能な限り低いオーディオ出力レイテンシーを 提供します。これが既定値です。 |
"playback"
| オーディオ出力のレイテンシーよりも、中断のない継続的な再生を 優先します。消費電力が最も低くなります。 |
enum {AudioSinkType "none" };
| 列挙値 | 説明 |
|---|---|
"none"
| オーディオグラフは、オーディオ出力デバイスを通して 再生されることなく処理されます。 |
[Exposed =Window ]interface AudioContext :BaseAudioContext {constructor (optional AudioContextOptions contextOptions = {});readonly attribute double baseLatency ;readonly attribute double outputLatency ; [SecureContext ]readonly attribute (DOMString or AudioSinkInfo )sinkId ;attribute EventHandler onsinkchange ;attribute EventHandler onerror ; [SameObject ]readonly attribute AudioPlaybackStats playbackStats ;AudioTimestamp getOutputTimestamp ();Promise <undefined >resume ();Promise <undefined >suspend ();Promise <undefined >close (); [SecureContext ]Promise <undefined >((setSinkId DOMString or AudioSinkOptions ));sinkId MediaElementAudioSourceNode createMediaElementSource (HTMLMediaElement );mediaElement MediaStreamAudioSourceNode createMediaStreamSource (MediaStream );mediaStream MediaStreamTrackAudioSourceNode createMediaStreamTrackSource (MediaStreamTrack );mediaStreamTrack MediaStreamAudioDestinationNode createMediaStreamDestination (); };
AudioContext
は、ユーザーエージェントがコンテキストの状態を "suspended"
から
"running"
へ遷移することを許可する場合、開始を
許可されていると言います。
ユーザーエージェントは、この最初の遷移を許可せず、
AudioContext
の
関連するグローバルオブジェクトが
スティッキーアクティベーションを持つ場合にのみ許可してもかまいません。
AudioContext
は次の内部スロットを持ちます:
[[suspended by user]]-
コンテキストがユーザーコードによって一時停止されたかどうかを表すブーリアンフラグ。 初期値は
falseです。 [[sink ID]]-
現在のオーディオ出力デバイスの識別子または情報をそれぞれ表す、
DOMStringまたはAudioSinkInfoです。初期値は""であり、これは既定のオーディオ出力 デバイスを意味します。 [[sink ID at construction]]-
構築時に要求されたオーディオ出力デバイスの識別子または情報を それぞれ表す、
DOMStringまたはAudioSinkInfoです。初期値は""であり、これは 既定のオーディオ出力デバイスを意味します。 [[pending resume promises]][[playback stats]]-
AudioPlaybackStatsのインスタンスが保存されるスロット。
1.2.1. コンストラクター
AudioContext(contextOptions)-
現在の設定オブジェクトの関連するグローバルオブジェクトの 関連付けられた Document が完全にアクティブでない場合、 "
InvalidStateError" を投げて、これらの手順を中止します。AudioContextを作成するとき、次の手順を実行します:-
context を新しい
AudioContextオブジェクトとします。 -
context の
[[control thread state]]をsuspendedに設定します。 -
context の
[[rendering thread state]]をsuspendedに設定します。 -
context の
[[state before interruption]]をnullに設定します。 -
messageChannel を新しい
MessageChannelとします。 -
controlSidePort を messageChannel の
port1属性の値とします。 -
renderingSidePort を messageChannel の
port2属性の値とします。 -
serializedRenderingSidePort を StructuredSerializeWithTransfer(renderingSidePort, « renderingSidePort ») の結果とします。
-
この
audioWorkletのportを controlSidePort に設定します。 -
serializedRenderingSidePort とともに、 AudioContextGlobalScope 上の MessagePort を設定するための 制御メッセージをキューに入れます。
-
contextOptionsが指定されている場合、次の サブ手順を実行します:-
sinkIdが指定されている場合、sinkId をcontextOptions.の値とし、 次のサブ手順を実行します:sinkId-
sinkId と
[[sink ID]]の両方がDOMString型で、 かつ互いに等しい場合、この サブ手順を中止します。 -
sinkId が
AudioSinkOptions型で、[[sink ID]]がAudioSinkInfo型であり、 sinkId 内のtypeと[[sink ID]]内のtypeが等しい場合、このサブ手順を中止します。 -
sinkId が
DOMString型の場合、[[sink ID at construction]]を sinkId に設定し、この サブ手順を中止します。 -
sinkId が
AudioSinkOptions型の場合、[[sink ID at construction]]を、sinkId のtypeの値で作成された新しいAudioSinkInfoインスタンスに設定します。
-
-
context の内部レイテンシーを、
latencyHintで説明されているとおり、contextOptions.に従って設定します。latencyHint -
contextOptions.が指定されている場合、context のsampleRatesampleRateをこの値に設定します。それ以外の場合、次のサブ手順に従います:-
sinkId が空文字列または
AudioSinkOptions型の場合、既定の出力 デバイスのサンプルレートを使用します。このサブ手順を中止します。 -
sinkId が
DOMStringの場合、sinkId によって識別される 出力デバイスのサンプルレートを使用します。このサブ手順を中止します。
contextOptions.が出力デバイスのサンプルレートと異なる場合、ユーザーエージェントは オーディオ出力を出力デバイスのサンプルレートに一致するよう リサンプリングしなければなりません。sampleRate注: リサンプリングが 必要な場合、context のレイテンシーが、 場合によっては大幅に影響を受ける可能性があります。
-
-
context の
[[render quantum size]]を、contextOptions.の値に基づいて設定します:renderSizeHint-
既定値
"default"の場合、[[render quantum size]]プライベートスロットを 128 に設定します。 -
それ以外で、値が
"hardware"の場合、[[render quantum size]]プライベートスロットを 0 に設定します。 -
それ以外で、整数が渡されている場合、その値が § 2.5 サポートされるレンダー量子 サイズで指定された範囲外なら、
NotSupportedErrorを投げなければなりません。それ以外の場合、[[render quantum size]]プライベートスロットを渡された値に設定します。
-
-
-
context が開始を許可されている場合、処理を開始するための 制御 メッセージを送信します。
-
[[playback stats]]を新しいAudioPlaybackStatsインスタンスに設定します。 -
context を返します。
処理を開始するために制御 メッセージを送信するとは、 次の手順を実行することを意味します:-
validationResult を、
[[sink ID at construction]]のシンク識別子の検証 の戻り値とします。 -
validationResult が
falseの場合、次の手順を実行します:-
[[sink ID]]を空文字列に設定します。 -
メディア要素タスクをキューに入れ、
errorという名前のイベントを発火させ、AudioContextに配送して、以降の手順を中止します。
-
-
レンダリングに使用する次のオーディオ出力デバイス用の システムリソースを 取得することを、
[[sink ID at construction]]に基づいて試みます:-
空文字列の場合は既定のオーディオ出力デバイス。
-
[[sink ID at construction]]によって識別されるオーディオ出力デバイス。-
リソースの取得に失敗した場合、 メディア要素 タスクをキューに入れ、
errorという名前のイベントを発火させ、AudioContextに配送し、 以降の手順を中止します。
-
-
-
[[sink ID]]を[[sink ID at construction]]の値に設定します。 -
AudioContext上のthis の[[rendering thread state]]をrunningに設定します。 -
メディア要素タスクをキューに入れ、 次の手順を実行します:
-
AudioContextの[[render quantum size]]が 0 の場合、 リソース取得中に選択された実際のハードウェアレンダー量子サイズに 設定します。 -
AudioContextのstate属性を "running" に設定します。 -
statechangeという名前のイベントを発火させ、AudioContextに配送します。
-
注:
AudioContextが引数なしで構築され、リソース 取得に失敗した場合、ユーザーエージェントは オーディオ出力デバイスをエミュレートする仕組みを使用して、オーディオグラフを黙ってレンダリングしようとします。AudioWorkletGlobalScope上のMessagePortを設定するために制御 メッセージを送信するとは、AudioWorkletGlobalScopeへ転送された serializedRenderingSidePort を使用して、 レンダリング スレッド上で次の手順を実行することを意味します:-
deserializedPort を StructuredDeserialize(serializedRenderingSidePort, 現在の Realm) の結果とします。
-
portを deserializedPort に設定します。
AudioContext.constructor(contextOptions) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextOptionsAudioContextOptions✘ ✔ AudioContextをどのように構築するかを制御する、ユーザー指定のオプション。 -
1.2.2. 属性
baseLatency, 型は double、読み取り専用-
これは、
AudioContextがオーディオをAudioDestinationNodeからオーディオサブシステムへ渡す際に発生する処理レイテンシーの秒数を表します。AudioDestinationNodeの出力とオーディオハードウェアの間の その他の処理によって発生し得る追加のレイテンシーは含まず、 特にオーディオグラフ自体で発生するレイテンシーは含みません。たとえば、オーディオコンテキストが既定のレンダー 量子サイズで 44.1 kHz で動作し、
AudioDestinationNodeが内部的にダブルバッファリングを実装し、 各レンダー量子ごとにオーディオを処理して出力できる場合、 処理レイテンシーはおよそ \((2\cdot128)/44100 = 5.805 \mathrm{ ms}\) です。 outputLatency, 型は double、読み取り専用-
オーディオ出力レイテンシーの秒単位の推定値、すなわち、 UA がホストシステムにバッファーの再生を要求した時刻と、 バッファー内の最初のサンプルが オーディオ出力デバイスによって実際に処理される時刻との間隔です。 音響信号を生成するスピーカーやヘッドホンなどの デバイスの場合、後者の時刻はサンプルの 音が生成される時刻を指します。
outputLatency属性の値は、プラットフォームと 接続されているオーディオ出力デバイスのハードウェアに依存します。outputLatency属性の値は、コンテキストの実行中や 関連付けられたオーディオ出力デバイスが変更されたときに変化する可能性があります。 正確な同期が必要な場合、この値を頻繁に 照会すると有用です。 sinkId, 型は(DOMString or AudioSinkInfo)、読み取り専用-
[[sink ID]]内部スロットの値を返します。この 属性は更新時にキャッシュされ、キャッシュ後は同じオブジェクトを 返します。 onsinkchange, 型は EventHandler-
setSinkId()のイベントハンドラーです。 このイベントハンドラーのイベント型はsinkchangeです。このイベントは、 出力デバイスの変更が完了したときに配送されます。注: これは
AudioContextの構築時に行われる最初の デバイス選択では配送されません。 最初の出力デバイスの準備状態を確認するには、statechangeイベントを使用できます。 onerror, 型は EventHandler-
AudioContextから配送されるEventのイベントハンドラーです。 このハンドラーのイベント 型はerrorであり、 ユーザーエージェントは 次の場合にこのイベントを配送できます:-
選択されたオーディオデバイスの初期化および有効化に失敗した場合。
-
AudioContextに関連付けられたオーディオ出力デバイスが、 コンテキストがrunningの間に切断された場合。 -
オペレーティングシステムがオーディオデバイスの故障を報告した場合。
-
playbackStats, 型は AudioPlaybackStats、読み取り専用-
この
AudioContextのAudioPlaybackStatsインスタンス。[[playback stats]]内部スロットの値を返します。
1.2.3. メソッド
close()-
AudioContextを閉じ、使用中のシステム リソースを解放します。これにより、AudioContextによって作成されたすべてのオブジェクトが自動的に解放されるわけではありませんが、AudioContextのcurrentTimeの進行を一時停止し、 オーディオデータの処理を停止します。close が呼び出されたとき、次の手順を実行します:-
this の関連するグローバルオブジェクトの関連付けられた Document が完全にアクティブでない場合、"
InvalidStateError"DOMExceptionで拒否された Promiseを返します。 -
promise を新しい Promise とします。
-
AudioContext上の[[control thread state]]フラグがclosedの場合、 Promise をInvalidStateErrorで拒否し、これらの手順を中止して promise を返します。 -
AudioContext上の[[control thread state]]フラグをclosedに設定します。 -
AudioContextを閉じるための制御メッセージをキューに入れます。 -
promise を返します。
AudioContextを閉じるための制御 メッセージを実行するとは、 レンダリング スレッド上で次の手順を実行することを意味します:-
システムリソースを 解放することを試みます。
-
[[rendering thread state]]をsuspendedに設定します。これによりレンダリングが停止します。 -
この制御メッセージが、 文書のアンロードに対する反応として実行されている場合、このアルゴリズムを中止します。
この場合、制御スレッドへ通知する必要はありません。 -
メディア要素タスクをキューに入れ、次の手順を実行します:
-
promise を解決します。
-
AudioContextのstate属性がまだ "closed" でない場合:-
AudioContextのstate属性を "closed" に設定します。 -
メディア要素タスクをキューに入れ、
statechangeという名前のイベントを 発火させ、AudioContextに配送します。
-
-
AudioContextが閉じられると、AudioContextに接続されていたMediaStreamおよびHTMLMediaElementの出力は無視されます。つまり、これらはスピーカーやその他の出力デバイスに 何も出力しなくなります。動作をより柔軟にするには、HTMLMediaElement.captureStream()の使用を検討してください。注:
AudioContextが閉じられた場合、実装は 一時停止時よりも積極的に多くのリソースを解放することを 選択できます。パラメーターなし。 -
createMediaElementSource(mediaElement)-
HTMLMediaElementを指定してMediaElementAudioSourceNodeを作成します。 このメソッドを呼び出した結果、HTMLMediaElementからのオーディオ再生は、AudioContextの処理グラフへ再ルーティングされます。AudioContext.createMediaElementSource() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 mediaElementHTMLMediaElement✘ ✘ 再ルーティングされるメディア要素。 戻り値の型:MediaElementAudioSourceNode createMediaStreamDestination()-
MediaStreamAudioDestinationNodeを作成します。パラメーターなし。 createMediaStreamSource(mediaStream)-
MediaStreamAudioSourceNodeを作成します。AudioContext.createMediaStreamSource() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 mediaStreamMediaStream✘ ✘ ソースとして機能するメディアストリーム。 戻り値の型:MediaStreamAudioSourceNode createMediaStreamTrackSource(mediaStreamTrack)-
MediaStreamTrackAudioSourceNodeを作成します。AudioContext.createMediaStreamTrackSource() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 mediaStreamTrackMediaStreamTrack✘ ✘ ソースとして機能する MediaStreamTrack。 そのkind属性の値は"audio"と等しくなければならず、そうでなければInvalidStateError例外を投げなければなりません。 getOutputTimestamp()-
コンテキストについて互いに関連する 2 つのオーディオストリーム位置の 値を含む、新しい
AudioTimestampインスタンスを返します。contextTimeメンバーには、 オーディオ出力デバイスによって現在レンダリングされている サンプルフレームの時刻(すなわち、出力オーディオストリームの 位置)が、コンテキストのcurrentTimeと同じ単位および原点で格納されます。performanceTimeメンバーには、 保存されたcontextTime値に対応するサンプルフレームが オーディオ出力デバイスによってレンダリングされた瞬間を推定する時刻が、performance.now()と同じ単位および 原点で格納されます( [hr-time-3] で説明されています)。コンテキストのレンダリンググラフがまだオーディオブロックを 処理していない場合、
getOutputTimestampの呼び出しは、 両方のメンバーが 0 であるAudioTimestampインスタンスを返します。コンテキストのレンダリンググラフがオーディオブロックの 処理を開始した後、その
currentTime属性値は、getOutputTimestampメソッド呼び出しから得られたcontextTimeの値を常に上回ります。getOutputTimestampメソッドから返される値を使用して、わずかに後の コンテキスト時刻値に対するパフォーマンス時刻の推定値を取得できます:function outputPerformanceTime( contextTime) { const timestamp= context. getOutputTimestamp(); const elapsedTime= contextTime- timestamp. contextTime; return timestamp. performanceTime+ elapsedTime* 1000 ; } 上の例では、推定の精度は 引数の値が現在の出力オーディオ ストリーム位置にどれだけ近いかによって決まります。指定された
contextTimeがtimestamp.contextTimeに近いほど、 得られる推定値の精度は高くなります。注: コンテキストの
currentTimeと、getOutputTimestampメソッド呼び出しから得られたcontextTimeの値の差は、 信頼できる出力レイテンシーの推定値とは見なせません。currentTimeは不均一な時間間隔で増加する可能性があるためです。その代わりに、outputLatency属性を使用するべきです。パラメーターなし。戻り値の型:AudioTimestamp resume()-
AudioContextが一時停止されている場合、そのcurrentTimeの進行を再開します。resume が呼び出されたとき、 次の手順を実行します:-
this の関連するグローバルオブジェクトの 関連付けられた Document が完全にアクティブでない場合、 "
InvalidStateError"DOMExceptionで拒否された Promiseを返します。 -
promise を新しい Promise とします。
-
AudioContext上の[[control thread state]]がclosedの場合、 Promise をInvalidStateErrorで拒否し、これらの手順を中止して promise を返します。 -
[[suspended by user]]をfalseに設定します。 -
コンテキストの
state属性が "suspended" で、コンテキストの[[control thread state]]が "interrupted" の場合:-
メディア要素タスクをキューに入れ、 次の手順を実行します:
-
AudioContextのstate属性を "interrupted" に設定します。 -
[[state before interruption]]スロットを "running" に設定します。 -
メディア要素 タスクをキューに入れ、
statechangeという名前のイベントを発火させ、AudioContextに配送します。
-
-
Promise を
InvalidStateErrorで拒否し、これらの 手順を中止して promise を返します。
-
-
コンテキストが開始を許可されていない場合、 promise を
[[pending promises]]および[[pending resume promises]]に追加し、 これらの手順を中止して promise を返します。 -
AudioContext上の[[control thread state]]をrunningに設定します。 -
promise とともに
AudioContextを再開するための制御メッセージをキューに入れます。 -
promise を返します。
AudioContextを再開するための制御 メッセージを実行するとは、 レンダリング スレッド上で次の手順を実行することを意味します:-
promise を、このアルゴリズムに渡された Promise とします。
-
システムリソースを取得することを試みます。
-
AudioContext上の[[rendering thread state]]をrunningに設定します。 -
オーディオグラフのレンダリングを開始します。
-
失敗した場合、 メディア要素タスクをキューに入れ、次の手順を実行します:
-
[[pending resume promises]]のすべての Promise を順番に拒否し、その後[[pending resume promises]]をクリアします。 -
さらに、それらの Promise を
[[pending promises]]から削除します。
-
-
メディア要素タスクをキューに入れ、次の手順を実行します:
-
AudioContextの[[render quantum size]]が 0 の場合、 リソース取得中に選択された実際のハードウェアレンダー量子サイズに 設定します。 -
[[pending resume promises]]のすべての Promise を順番に解決します。 -
[[pending resume promises]]をクリアします。 さらに、それらの Promise を[[pending promises]]から削除します。 -
promise を解決します。
-
AudioContextのstate属性がまだ "running" でない場合:-
AudioContextのstate属性を "running" に設定します。 -
メディア要素 タスクをキューに入れ、
statechangeという名前のイベントを発火させ、AudioContextに配送します。
-
-
パラメーターなし。 -
suspend()-
AudioContextのcurrentTimeの進行を一時停止し、 すでに処理済みの現在のコンテキスト処理ブロックを デスティネーションで再生できるようにして、その後システムが オーディオハードウェアへの占有を解放できるようにします。これは通常、 アプリケーションがしばらくAudioContextを必要としないことが分かっており、AudioContextに関連付けられたシステムリソースを一時的に解放 したい場合に有用です。 Promise は、フレームバッファーが空になったとき (ハードウェアへ渡されたとき)に解決されます。コンテキストがすでにsuspendedの場合は、即座に (その他の効果なしで)解決されます。コンテキストが閉じられている場合、 Promise は拒否されます。suspend が呼び出されたとき、次の手順を実行します:-
this の関連するグローバルオブジェクトの関連付けられた Document が完全にアクティブでない場合、"
InvalidStateError"DOMExceptionで拒否された Promiseを返します。 -
promise を新しい Promise とします。
-
AudioContext上の[[control thread state]]がclosedの場合、Promise をInvalidStateErrorで拒否し、これらの手順を中止して promise を返します。 -
promise を
[[pending promises]]に追加します。 -
[[suspended by user]]をtrueに設定します。 -
AudioContext上の[[control thread state]]をsuspendedに設定します。 -
promise とともに
AudioContextを一時停止するための制御メッセージをキューに入れます。 -
promise を返します。
AudioContextを一時停止するための制御 メッセージを実行するとは、 レンダリング スレッド上で次の手順を実行することを意味します:-
promise を、このアルゴリズムに渡された Promise とします。
-
システムリソースを 解放することを試みます。
-
AudioContext上の[[rendering thread state]]が "interrupted" の場合、メディア要素 タスクをキューに入れ、[[state before interruption]]スロットを "suspended" に設定します。 -
AudioContext上の[[rendering thread state]]を "suspended" に設定します。 -
メディア要素タスクをキューに入れ、 次の手順を実行します:
-
promise を解決します。
-
AudioContextのstate属性がまだ "suspended" でない場合:-
AudioContextのstate属性を "suspended" に設定します。 -
メディア要素 タスクをキューに入れ、
statechangeという名前のイベントを発火させ、AudioContextに配送します。
-
-
AudioContextが一時停止されている間、MediaStreamの出力は無視されます。つまり、 メディアストリームのリアルタイム性によりデータは失われます。HTMLMediaElementも同様に、システムが再開されるまで出力が 無視されます。AudioWorkletNodeおよびScriptProcessorNodeは、一時停止中は 処理ハンドラーが呼び出されなくなりますが、 コンテキストが再開されると再開します。AnalyserNodeのウィンドウ関数に関しては、データは 連続したストリームとして扱われます。つまり、resume()/suspend()によってAnalyserNodeのデータストリームに無音が現れることはありません。 特に、AudioContextが一時停止されているときにAnalyserNode関数を繰り返し呼び出す場合、 同じデータを返さなければなりません。パラメーターなし。 -
setSinkId((DOMString or AudioSinkOptions) sinkId)-
出力デバイスの識別子を設定します。このメソッドが呼び出されたとき、 ユーザーエージェントは次の手順を実行しなければなりません:
-
sinkId をメソッドの第 1 引数とします。
-
sinkId が
[[sink ID]]と等しい場合、Promise を返し、 直ちに解決してこれらの手順を中止します。 -
validationResult を、 sinkId の シンク識別子の検証 の戻り値とします。
-
validationResult が
falseの場合、 名前が "NotAllowedError" である新しいDOMExceptionで拒否された Promise を返します。 これらの手順を中止します。 -
p を新しい Promise とします。
-
p および sinkId とともに、処理を開始するための 制御メッセージを送信します。
-
p を返します。
setSinkId()中に処理を開始するための制御 メッセージを送信するとは、 次の手順を実行することを意味します:-
p を、このアルゴリズムに渡された Promise とします。
-
sinkId を、このアルゴリズムに渡されたシンク識別子とします。
-
sinkId と
[[sink ID]]の両方がDOMString型で、 かつ互いに等しい場合、 メディア要素タスクをキューに入れて p を解決し、これらの手順を中止します。 -
sinkId が
AudioSinkOptions型で、[[sink ID]]がAudioSinkInfo型であり、 sinkId 内のtypeと[[sink ID]]内のtypeが等しい場合、 メディア要素タスクをキューに入れて p を解決し、これらの手順を中止します。 -
wasRunning を true とします。
-
AudioContext上の[[rendering thread state]]が"suspended"の場合、 wasRunning を false に設定します。 -
現在のレンダー量子の処理後にレンダラーを一時停止します。
-
システム リソースを解放することを試みます。
-
wasRunning が true の場合:
-
AudioContext上の[[rendering thread state]]を"suspended"に設定します。 -
メディア要素タスクをキューに入れ、次の手順を実行します:
-
AudioContextのstate属性がまだ "suspended" でない場合:-
AudioContextのstate属性を "suspended" に設定します。 -
statechangeという名前のイベントを発火させ、 関連付けられたAudioContextに配送します。
-
-
-
-
レンダリングに使用する次のオーディオ出力デバイス用の システムリソースを取得することを、
[[sink ID]]に基づいて試みます:-
空文字列の場合は既定のオーディオ出力デバイス。
-
[[sink ID]]によって識別されるオーディオ出力デバイス。
失敗した場合、p を "
InvalidAccessError" で拒否し、 以降の手順を中止します。 -
-
メディア要素タスクをキューに入れ、次の手順を実行します:
-
sinkId が
DOMString型の場合、[[sink ID]]を sinkId に設定します。これらの手順を中止します。 -
sinkId が
AudioSinkOptions型で、[[sink ID]]がDOMString型の場合、[[sink ID]]を、sinkId のtypeの値で作成された新しいAudioSinkInfoインスタンスに設定します。 -
sinkId が
AudioSinkOptions型で、[[sink ID]]がAudioSinkInfo型の場合、[[sink ID]]のtypeを、 sinkId のtypeの値に設定します。 -
p を解決します。
-
sinkchangeという名前のイベントを発火させ、 関連付けられたAudioContextに配送します。
-
-
wasRunning が true の場合:
-
AudioContext上の[[rendering thread state]]を"running"に設定します。 -
メディア要素タスクをキューに入れ、次の手順を実行します:
-
AudioContextのstate属性がまだ "running" でない場合:-
AudioContextのstate属性を "running" に設定します。 -
statechangeという名前のイベントを発火させ、 関連付けられたAudioContextに配送します。
-
-
-
-
1.2.4.
sinkId
の検証
このアルゴリズムは、sinkId
を変更するために提供された情報を検証するために使用されます:
-
document を、現在の設定オブジェクトの関連付けられた Document とします。
-
sinkIdArg を、このアルゴリズムに渡された値とします。
-
document が
"speaker-selection"で識別される機能を使用することを許可されていない場合、falseを返します。 -
sinkIdArg が
DOMString型でありながら、空文字列と等しくない、またはenumerateDevices()によって提供される結果で識別されるどのオーディオ出力デバイスにも一致しない場合、falseを返します。 -
trueを返します。
1.2.5.
AudioContextOptions
AudioContextOptions
辞書は、AudioContext
のユーザー指定オプションを指定するために使用されます。
dictionary AudioContextOptions { (AudioContextLatencyCategory or double )latencyHint = "interactive";float sampleRate ; (DOMString or AudioSinkOptions )sinkId ; (AudioContextRenderSizeCategory or unsigned long )renderSizeHint = "default"; };
1.2.5.1.
AudioContextOptions
辞書のメンバー
latencyHint, 型は(AudioContextLatencyCategory or double)、既定値は"interactive"-
再生の種類を識別します。これは、 オーディオ出力レイテンシーと消費電力のトレードオフに影響します。
latencyHintの推奨値は、AudioContextLatencyCategoryの値です。 ただし、レイテンシーと消費電力のバランスを より細かく制御するため、レイテンシーの秒数を double で指定することもできます。その数値を適切に解釈するかどうかは ブラウザーの裁量に委ねられます。実際に使用されるレイテンシーは、 AudioContext のbaseLatency属性で示されます。 sampleRate, 型は float-
作成される
AudioContextのsampleRateをこの値に設定します。 必要なサポート範囲については、 § 2.4 サポートされるサンプルレートを参照してください。sampleRateが指定されていない場合、このAudioContextの出力デバイスで推奨されるサンプルレートが使用されます。 sinkId, 型は(DOMString or AudioSinkOptions)-
オーディオ出力デバイスの識別子または関連情報。 詳細については
sinkIdを参照してください。 renderSizeHint, 型は(AudioContextRenderSizeCategory or unsigned long)、既定値は"default"-
整数が渡された場合は特定のレンダー量子サイズを要求できます。 何も渡されない場合または
"default"が渡された場合は既定の 128 フレームを使用し、"hardware"が指定された場合はユーザーエージェントに適切な レンダー量子 サイズを選択するよう要求します。必要なサポート範囲については、§ 2.5 サポートされるレンダー量子サイズを参照してください。
これはヒントであり、尊重されない可能性があります。
1.2.6.
AudioSinkOptions
AudioSinkOptions
辞書は、
sinkId
のオプションを指定するために使用されます。
dictionary AudioSinkOptions {required AudioSinkType type ; };
1.2.6.1.
AudioSinkOptions
辞書のメンバー
type, 型は AudioSinkType-
デバイスの種類を指定するための
AudioSinkTypeの値。
1.2.7.
AudioSinkInfo
AudioSinkInfo
インターフェイスは、sinkId
を介して現在の
オーディオ出力デバイスに関する情報を取得するために使用されます。
[Exposed =Window ]interface AudioSinkInfo {readonly attribute AudioSinkType type ; };
1.2.7.1. 属性
type, 型は AudioSinkType、読み取り専用-
デバイスの種類を表す
AudioSinkTypeの値。
1.2.8.
AudioTimestamp
dictionary AudioTimestamp {double contextTime ;DOMHighResTimeStamp performanceTime ; };
1.2.8.1.
AudioTimestamp
辞書のメンバー
contextTime, 型は double-
BaseAudioContext の
currentTimeの時間座標系における一点を表します。 performanceTime, 型は DOMHighResTimeStamp-
Performanceインターフェイス実装の時間座標系における 一点を表します( [hr-time-3] で説明されています)。
1.3.
OfflineAudioContext
インターフェイス
OfflineAudioContext
は、(場合によっては)リアルタイムより高速に
レンダリング/ミックスダウンするための特殊な種類の
BaseAudioContext
です。オーディオ
ハードウェアへレンダリングするのではなく、可能な限り高速にレンダリングし、
レンダリング結果を AudioBuffer
として返された Promise を解決します。
[Exposed =Window ]interface OfflineAudioContext :BaseAudioContext {constructor (OfflineAudioContextOptions contextOptions );constructor (unsigned long numberOfChannels ,unsigned long length ,float sampleRate );Promise <AudioBuffer >startRendering (optional unsigned long ?chunkSize =null );Promise <undefined >resume ();Promise <undefined >suspend (double );suspendTime Promise <undefined >close ();readonly attribute unsigned long ?length ;attribute EventHandler oncomplete ; };
OfflineAudioContext
は次の内部スロットを持ちます:
[[rendering started]]-
レンダリングが開始されたかどうかを表すブーリアンフラグ。初期値は
falseです。 [[rendered buffers]]-
レンダリング中の
AudioBufferの順序付きリスト。初期値は 空のリストです。 [[committed frames]]-
OfflineAudioContextがレンダリングすることを確定した フレーム数を追跡します。初期値は0です。 [[rendered frames]]-
レンダリング済みのフレーム数を追跡します。初期値は
0です。
1.3.1. コンストラクター
OfflineAudioContext(contextOptions)-
現在の設定オブジェクトの関連するグローバルオブジェクトの 関連付けられた Document が完全にアクティブでない場合、
c を新しいInvalidStateErrorを投げて、これらの手順を中止します。OfflineAudioContextオブジェクトとします。 c を次のように初期化します:-
c の
[[control thread state]]を"suspended"に設定します。 -
c の
[[rendering thread state]]を"suspended"に設定します。 -
c の
sampleRateを、contextOptions.の値に基づいて設定します。sampleRate -
c の
[[render quantum size]]を、contextOptions.の値に基づいて決定します:renderSizeHint-
既定値
"default"または"hardware" の場合、[[render quantum size]]プライベート スロットを 128 に設定します。 -
それ以外で、整数が渡された場合、その値が § 2.5 サポートされるレンダー量子サイズ で指定された範囲外なら、
NotSupportedErrorを投げなければなりません。 それ以外の場合、[[render quantum size]]プライベートスロットを渡された値に設定します。
-
-
channelCountをcontextOptions.numberOfChannelsに設定したAudioDestinationNodeを構築します。 -
messageChannel を新しい
MessageChannelとします。 -
controlSidePort を messageChannel の
port1属性の値とします。 -
renderingSidePort を messageChannel の
port2属性の値とします。 -
serializedRenderingSidePort を StructuredSerializeWithTransfer(renderingSidePort, « renderingSidePort ») の結果とします。
-
この
audioWorkletのportを controlSidePort に設定します。 -
serializedRenderingSidePort とともに、 AudioContextGlobalScope 上の MessagePort を設定するための制御メッセージをキューに入れます。
OfflineAudioContext.constructor(contextOptions) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextOptionsこのコンテキストを構築するために必要な初期パラメーター。 -
OfflineAudioContext(numberOfChannels, length, sampleRate)-
OfflineAudioContextは AudioContext.createBuffer と同じ引数で 構築できます。いずれかの引数が 負、0、または規定の範囲外の場合、NotSupportedError例外を投げなければなりません。OfflineAudioContext は、代わりに
new OfflineAudioContext({ numberOfChannels: numberOfChannels, length: length, sampleRate: sampleRate}) が呼び出されたかのように構築されます。
OfflineAudioContext.constructor(numberOfChannels, length, sampleRate) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 numberOfChannelsunsigned long✘ ✘ バッファーが持つチャンネル数を決定します。サポートされるチャンネル数については createBuffer()を参照してください。lengthunsigned long✘ ✘ オーディオレンダリングの合計サイズをサンプルフレーム単位で決定します。 sampleRatefloat✘ ✘ バッファー内のリニア PCM オーディオデータのサンプルレートを、 1 秒あたりのサンプルフレーム数で記述します。必要なサポート範囲については § 2.4 サポートされるサンプルレートを参照してください。
1.3.2. 属性
length, 型は unsigned long、読み取り専用、null 許容-
オーディオレンダリングの合計サイズ(サンプルフレーム単位)。これは コンストラクターの
lengthパラメーターの値と同じです。長さが未定義のレンダリングでは、この属性を
nullに設定するべきです。 oncomplete, 型は EventHandler-
このイベントハンドラーのイベント型は
completeです。イベント ハンドラーへ配送されるイベントはOfflineAudioCompletionEventインターフェイスを使用します。これはOfflineAudioContextで最後に発火するイベントです。
1.3.3. メソッド
startRendering(chunkSize)-
現在の接続とスケジュールされた変更に基づいて、 オーディオのレンダリングを開始します。
レンダリングされたオーディオデータを取得する主な方法は Promise の戻り値を介するものですが、レガシー上の理由からインスタンスは
completeという名前のイベントも発火します。startRenderingが 呼び出されたとき、次の手順を制御 スレッド上で実行しなければなりません:- this の関連するグローバルオブジェクトの関連付けられた Document が完全にアクティブでない場合、"
InvalidStateError"DOMExceptionで拒否された Promiseを返します。 - promise を新しい Promise とします。
-
OfflineAudioContext上の[[control thread state]]がclosedの場合、 promise をInvalidStateErrorで拒否し、これらの 手順を中止します。 -
OfflineAudioContextのlengthがnullでなく、[[committed frames]]がOfflineAudioContextのlength以上の場合、 promise をInvalidStateErrorで拒否し、これらの 手順を中止します。 -
bufferLength を、
chunkSizeの値で初期化された数値とします。-
OfflineAudioContextのlengthがnullの場合: -
それ以外で、
OfflineAudioContextのlengthがnullでない場合:-
chunkSizeがnullでなく、[[committed frames]]+chunkSizeがOfflineAudioContextのlength未満の場合、bufferLength をchunkSizeに設定します。 - それ以外の場合、bufferLength を
length-[[committed frames]]に設定します。
-
-
- bufferLength が レンダー 量子サイズの倍数でない場合、次の レンダー量子サイズの倍数まで切り上げます。
- 新しい
AudioBufferbuffer を作成します。チャンネル数と サンプルレートは、このインスタンスのコンストラクターへcontextOptionsパラメーターで渡されたnumberOfChannelsおよびsampleRateの値とそれぞれ等しくし、 長さは bufferLength と等しくします。 - 直前の
AudioBufferコンストラクター呼び出し中に例外が投げられた場合、 promise をこの例外で拒否し、promise を返します。 [[rendering started]]を true に設定します。[[committed frames]]を、[[committed frames]]と buffer のlengthの合計に設定します。- buffer を
[[rendered buffers]]に追加し、buffer の オフラインレンダリングを開始します。 - promise を
[[pending promises]]に追加します。 - promise を返します。
AudioBufferbuffer のオフラインレンダリングを開始するには、 そのために作成されたレンダリング スレッド上で次の手順を実行しなければなりません。- 現在の接続とスケジュールされた変更に基づいて、
buffer の
lengthサンプルフレーム分のオーディオを buffer に レンダリングし始めます。 - 各レンダー
量子について確認し、必要なら
レンダリングを
suspendします。 - 一時停止されたコンテキストが再開された場合、 バッファーのレンダリングを続行します。
-
レンダリングが完了したら、
メディア要素タスクをキューに入れ、次の手順を実行します:
startRendering()によって作成された promise を buffer で解決します。- promise を
[[pending promises]]から削除します。 - buffer を
[[rendered buffers]]から削除します。 [[rendered frames]]を、[[rendered frames]]と buffer のlengthの合計に設定します。-
lengthがnullでない場合:-
[[rendered frames]]がlength以上の場合、OfflineAudioContextを閉じるための制御メッセージを キューに入れます。 - メディア要素タスクをキューに入れ、
completeという名前のイベントを発火させ、renderedBufferプロパティが buffer に設定されたOfflineAudioCompletionEventを使用してOfflineAudioContextに配送します。
-
OfflineAudioContext.startRendering(chunkSize) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 chunkSizeunsigned long?✔ ✔ この呼び出し中にレンダリングするサンプルフレーム数。 戻り値の型:Promise<AudioBuffer> - this の関連するグローバルオブジェクトの関連付けられた Document が完全にアクティブでない場合、"
resume()-
OfflineAudioContextが一時停止されている場合、そのcurrentTimeの進行を再開します。resume が呼び出されたとき、 次の手順を実行します:-
this の関連するグローバルオブジェクトの関連付けられた Document が完全にアクティブでない場合、 "
InvalidStateError"DOMExceptionで拒否された Promiseを返します。 -
promise を新しい Promise とします。
-
次のいずれかの条件が true の場合、これらの手順を中止し、 promise を
InvalidStateErrorで拒否します:-
OfflineAudioContext上の[[control thread state]]がclosedである。 -
OfflineAudioContext上の[[rendering started]]スロットが false である。
-
-
OfflineAudioContext上の[[control thread state]]フラグをrunningに設定します。 -
OfflineAudioContextを再開するための制御メッセージをキューに入れます。 -
promise を返します。
OfflineAudioContextを再開するための制御 メッセージを実行するとは、 レンダリング スレッド上で次の手順を実行することを意味します:-
OfflineAudioContext上の[[rendering thread state]]をrunningに設定します。 -
オーディオグラフのレンダリングを開始します。
-
失敗した場合、 メディア要素タスクをキューに入れて promise を拒否し、残りの 手順を中止します。
-
メディア要素タスクをキューに入れ、次の手順を実行します:
-
promise を解決します。
-
OfflineAudioContextのstate属性がまだ "running" でない場合:-
OfflineAudioContextのstate属性を "running" に設定します。 -
メディア要素 タスクをキューに入れ、
statechangeという名前のイベントを発火させ、OfflineAudioContextに配送します。
-
-
パラメーターなし。 -
suspend(suspendTime)-
指定された時刻にオーディオ コンテキストの時間進行を一時停止するようスケジュールし、Promise を返します。これは通常、
OfflineAudioContext上でオーディオグラフを同期的に操作するときに有用です。一時停止の最大精度は レンダー量子 のサイズであり、指定された一時停止時刻は 最も近い次のレンダー量子 境界まで切り上げられることに注意してください。このため、 同じ量子化フレームに複数の一時停止をスケジュールすることは 許可されません。また、正確な一時停止を保証するため、 コンテキストが実行中でないときにスケジュールするべきです。
OfflineAudioContext.suspend() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 suspendTimedouble✘ ✘ 指定された時刻にレンダリングを一時停止するようスケジュールします。この時刻は量子化され、 レンダー量子サイズまで切り上げられます。量子化されたフレーム番号が - 負である、または
- 現在時刻以下である、または
- レンダリングの合計時間以上である、または
- 同じ時刻に別の suspend によってスケジュールされている、
InvalidStateErrorで拒否されます。 close()-
OfflineAudioContextを閉じます。 これにより、AudioContextによって作成されたすべての オブジェクトが自動的に解放されるわけではありませんが、AudioContextのcurrentTimeの進行を一時停止し、 オーディオデータの処理を停止します。close が呼び出されたとき、次の手順を実行します:-
this の関連するグローバルオブジェクトの 関連付けられた Document が完全にアクティブでない場合、 "
InvalidStateError"DOMExceptionで拒否された Promiseを返します。 -
promise を新しい Promise とします。
-
OfflineAudioContext上の[[control thread state]]フラグがclosedの場合、 Promise をInvalidStateErrorで拒否し、これらの手順を中止して promise を返します。 -
OfflineAudioContext上の[[control thread state]]フラグをclosedに設定します。 -
OfflineAudioContextを閉じるための制御メッセージをキューに入れます。 -
promise を返します。
OfflineAudioContextを閉じるための制御 メッセージを実行するとは、レンダリングスレッド上で次の手順を実行することを意味します:-
[[rendering thread state]]をsuspendedに設定します。これによりレンダリングが停止します。 -
この制御メッセージが、 文書のアンロードに対する反応として実行されている場合、このアルゴリズムを中止します。
この場合、制御スレッドへ通知する必要はありません。 -
メディア要素タスクをキューに入れ、次の手順を実行します:
-
promise を解決します。
-
OfflineAudioContextのstate属性がまだ "closed" でない場合:-
OfflineAudioContextのstate属性を "closed" に設定します。
-
メディア要素タスクをキューに入れ、
statechangeという名前のイベントを発火させ、OfflineAudioContextに配送します。
-
-
-
1.3.4.
OfflineAudioContextOptions
これは、OfflineAudioContext
を構築するときに使用するオプションを指定します。
dictionary OfflineAudioContextOptions {unsigned long numberOfChannels = 1;unsigned long ?length =null ;required float sampleRate ; (AudioContextRenderSizeCategory or unsigned long )renderSizeHint = "default"; };
1.3.4.1.
OfflineAudioContextOptions
辞書のメンバー
length, 型は unsigned long、null 許容、既定値はnull-
レンダリングされた
AudioBufferの長さ(サンプルフレーム単位)。 numberOfChannels, 型は unsigned long、既定値は1-
この
OfflineAudioContextのチャンネル数。 sampleRate, 型は float-
この
OfflineAudioContextのサンプルレート。 必要なサポート範囲については § 2.4 サポートされるサンプルレートを参照してください。 renderSizeHint, 型は(AudioContextRenderSizeCategory or unsigned long)、既定値は"default"-
この
OfflineAudioContextのレンダー量子サイズのヒント。 必要なサポート範囲については§ 2.5 サポートされるレンダー量子サイズ を参照してください。
1.3.5.
OfflineAudioCompletionEvent
インターフェイス
これは、レガシー上の理由から
OfflineAudioContext
へ配送される Event
オブジェクトです。
[Exposed =Window ]interface OfflineAudioCompletionEvent :Event {(constructor DOMString ,type OfflineAudioCompletionEventInit );eventInitDict readonly attribute AudioBuffer renderedBuffer ; };
1.3.5.1. 属性
renderedBuffer, 型は AudioBuffer、 読み取り専用-
レンダリングされたオーディオデータを含む
AudioBuffer。
1.3.5.2.
OfflineAudioCompletionEventInit
dictionary OfflineAudioCompletionEventInit :EventInit {required AudioBuffer renderedBuffer ; };
1.3.5.2.1.
OfflineAudioCompletionEventInit
辞書のメンバー
renderedBuffer, 型は AudioBuffer-
イベントの
renderedBuffer属性へ割り当てる値。
1.4.
AudioBuffer
インターフェイス
このインターフェイスは、メモリー上に存在するオーディオ資産を表します。1 つ以上の
チャンネルを含むことができ、各チャンネルは公称範囲
\([-1,1]\) の 32 ビット浮動小数点
リニア PCM 値として扱われますが、
値はこの範囲に制限されません。通常、
PCM データの長さはかなり短い
(通常は 1 分より多少短い)ことが想定されます。
音楽のサウンドトラックなど、より長い音声には、
audio
要素および
MediaElementAudioSourceNode
を使用したストリーミングを使用するべきです。
AudioBuffer
は 1 つ以上の
AudioContext
で使用でき、
OfflineAudioContext
と
AudioContext
の間で共有できます。
AudioBuffer
は 4 つの内部スロットを持ちます:
[[number of channels]]-
この
AudioBufferのオーディオチャンネル数。unsigned long です。 [[length]]-
この
AudioBufferの各チャンネルの長さ。unsigned long です。 [[sample rate]]-
この
AudioBufferのサンプルレート(Hz)。float です。 [[internal data]]-
オーディオサンプルデータを保持するデータブロック。
[Exposed =Window ]interface AudioBuffer {constructor (AudioBufferOptions );options readonly attribute float sampleRate ;readonly attribute unsigned long length ;readonly attribute double duration ;readonly attribute unsigned long numberOfChannels ;Float32Array getChannelData (unsigned long );channel undefined copyFromChannel (Float32Array ,destination unsigned long ,channelNumber optional unsigned long = 0);bufferOffset undefined copyToChannel (Float32Array ,source unsigned long ,channelNumber optional unsigned long = 0); };bufferOffset
1.4.1. コンストラクター
AudioBuffer(options)-
-
options内のいずれかの値が規定の範囲外の場合、NotSupportedError例外を投げ、以降の手順を中止します。 -
b を新しい
AudioBufferオブジェクトとします。 -
コンストラクターに渡された
AudioBufferOptionsの属性numberOfChannels、length、sampleRateの値を、それぞれ内部スロット[[number of channels]]、[[length]]、[[sample rate]]に割り当てます。 -
この
AudioBufferの内部スロット[[internal data]]を、CreateByteDataBlock(を呼び出した結果に設定します。[[length]]*[[number of channels]])注: これにより、 基盤となるストレージが 0 で初期化されます。
-
b を返します。
AudioBuffer.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 optionsAudioBufferOptions✘ ✘ この AudioBufferのプロパティを決定するAudioBufferOptions。 -
1.4.2. 属性
duration, 型は double、読み取り専用-
PCM オーディオデータの継続時間(秒)。
これは、
AudioBufferの[[length]]を[[sample rate]]で除算することにより、[[sample rate]]と[[length]]から計算されます。 length, 型は unsigned long、読み取り専用-
PCM オーディオデータの長さ(サンプルフレーム単位)。これは
[[length]]の値を返さなければなりません。 numberOfChannels, 型は unsigned long、読み取り専用-
独立したオーディオチャンネルの数。これは
[[number of channels]]の値を返さなければなりません。 sampleRate, 型は float、読み取り専用-
PCM オーディオデータの 1 秒あたりのサンプル数で表したサンプルレート。 これは
[[sample rate]]の値を返さなければなりません。
1.4.3. メソッド
copyFromChannel(destination, channelNumber, bufferOffset)-
copyFromChannel()メソッドは、AudioBufferの指定されたチャンネルからサンプルをdestination配列へコピーします。bufferを \(N_b\) フレームを持つAudioBufferとし、\(N_f\) をdestination配列内の要素数とし、\(k\) をbufferOffsetの値とします。 このとき、bufferからdestinationへコピーされるフレーム数は \(\max(0, \min(N_b - k, N_f))\) です。これが \(N_f\) 未満の場合、destinationの残りの要素は 変更されません。AudioBuffer.copyFromChannel() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationFloat32Array✘ ✘ チャンネルデータのコピー先となる配列。 channelNumberunsigned long✘ ✘ データをコピーする元となるチャンネルのインデックス。 channelNumberがAudioBufferのチャンネル数以上の場合、IndexSizeErrorを投げなければなりません。bufferOffsetunsigned long✘ ✔ 省略可能なオフセットで、既定値は 0 です。 AudioBufferのこのオフセットから始まるデータがdestinationにコピーされます。戻り値の型:undefined copyToChannel(source, channelNumber, bufferOffset)-
copyToChannel()メソッドは、source配列からAudioBufferの指定されたチャンネルへサンプルをコピーします。sourceをバッファーへコピーできない場合、UnknownErrorが投げられる場合があります。bufferを \(N_b\) フレームを持つAudioBufferとし、\(N_f\) をsource配列内の要素数とし、\(k\) をbufferOffsetの値とします。 このとき、sourceからbufferへコピーされるフレーム数は \(\max(0, \min(N_b - k, N_f))\) です。これが \(N_f\) 未満の場合、bufferの残りの要素は 変更されません。AudioBuffer.copyToChannel() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 sourceFloat32Array✘ ✘ チャンネルデータのコピー元となる配列。 channelNumberunsigned long✘ ✘ データのコピー先となるチャンネルのインデックス。 channelNumberがAudioBufferのチャンネル数以上の場合、IndexSizeErrorを投げなければなりません。bufferOffsetunsigned long✘ ✔ 省略可能なオフセットで、既定値は 0 です。 sourceのデータが、このオフセットから始まるAudioBufferにコピーされます。戻り値の型:undefined getChannelData(channel)-
内容を取得するで説明されている規則に従って、 新しい
Float32Array内で、[[internal data]]に格納されているバイトへの書き込みを許可するか、 またはそのバイトのコピーを取得します。[[internal data]]または新しいFloat32Arrayを作成できない場合、UnknownErrorが投げられる場合があります。AudioBuffer.getChannelData() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 channelunsigned long✘ ✘ このパラメーターは、データを取得する特定のチャンネルを表すインデックスです。インデックス 値 0 は最初のチャンネルを表します。このインデックス値は [[number of channels]]未満でなければならず、そうでなければIndexSizeError例外を投げなければなりません。戻り値の型:Float32Array
注: copyToChannel()
および
copyFromChannel()
メソッドは、より大きな
配列へのビューである Float32Array
を渡すことで、配列の一部を埋めるために使用できます。
AudioBuffer
のチャンネルからデータを読み取り、
データをチャンク単位で処理できる場合、不要な
メモリー割り当てやコピーを回避できる可能性があるため、getChannelData()
を呼び出して結果の配列へアクセスするより、
copyFromChannel()
を優先するべきです。
ある API
実装が AudioBuffer
の内容を必要とするとき、内部操作
AudioBuffer の
内容を取得するが呼び出されます。この操作は呼び出し元へ
不変のチャンネルデータを返します。
AudioBuffer
に対して内容を取得する
操作が行われるとき、次の手順を実行します:
-
AudioBufferのArrayBufferのいずれかが 切り離されている場合、trueを返し、 これらの手順を中止して、 長さ 0 のチャンネルデータバッファーを呼び出し元へ返します。 -
この
AudioBuffer上のgetChannelData()によって以前に返された配列のすべてのArrayBufferを切り離します。注:
AudioBufferはcreateBuffer()またはAudioBufferコンストラクターを介してのみ作成できるため、 これは例外を投げることができません。 -
それらの
ArrayBufferから基盤となる[[internal data]]を保持し、それらへの参照を 呼び出し元へ返します。 -
データのコピーを含む
ArrayBufferをAudioBufferに関連付け、次回のgetChannelData()呼び出しで返されるようにします。
AudioBuffer の 内容を取得する操作は、次の場合に呼び出されます:
-
AudioBufferSourceNode.startが呼び出されると、 ノードのbufferの内容を取得します。 操作が失敗した場合、何も 再生されません。 -
AudioBufferSourceNodeのbufferが設定され、AudioBufferSourceNode.startが以前に呼び出されている場合、セッターはAudioBufferの内容を 取得します。 操作が失敗した場合、 何も再生されません。 -
ConvolverNodeのbufferがAudioBufferに設定されると、そのAudioBufferの内容を取得します。 -
AudioProcessingEventの配送が完了すると、そのoutputBufferの内容を取得します。
注: これは、copyToChannel()
を使用して、
AudioBuffer の
内容を取得した
AudioNode
が現在使用している AudioBuffer
の内容を変更することはできないことを意味します。
AudioNode は
以前に取得したデータを引き続き
使用するためです。
1.4.4.
AudioBufferOptions
これは、AudioBuffer
を構築するときに使用するオプションを指定します。
length
および sampleRate
メンバーは
必須です。
dictionary AudioBufferOptions {unsigned long numberOfChannels = 1;required unsigned long length ;required float sampleRate ; };
1.4.4.1.
AudioBufferOptions
辞書のメンバー
この辞書のメンバーに許可される値には制約があります。createBuffer()
を参照してください。
length, 型は unsigned long-
バッファーの長さ(サンプルフレーム単位)。制約については
lengthを参照してください。 numberOfChannels, 型は unsigned long、既定値は1-
バッファーのチャンネル数。制約については
numberOfChannelsを参照してください。 sampleRate, 型は float-
バッファーのサンプルレート(Hz)。必要なサポート範囲については § 2.4 サポートされるサンプルレートを参照してください。
1.5.
AudioNode
インターフェイス
AudioNode
は AudioContext
の構成要素です。このインターフェイスは、
オーディオソース、オーディオデスティネーション、および中間
処理モジュールを表します。これらのモジュールを相互に接続して、
オーディオハードウェアへオーディオをレンダリングするための
処理グラフを形成できます。
各ノードは入力および/または
出力を持つことができます。
ソースノードは入力を持たず、1 つの
出力を持ちます。フィルターなどのほとんどの処理ノードは 1 つの入力と
1 つの出力を持ちます。各種類の AudioNode
は、オーディオをどのように処理または合成するかという
詳細が異なります。しかし一般に、
AudioNode
は入力(存在する場合)を処理し、
出力(存在する場合)のためのオーディオを生成します。
各出力は 1 つ以上のチャンネルを持ちます。正確なチャンネル数は、
特定の AudioNode
の詳細によって異なります。
1 つの出力は 1 つ以上の AudioNode
の入力へ接続できるため、ファンアウトがサポートされます。入力は最初は
接続を持ちませんが、1 つ以上の AudioNode
の出力から接続できるため、ファンインがサポートされます。
connect() メソッドが呼び出され、ある
AudioNode
の出力が別の AudioNode
の入力へ接続された場合、それをその入力への
接続と呼びます。
各 AudioNode
の入力は、任意の時点で特定の
チャンネル数を持ちます。この数は、入力に対して行われた
接続によって変化する可能性があります。
入力に接続がない場合、無音の 1 チャンネルを持ちます。
各入力について、
AudioNode
はその入力へのすべての接続を
ミキシングします。
規範的要件と詳細については、§ 4 チャンネルのアップミックスとダウンミックス
を参照してください。
AudioContext
の時間に対して、AudioNode
の入力処理と内部操作は、
ノードに接続された出力があるかどうか、
またそれらの出力が最終的に
AudioContext
の
AudioDestinationNode
に到達するかどうかにかかわらず、継続的に行われます。
[Exposed =Window ]interface AudioNode :EventTarget {AudioNode connect (AudioNode destinationNode ,optional unsigned long output = 0,optional unsigned long input = 0);undefined connect (AudioParam destinationParam ,optional unsigned long output = 0);undefined disconnect ();undefined disconnect (unsigned long output );undefined disconnect (AudioNode destinationNode );undefined disconnect (AudioNode destinationNode ,unsigned long output );undefined disconnect (AudioNode destinationNode ,unsigned long output ,unsigned long input );undefined disconnect (AudioParam destinationParam );undefined disconnect (AudioParam destinationParam ,unsigned long output );readonly attribute BaseAudioContext context ;readonly attribute unsigned long numberOfInputs ;readonly attribute unsigned long numberOfOutputs ;attribute unsigned long channelCount ;attribute ChannelCountMode channelCountMode ;attribute ChannelInterpretation channelInterpretation ; };
1.5.1. AudioNode の作成
AudioNode
は 2 つの方法で作成できます。この特定のインターフェイスの
コンストラクターを使用するか、
BaseAudioContext
または
AudioContext
上のファクトリーメソッドを使用します。
AudioNode
のコンストラクターの第 1 引数として渡される
BaseAudioContext
を、作成される
AudioNode
の関連付けられた BaseAudioContext
と呼びます。同様に、ファクトリー
メソッドを使用する場合、
AudioNode
の関連付けられた
BaseAudioContextは、このファクトリーメソッドが呼び出された
BaseAudioContext
です。
AudioNode
を継承するオブジェクト
o を初期化するとは、
このインターフェイスのコンストラクターへ渡された引数
context および dict を与えて、次の
手順を実行することを意味します。
-
o に関連付けられた
BaseAudioContextを context に設定します。 -
numberOfInputs、numberOfOutputs、channelCount、channelCountMode、channelInterpretationの値を、それぞれのAudioNodeの節で示されている、この 特定のインターフェイスの既定値に設定します。 -
渡された dict の各メンバーについて、 k をメンバーのキー、v をその値として、次の手順を実行します。 これらの手順の実行中に例外が投げられた場合、反復を中止し、 例外をアルゴリズム(コンストラクターまたは ファクトリーメソッド)の呼び出し元へ伝播します。
-
k がこのインターフェイス上の
AudioParamの名前である場合、このAudioParamのvalue属性を v に設定します。 -
それ以外で、k がこのインターフェイス上の属性名である場合、 この属性に関連付けられたオブジェクトを v に設定します。
-
ファクトリーメソッドに関連付けられた インターフェイスは、 このメソッドから返されるオブジェクトのインターフェイスです。 インターフェイスに関連付けられたオプション オブジェクトは、そのインターフェイスの コンストラクターへ渡すことのできるオプションオブジェクトです。
AudioNode
は、[DOM]で説明されている
EventTarget
です。
これは、他の EventTarget
がイベントを受け取るのと同じ方法で、
AudioNode
へイベントを配送できることを意味します。
enum {ChannelCountMode "max" ,"clamped-max" ,"explicit" };
ChannelCountMode
は、ノードの
channelCount
および channelInterpretation
の値と組み合わせて、
ノードへの入力をどのようにミキシングするかを制御する
computedNumberOfChannels を決定するために使用されます。
computedNumberOfChannels は
以下に示すように決定されます。
ミキシングの方法の詳細については、§ 4 チャンネルのアップミックスと
ダウンミックスを参照してください。
| 列挙値 | 説明 |
|---|---|
"max"
|
computedNumberOfChannels は、
1 つの入力へのすべての接続の
チャンネル数の最大値です。このモードでは
channelCount
は無視されます。
|
"clamped-max"
|
computedNumberOfChannels は
"max"
と同様に決定された後、指定された
channelCount
を最大値としてクランプされます。
|
"explicit"
|
computedNumberOfChannels は、
channelCount
で指定された正確な値です。
|
enum {ChannelInterpretation "speakers" ,"discrete" };
| 列挙値 | 説明 |
|---|---|
"speakers"
|
アップミックス式またはダウンミックス式を使用します。
チャンネル数がこれらの基本的なスピーカーレイアウトの
いずれにも一致しない場合は、
"discrete"
に戻します。
|
"discrete"
| アップミックスでは、チャンネルがなくなるまで順に埋め、 残りのチャンネルを 0 にします。ダウンミックスでは、可能な限り多くのチャンネルを 埋め、その後残りのチャンネルを破棄します。 |
1.5.2. AudioNode のテールタイム
AudioNode
はテールタイムを持つことがあります。
これは、
AudioNode
に無音が入力されている場合でも、出力が無音でない可能性があることを意味します。
AudioNode
は、過去の入力が将来の出力に影響するような内部処理状態を
持つ場合、0 ではないテールタイムを持ちます。AudioNode
は、入力が無音でない状態から無音へ遷移した後でも、
計算されたテールタイムの間、無音でない出力を生成し続ける場合があります。
1.5.3. AudioNode のライフタイム
AudioNode
は、次のいずれかの条件を満たす場合、
レンダー量子の間、
アクティブに
処理中であることができます。
-
AudioScheduledSourceNodeは、現在のレンダー量子の少なくとも一部で 再生中である場合に限り、 アクティブに 処理中です。 -
MediaElementAudioSourceNodeは、そのmediaElementが現在のレンダー量子の少なくとも一部で 再生中である場合に限り、アクティブに 処理中です。 -
MediaStreamAudioSourceNodeまたはMediaStreamTrackAudioSourceNodeは、関連付けられたMediaStreamTrackオブジェクトのreadyState属性が"live"と等しく、muted属性がfalseと等しく、enabled属性がtrueと等しい場合、 アクティブに 処理中です。 -
循環内の
DelayNodeは、現在のレンダー量子について、 いずれかの出力サンプルの絶対値が \( 2^{-126} \) 以上の場合にのみ アクティブに処理中です。 -
ScriptProcessorNodeは、その入力または出力が 接続されているとき、アクティブに 処理中です。 -
AudioWorkletNodeは、そのAudioWorkletProcessorの[[callable process]]がtrueを返し、 かつそのアクティブ ソースフラグがtrueであるか、その入力の 1 つに接続されたAudioNodeのいずれかがアクティブに処理中である場合、 アクティブに 処理中です。 -
その他すべての
AudioNodeは、その入力の 1 つに接続されたAudioNodeのいずれかがアクティブに処理中になると アクティブに 処理中になり、他の アクティブに 処理中のAudioNodeから受け取った入力が出力に影響しなくなると、 アクティブな 処理を停止します。
注: これには、
テールタイムを持つ
AudioNode
も考慮されます。
アクティブに
処理中でない
AudioNode
は、1 チャンネルの無音を出力します。
1.5.4. 属性
channelCount, 型は unsigned long-
channelCountは、ノードへの任意の入力に対する接続を アップミックスおよびダウンミックスするときに使用されるチャンネル数です。 値が特別に決定される一部のノードを除き、既定値は 2 です。 この属性は、入力を持たないノードには影響しません。 この値が 0 または 実装の最大チャンネル数を超える値に設定された場合、実装はNotSupportedError例外を投げなければなりません。さらに、一部のノードには、チャンネル数として可能な値に関する追加の channelCount 制約があります:
AudioDestinationNode-
動作は、デスティネーションノードが
AudioContextまたはOfflineAudioContextのデスティネーションであるかどうかによって異なります:AudioContext-
チャンネル数は 1 から
maxChannelCountの間でなければなりません。 この範囲外にチャンネル数を設定しようとすると、IndexSizeError例外を投げなければなりません。 OfflineAudioContext-
チャンネル数は変更できません。値を変更しようとすると、
InvalidStateError例外を投げなければなりません。
AudioWorkletNode-
§ 1.32.4.3.2 AudioWorkletNodeOptions によるチャンネルの構成
AudioWorkletNodeOptionsによるチャンネルの構成を参照してください。 ChannelMergerNode-
チャンネル数は変更できず、値を変更しようとすると
InvalidStateError例外を投げなければなりません。 ChannelSplitterNode-
チャンネル数は変更できず、値を変更しようとすると
InvalidStateError例外を投げなければなりません。 ConvolverNode-
チャンネル数は 2 を超えることができず、 2 を超える値へ変更しようとすると
NotSupportedError例外を投げなければなりません。 DynamicsCompressorNode-
チャンネル数は 2 を超えることができず、 2 を超える値へ変更しようとすると
NotSupportedError例外を投げなければなりません。 PannerNode-
チャンネル数は 2 を超えることができず、 2 を超える値へ変更しようとすると
NotSupportedError例外を投げなければなりません。 ScriptProcessorNode-
チャンネル数は変更できず、値を変更しようとすると
NotSupportedError例外を投げなければなりません。 StereoPannerNode-
チャンネル数は 2 を超えることができず、 2 を超える値へ変更しようとすると
NotSupportedError例外を投げなければなりません。
この属性の詳細については、§ 4 チャンネルのアップミックスとダウンミックスを 参照してください。
channelCountMode, 型は ChannelCountMode-
channelCountModeは、ノードへの任意の入力に対する接続を アップミックスおよびダウンミックスするときに、チャンネルをどのように数えるかを決定します。 既定値は "max" です。 この属性は、入力を持たないノードには影響しません。さらに、一部のノードには、チャンネルカウント モードとして可能な値に関する追加のchannelCountMode 制約があります:
AudioDestinationNode-
AudioDestinationNodeがOfflineAudioContextのdestinationノードである場合、 チャンネルカウントモードは変更できません。値を変更しようとすると、InvalidStateError例外を投げなければなりません。 ChannelMergerNode-
チャンネルカウントモードを "
explicit" から変更することはできず、 値を変更しようとするとInvalidStateError例外を投げなければなりません。 ChannelSplitterNode-
チャンネルカウントモードを "
explicit" から変更することはできず、 値を変更しようとするとInvalidStateError例外を投げなければなりません。 ConvolverNode-
チャンネルカウントモードを "
max" に設定することはできず、 "max" に設定しようとするとNotSupportedError例外を投げなければなりません。 DynamicsCompressorNode-
チャンネルカウントモードを "
max" に設定することはできず、 "max" に設定しようとするとNotSupportedError例外を投げなければなりません。 PannerNode-
チャンネルカウントモードを "
max" に設定することはできず、 "max" に設定しようとするとNotSupportedError例外を投げなければなりません。 ScriptProcessorNode-
チャンネルカウントモードを "
explicit" から変更することはできず、 値を変更しようとするとNotSupportedError例外を投げなければなりません。 StereoPannerNode-
チャンネルカウントモードを "
max" に設定することはできず、 "max" に設定しようとするとNotSupportedError例外を投げなければなりません。
この属性の詳細については、§ 4 チャンネルのアップミックスとダウンミックス の節を参照してください。
channelInterpretation, 型は ChannelInterpretation-
channelInterpretationは、ノードへの任意の入力に対する接続をアップミックスおよびダウンミックスするときに、 個々のチャンネルをどのように扱うかを決定します。既定値は "speakers" です。 この属性は入力を持たないノードには 影響しません。さらに、一部のノードには、チャンネル解釈として可能な 値に関する追加の channelInterpretation 制約があります:
ChannelSplitterNode-
チャンネル解釈を "
discrete" から変更することはできず、 値を変更しようとするとInvalidStateError例外を投げなければなりません。
この属性の詳細については、§ 4 チャンネルのアップミックスとダウンミックスを参照してください。
context, 型は BaseAudioContext、読み取り専用-
この
AudioNodeを所有するBaseAudioContext。 numberOfInputs, 型は unsigned long、読み取り専用-
AudioNodeに入力される入力数。 ソースノードでは、これは 0 です。この属性は 多くのAudioNode型で事前に決定されていますが、ChannelMergerNodeやAudioWorkletNodeのような一部のAudioNodeは可変数の入力を持ちます。 numberOfOutputs, 型は unsigned long、読み取り専用-
AudioNodeから出る出力数。この 属性は一部のAudioNode型では事前に決定されていますが、ChannelSplitterNodeやAudioWorkletNodeのように可変である場合もあります。
1.5.5. メソッド
connect(destinationNode, output, input)-
ある特定のノードの指定された出力と、 別の特定のノードの指定された入力との間には、1 つの接続しか存在できません。 同じ終端を持つ複数の接続は無視されます。
このメソッドは
destinationAudioNodeオブジェクトを返します。AudioNode.connect(destinationNode, output, input) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationNodedestinationパラメーターは、接続先となるAudioNodeです。destinationパラメーターが、 別のAudioContextを使用して作成されたAudioNodeである場合、InvalidAccessErrorを投げなければなりません。つまり、AudioNodeをAudioContext間で共有することはできません。 複数のAudioNodeを同じAudioNodeへ接続できます。これについてはチャンネルのアップミックスと ダウンミックスの節で説明します。outputunsigned long✘ ✔ outputパラメーターは、AudioNodeのどの出力から接続するかを表すインデックスです。このパラメーターが範囲外の場合、IndexSizeError例外を投げなければなりません。 connect() を複数回呼び出すことで、AudioNodeの出力を複数の入力へ接続できます。したがって、"fan-out" がサポートされます。inputinputパラメーターは、デスティネーションAudioNodeのどの入力へ接続するかを表すインデックスです。このパラメーターが範囲外の場合、IndexSizeError例外を投げなければなりません。AudioNodeを別のAudioNodeへ接続して、循環を作成できます。つまり、あるAudioNodeが別のAudioNodeへ接続され、それがさらに最初のAudioNodeの入力またはAudioParamへ接続される場合です。戻り値の型:AudioNode connect(destinationParam, output)-
AudioNodeをAudioParamへ接続し、a-rate 信号で パラメーター値を制御します。connect() を複数回呼び出すことで、
AudioNodeの出力を複数のAudioParamへ接続できます。したがって、"fan-out" がサポートされます。connect() を複数回呼び出すことで、複数の
AudioNodeの出力を 1 つのAudioParamへ接続できます。したがって、"fan-in" がサポートされます。AudioParamは、それに接続された任意のAudioNode出力からレンダリングされたオーディオデータを受け取り、 まだモノラルでない場合はダウンミックスによって モノラルに変換し、その後、 他のそのような出力とミックスし、最後に、 パラメーターにスケジュールされたタイムライン変更を含む 固有のパラメーター値(オーディオ接続がない場合にAudioParamが通常持つvalue)とミックスします。モノラルへのダウンミックスは、
channelCount= 1、channelCountMode= "explicit"、 およびchannelInterpretation= "speakers" であるAudioNodeのダウンミックスと同等です。ある特定のノードの指定された出力と、特定の
AudioParamとの間には、1 つの接続しか存在できません。 同じ終端を持つ複数の接続は無視されます。AudioNode.connect(destinationParam, output) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationParamAudioParam✘ ✘ destinationパラメーターは、接続先となるAudioParamです。このメソッドはdestinationのAudioParamオブジェクトを返しません。destinationParamが、このメソッドが呼び出されたAudioNodeを作成したBaseAudioContextとは異なるBaseAudioContextに属するAudioNodeに属している場合、InvalidAccessErrorを投げなければなりません。outputunsigned long✘ ✔ outputパラメーターは、AudioNodeのどの出力から接続するかを表すインデックスです。parameterが 範囲外の場合、IndexSizeError例外を投げなければなりません。戻り値の型:undefined disconnect()-
AudioNodeから出るすべての接続を切断します。パラメーターなし。戻り値の型:undefined disconnect(output)-
AudioNodeの 1 つの出力を、それが接続されている他の任意のAudioNodeまたはAudioParamオブジェクトから切断します。AudioNode.disconnect(output) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 outputunsigned long✘ ✘ このパラメーターは、 AudioNodeのどの出力を切断するかを表すインデックスです。指定された出力から出るすべての接続を切断します。 このパラメーターが範囲外の場合、IndexSizeError例外を投げなければなりません。戻り値の型:undefined disconnect(destinationNode)-
AudioNodeの、特定のデスティネーションAudioNodeへ向かうすべての出力を切断します。AudioNode.disconnect(destinationNode) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationNodedestinationNodeパラメーターは、切断するAudioNodeです。指定されたdestinationNodeへ向かうすべての接続を切断します。destinationNodeへの接続がない場合、InvalidAccessError例外を投げなければなりません。戻り値の型:undefined disconnect(destinationNode, output)-
AudioNodeの特定の出力を、あるデスティネーションAudioNodeの任意およびすべての入力から切断します。AudioNode.disconnect(destinationNode, output) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationNodedestinationNodeパラメーターは、切断するAudioNodeです。指定された出力からdestinationNodeへの接続がない場合、InvalidAccessError例外を投げなければなりません。outputunsigned long✘ ✘ outputパラメーターは、AudioNodeのどの出力から切断するかを表すインデックスです。このパラメーターが範囲外の場合、IndexSizeError例外を投げなければなりません。戻り値の型:undefined disconnect(destinationNode, output, input)-
AudioNodeの特定の出力を、ある デスティネーションAudioNodeの特定の入力から切断します。AudioNode.disconnect(destinationNode, output, input) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationNodedestinationNodeパラメーターは、切断するAudioNodeです。指定された出力から指定された入力へのdestinationNodeとの接続がない場合、InvalidAccessError例外を投げなければなりません。outputunsigned long✘ ✘ outputパラメーターは、AudioNodeのどの出力から切断するかを表すインデックスです。このパラメーターが範囲外の場合、IndexSizeError例外を投げなければなりません。inputinputパラメーターは、デスティネーションAudioNodeのどの入力を切断するかを表すインデックスです。このパラメーターが範囲外の場合、IndexSizeError例外を投げなければなりません。戻り値の型:undefined disconnect(destinationParam)-
AudioNodeの、特定のデスティネーションAudioParamへ向かうすべての出力を切断します。 この操作が有効になると、このAudioNodeが計算済みパラメーター値へ寄与する値は 0 になります。固有の パラメーター値はこの操作の影響を受けません。AudioNode.disconnect(destinationParam) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationParamAudioParam✘ ✘ destinationParamパラメーターは、切断するAudioParamです。destinationParamへの接続がない場合、InvalidAccessError例外を投げなければなりません。戻り値の型:undefined disconnect(destinationParam, output)-
AudioNodeの特定の出力を、特定のデスティネーションAudioParamから切断します。 この操作が有効になると、このAudioNodeが計算済みパラメーター値へ寄与する値は 0 になります。固有の パラメーター値はこの操作の影響を受けません。AudioNode.disconnect(destinationParam, output) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 destinationParamAudioParam✘ ✘ destinationParamパラメーターは、切断するAudioParamです。destinationParamへの接続がない場合、InvalidAccessError例外を投げなければなりません。outputunsigned long✘ ✘ outputパラメーターは、AudioNodeのどの出力から切断するかを表すインデックスです。parameterが 範囲外の場合、IndexSizeError例外を投げなければなりません。戻り値の型:undefined
1.5.6.
AudioNodeOptions
これは、すべての
AudioNode
を構築するときに使用できるオプションを指定します。
すべてのメンバーは省略可能です。ただし、各ノードで使用される具体的な
値は、実際のノードによって異なります。
dictionary AudioNodeOptions {unsigned long channelCount ;ChannelCountMode channelCountMode ;ChannelInterpretation channelInterpretation ; };
1.5.6.1.
AudioNodeOptions
辞書のメンバー
channelCount, 型は unsigned long-
channelCount属性に対して希望するチャンネル数。 channelCountMode, 型は ChannelCountMode-
channelCountMode属性に対して希望するモード。 channelInterpretation, 型は ChannelInterpretation-
channelInterpretation属性に対して希望するモード。
1.6.
AudioParam
インターフェイス
AudioParam
は、音量など、
AudioNode
の機能の個々の側面を制御します。
パラメーターは、value 属性を使用して
特定の値へ即座に設定できます。または、エンベロープ、音量の
フェード、LFO、フィルタースイープ、グレインウィンドウなどのために、
値の変更を非常に正確な時刻(
AudioContext
の currentTime
属性の時間座標系内)で発生するようスケジュールできます。このようにして、
任意のタイムラインベースのオートメーション曲線を任意の
AudioParam
に設定できます。さらに、
AudioNode
の出力からのオーディオ信号を
AudioParam
に接続して、固有の
パラメーター値に加算できます。
一部の合成および処理用 AudioNode
は、値をオーディオサンプルごとに考慮しなければならない
AudioParam
を属性として持ちます。その他の
AudioParam
では、サンプル精度は重要ではなく、
値の変化をより粗い間隔でサンプリングできます。個々の
AudioParam
は、値をオーディオサンプルごとに考慮しなければならないことを意味する
a-rate パラメーターであるか、
または k-rate
パラメーターであるかを指定します。
実装はブロック処理を使用しなければならず、各
AudioNode
は 1 つのレンダー
量子を処理します。
各レンダー量子について、
k-rate パラメーターの値は
最初のサンプルフレームの時刻でサンプリングしなければならず、
その値をブロック全体で使用しなければなりません。
a-rate パラメーターは
ブロックの各サンプルフレームについてサンプリングしなければなりません。
AudioParam
によっては、そのレートを
automationRate
属性を
"a-rate"
または "k-rate"
のいずれかに設定することで制御できます。
詳細については、個々の
AudioParam
の説明を参照してください。
各 AudioParam
には、パラメーターの単純な公称
範囲をともに形成する
minValue
および maxValue
属性があります。実質的に、
パラメーターの値は \([\mathrm{minValue},
\mathrm{maxValue}]\) の範囲にクランプされます。完全な詳細については
§ 1.6.3 値の計算を参照してください。
多くの AudioParam
では、minValue
および maxValue
は、可能な最大範囲に設定することを意図しています。この場合、
maxValue
は 3.4028235e38 である
最大正単精度浮動小数点値に設定するべきです。
(ただし、IEEE-754 倍精度
浮動小数点値のみをサポートする JavaScript では、これは 3.4028234663852886e38 と記述しなければなりません。)
同様に、minValue
は、最大正単精度浮動小数点値の負の値である
最小負単精度浮動小数点値、すなわち -3.4028235e38 に設定するべきです。
(同様に、JavaScript では
-3.4028234663852886e38 と記述しなければなりません。)
AudioParam
は、0 個以上のオートメーションイベントのリストを保持します。各オートメーションイベントは、
AudioContext
の currentTime
属性の時間座標系における、その
オートメーションイベント時刻に関連して、
特定の時間範囲にわたるパラメーター値の変更を指定します。
オートメーションイベントのリストは、オートメーションイベント時刻の
昇順で保持されます。
特定のオートメーションイベントの動作は、
AudioContext
の現在時刻、およびこのイベントとリスト内の隣接イベントの
オートメーションイベント時刻の関数です。次の
オートメーションメソッドは、メソッド固有の型の
新しいイベントをイベントリストへ追加することで、
イベントリストを変更します:
-
setValueAtTime()-SetValue -
linearRampToValueAtTime()-LinearRampToValue -
exponentialRampToValueAtTime()-ExponentialRampToValue -
setTargetAtTime()-SetTarget -
setValueCurveAtTime()-SetValueCurve
これらのメソッドを呼び出すとき、次の規則が適用されます:
-
オートメーション イベント時刻は、 現在のサンプルレートに対して量子化されません。曲線やランプを 決定する式は、イベントのスケジュール時に指定された正確な数値 時刻に適用されます。
-
これらのイベントの 1 つが、すでに 1 つ以上のイベントが存在する 時刻に追加された場合、それらの後、 ただしそのイベントより後の時刻を持つイベントの前に配置されます。
-
setValueCurveAtTime() が 時刻 \(T\)、継続時間 \(D\) で呼び出され、 \(T\) より厳密に大きく、かつ \(T + D\) より厳密に小さい時刻を持つイベントが 存在する場合、
NotSupportedError例外を投げなければなりません。つまり、他のイベントを含む時間区間中に 値曲線をスケジュールすることは許可されませんが、別のイベントと まったく同じ時刻に値曲線をスケジュールすることは許可されます。 -
同様に、 オートメーションメソッドが \([T, T+D)\) に含まれる時刻で呼び出された場合、 \(T\) を曲線の時刻、\(D\) をその継続時間として、
NotSupportedError例外を投げなければなりません。
注: AudioParam
属性は、value
属性を除き、読み取り専用です。
AudioParam
のオートメーションレートは、
automationRate
属性を次の値のいずれかに設定することで選択できます。
ただし、一部の AudioParam
には、オートメーションレートを変更できるかどうかに
制約があります。
enum {AutomationRate "a-rate" ,"k-rate" };
| 列挙値 | 説明 |
|---|---|
"a-rate"
|
この AudioParam
は a-rate
処理に設定されます。
|
"k-rate"
|
この AudioParam
は k-rate
処理に設定されます。
|
各 AudioParam
は内部スロット [[current value]] を持ち、
初期値として AudioParam の
defaultValue
が設定されます。
[Exposed =Window ]interface AudioParam {attribute float value ;attribute AutomationRate automationRate ;readonly attribute float defaultValue ;readonly attribute float minValue ;readonly attribute float maxValue ;AudioParam setValueAtTime (float ,value double );startTime AudioParam linearRampToValueAtTime (float ,value double );endTime AudioParam exponentialRampToValueAtTime (float ,value double );endTime AudioParam setTargetAtTime (float ,target double ,startTime float );timeConstant AudioParam setValueCurveAtTime (sequence <float >,values double ,startTime double );duration AudioParam cancelScheduledValues (double );cancelTime AudioParam cancelAndHoldAtTime (double ); };cancelTime
1.6.1. 属性
automationRate, 型は AutomationRate-
AudioParamのオートメーションレート。 既定値は実際のAudioParamに依存します。既定値については、 個々のAudioParamの説明を参照してください。一部のノードには、次のような追加のオートメーションレート制約があります:
AudioBufferSourceNode-
AudioParamのplaybackRateおよびdetuneは "k-rate" でなければなりません。 レートを "a-rate" に変更した場合、InvalidStateErrorを投げなければなりません。 DynamicsCompressorNode-
AudioParamのthreshold、knee、ratio、attack、 およびreleaseは "k-rate" でなければなりません。 レートを "a-rate" に変更した場合、InvalidStateErrorを投げなければなりません。 PannerNode-
panningModelが "HRTF" の場合、PannerNodeの任意のAudioParamに対するautomationRateの設定は無視されます。 同様に、AudioListenerの任意のAudioParamに対するautomationRateの設定も無視されます。この 場合、AudioParamはautomationRateが "k-rate" に設定されているかのように動作します。
defaultValue, 型は float、読み取り専用-
value属性の初期値。 maxValue, 型は float、読み取り専用-
パラメーターが取り得る公称最大値。
minValueとともに、このパラメーターの公称範囲を形成します。 minValue, 型は float、読み取り専用-
パラメーターが取り得る公称最小値。
maxValueとともに、このパラメーターの公称範囲を形成します。 value, 型は float-
パラメーターの浮動小数点値。この属性は
defaultValueで初期化されます。この属性を取得すると、
[[current value]]スロットの内容が返されます。返される値のアルゴリズムについては § 1.6.3 値の計算を参照してください。この属性を設定すると、要求された値を
[[current value]]スロットに割り当て、 現在のAudioContextのcurrentTimeと[[current value]]を使用してsetValueAtTime() メソッドを呼び出したのと同じ効果があります。setValueAtTime()によって投げられる例外は、 この属性の設定時にも投げられます。
1.6.2. メソッド
cancelAndHoldAtTime(cancelTime)-
これは
cancelScheduledValues()と同様に、cancelTime以上の時刻を持つ、スケジュール済みのすべての パラメーター変更をキャンセルします。 ただしさらに、cancelTimeで発生するはずだったオートメーション値が、 他のオートメーションイベントが導入されるまで、 その後のすべての時刻へ伝播されます。オートメーションが実行中で、
cancelAndHoldAtTime()を呼び出した後、cancelTimeに到達する前の任意の時点で新しいオートメーションを導入できる場合のcancelAndHoldAtTime()に対するタイムラインの動作は非常に複雑です。そのため、cancelAndHoldAtTime()の動作は次のアルゴリズムで指定します。\(t_c\) をcancelTimeの値とします。 次に-
\(E_1\) を、\(t_1 \le t_c\) を満たす最大の数 \(t_1\) の時刻にある イベント(存在する場合)とします。
-
\(E_2\) を、\(t_c \lt t_2\) を満たす最小の数 \(t_2\) の時刻にある イベント(存在する場合)とします。
-
\(E_2\) が存在する場合:
-
\(E_2\) が線形ランプまたは指数ランプの場合、
-
\(E_2\) を、時刻 \(t_c\) に終了し、終了値が 元のランプの時刻 \(t_c\) での値となる 同じ種類のランプとして実質的に書き換えます。

-
手順 5 へ進みます。
-
-
それ以外の場合、手順 4 へ進みます。
-
-
\(E_1\) が存在する場合:
-
\(E_1\) が
setTargetイベントの場合、-
\(t_c\) において
setTargetが持つはずの値を使用して、 時刻 \(t_c\) にsetValueAtTimeイベントを暗黙的に挿入します。
-
手順 5 へ進みます。
-
-
\(E_1\) が開始時刻 \(t_3\)、継続時間 \(d\) の
setValueCurveの場合-
\(t_c \gt t_3 + d\) の場合、手順 5 へ進みます。
-
それ以外の場合、
-
このイベントを、開始時刻 \(t_3\)、新しい継続時間 \(t_c-t_3\) の
setValueCurveイベントで実質的に置き換えます。 ただし、これは真の置換ではありません。この オートメーションは、異なる継続時間を使用して計算された 出力ではなく、元と同じ出力を生成するようにしなければなりません。 (そうしないと値曲線のサンプリング方法が わずかに異なり、異なる結果が生成されます。)
-
手順 5 へ進みます。
-
-
-
-
時刻が \(t_c\) より大きいすべてのイベントを削除します。
イベントが追加されない場合、
cancelAndHoldAtTime()後のオートメーション値は、 元のタイムラインが時刻 \(t_c\) に持っていた一定値になります。AudioParam.cancelAndHoldAtTime() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 cancelTimedouble✘ ✘ 以前にスケジュールされたパラメーター変更を、その時刻以降キャンセルする時刻。 これは AudioContextのcurrentTime属性と同じ時間座標系の時刻です。cancelTimeが負の場合、RangeError例外を投げなければなりません。cancelTimeがcurrentTime未満の場合、currentTimeにクランプされます。戻り値の型:AudioParam -
cancelScheduledValues(cancelTime)-
cancelTime以上の時刻を持つ、スケジュール済みのすべてのパラメーター変更を キャンセルします。スケジュール済みの パラメーター変更をキャンセルするとは、スケジュール済みイベントを イベントリストから削除することを意味します。オートメーションイベント時刻がcancelTime未満である実行中のオートメーションもキャンセルされ、このような キャンセルでは元の値(そのオートメーションより前の値)が即座に 復元されるため、不連続が発生する可能性があります。cancelAndHoldAtTime()によってスケジュールされた保持値も、保持時刻がcancelTimeより後である場合は削除されます。setValueCurveAtTime()について、このイベントに対応するstartTimeおよびdurationをそれぞれ \(T_0\) および \(T_D\) とします。 次に、cancelTimeが範囲 \([T_0, T_0 + T_D]\) 内にある場合、そのイベントは タイムラインから削除されます。AudioParam.cancelScheduledValues() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 cancelTimedouble✘ ✘ 以前にスケジュールされたパラメーター変更を、その時刻以降キャンセルする時刻。 これは AudioContextのcurrentTime属性と同じ時間座標系の時刻です。cancelTimeが負の場合、RangeError例外を投げなければなりません。cancelTimeがcurrentTime未満の場合、currentTimeにクランプされます。戻り値の型:AudioParam exponentialRampToValueAtTime(value, endTime)-
直前にスケジュールされたパラメーター値から指定された値まで、 パラメーター値を指数的かつ連続的に変化させるようスケジュールします。 フィルター周波数や再生レートを表すパラメーターは、 人間が音を知覚する方法により、指数的に変更するのが最適です。
時間区間 \(T_0 \leq t < T_1\) (\(T_0\) は直前のイベントの時刻、\(T_1\) は このメソッドに渡された
endTimeパラメーター)における値は、次のように計算されます:$$ v(t) = V_0 \left(\frac{V_1}{V_0}\right)^\frac{t - T_0}{T_1 - T_0} $$ここで \(V_0\) は時刻 \(T_0\) における値、\(V_1\) は このメソッドに渡された
valueパラメーターです。 \(V_0\) と \(V_1\) の符号が異なる場合、または \(V_0\) が 0 の場合、 \(T_0 \le t \lt T_1\) について \(v(t) = V_0\) です。これはまた、0 への指数ランプが不可能であることを意味します。 適切に選択された 時定数とともに
setTargetAtTime()を使用することで、適切な近似を実現できます。この ExponentialRampToValue イベントの後にイベントがない場合、\(t \geq T_1\) では \(v(t) = V_1\) です。
このイベントに先行するイベントがない場合、指数ランプは、 属性の現在値を
value、exponentialRampToValueAtTime()が呼び出された時点のコンテキストのcurrentTimeをcurrentTimeとして、setValueAtTime(value, currentTime)が呼び出されたかのように動作します。先行するイベントが
SetTargetイベントの場合、\(T_0\) と \(V_0\) はSetTargetオートメーションの現在時刻と値から 選択されます。すなわち、SetTargetイベントがまだ開始していない場合、\(T_0\) はイベントの 開始時刻、\(V_0\) はSetTargetイベントが開始する直前の値です。この場合、ExponentialRampToValueイベントは実質的にSetTargetイベントを置き換えます。SetTargetイベントが すでに開始している場合、\(T_0\) は現在のコンテキスト時刻であり、 \(V_0\) は時刻 \(T_0\) における現在のSetTargetオートメーション値です。 どちらの場合も、オートメーション曲線は連続します。AudioParam.exponentialRampToValueAtTime() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 valuefloat✘ ✘ 指定された時刻に、パラメーターが指数ランプで到達する値。この値が 0 と等しい場合、 RangeError例外を投げなければなりません。endTimedouble✘ ✘ 指数ランプが終了する時刻で、 AudioContextのcurrentTime属性と同じ時間座標系の時刻です。endTimeが負または 有限数でない場合、RangeError例外を投げなければなりません。endTime がcurrentTime未満の場合、currentTimeにクランプされます。戻り値の型:AudioParam linearRampToValueAtTime(value, endTime)-
直前にスケジュールされたパラメーター値から指定された値まで、 パラメーター値を線形かつ連続的に変化させるようスケジュールします。
時間区間 \(T_0 \leq t < T_1\) (\(T_0\) は直前のイベントの時刻、\(T_1\) は このメソッドに渡された
endTimeパラメーター)における値は、次のように計算されます:$$ v(t) = V_0 + (V_1 - V_0) \frac{t - T_0}{T_1 - T_0} $$ここで \(V_0\) は時刻 \(T_0\) における値、\(V_1\) は このメソッドに渡された
valueパラメーターです。この LinearRampToValue イベントの後にイベントがない場合、 \(t \geq T_1\) では \(v(t) = V_1\) です。
このイベントに先行するイベントがない場合、線形ランプは、 属性の現在値を
value、linearRampToValueAtTime()が呼び出された時点のコンテキストのcurrentTimeをcurrentTimeとして、setValueAtTime(value, currentTime)が呼び出されたかのように動作します。先行するイベントが
SetTargetイベントの場合、\(T_0\) と \(V_0\) はSetTargetオートメーションの現在時刻と値から 選択されます。すなわち、SetTargetイベントがまだ開始していない場合、\(T_0\) はイベントの 開始時刻、\(V_0\) はSetTargetイベントが開始する直前の値です。この場合、LinearRampToValueイベントは実質的にSetTargetイベントを置き換えます。SetTargetイベントが すでに開始している場合、\(T_0\) は現在のコンテキスト時刻であり、 \(V_0\) は時刻 \(T_0\) における現在のSetTargetオートメーション値です。 どちらの場合も、オートメーション曲線は連続します。AudioParam.linearRampToValueAtTime() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 valuefloat✘ ✘ 指定された時刻に、パラメーターが線形ランプで到達する値。 endTimedouble✘ ✘ オートメーションが終了する時刻で、 AudioContextのcurrentTime属性と同じ時間座標系の時刻です。endTimeが負または 有限数でない場合、RangeError例外を投げなければなりません。endTime がcurrentTime未満の場合、currentTimeにクランプされます。戻り値の型:AudioParam setTargetAtTime(target, startTime, timeConstant)-
指定された時刻に、指定された時定数を持つレートで ターゲット値へ指数的に近づき始めます。用途の 1 つとして、 ADSR エンベロープの「ディケイ」および「リリース」部分を実装するのに有用です。 パラメーター値は指定された時刻に即座にターゲット値へ 変化するのではなく、ターゲット値へ徐々に変化することに注意してください。
時間区間 \(T_0 \leq t\) において、\(T_0\) を
startTimeパラメーターとすると:$$ v(t) = V_1 + (V_0 - V_1)\, e^{-\left(\frac{t - T_0}{\tau}\right)} $$ここで \(V_0\) は \(T_0\)(
startTimeパラメーター)における初期値([[current value]]属性)、 \(V_1\) はtargetパラメーターと等しく、 \(\tau\) はtimeConstantパラメーターです。このイベントの後に
LinearRampToValueまたはExponentialRampToValueイベントが続く場合、その動作はそれぞれlinearRampToValueAtTime()またはexponentialRampToValueAtTime()で説明されています。その他すべてのイベントでは、SetTargetイベントは次のイベントの時刻に終了します。AudioParam.setTargetAtTime() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 targetfloat✘ ✘ 指定された時刻に、パラメーターが変化を開始する先の値。 startTimedouble✘ ✘ 指数的な接近を開始する時刻で、 AudioContextのcurrentTime属性と同じ時間座標系の時刻です。startが負または 有限数でない場合、RangeError例外を投げなければなりません。startTime がcurrentTime未満の場合、currentTimeにクランプされます。timeConstantfloat✘ ✘ ターゲット値への一次フィルター(指数的)接近の時定数値。 この値が大きいほど、遷移は遅くなります。値は非負でなければならず、そうでなければ RangeError例外を投げなければなりません。timeConstantが 0 の場合、 出力値は即座に最終値へジャンプします。より正確には、timeConstant は ステップ入力応答(値 0 から 1 への遷移)が与えられたとき、 一次線形連続時間不変システムが値 \(1 - 1/e\)(約 63.2%)に到達するまでの時間です。戻り値の型:AudioParam setValueAtTime(value, startTime)-
指定された時刻にパラメーター値を変更するようスケジュールします。
この
SetValueイベントの後にイベントがない場合、 \(t \geq T_0\) では \(v(t) = V\) です。ここで \(T_0\) はstartTimeパラメーター、\(V\) はvalueパラメーターです。言い換えると、値は 一定のままです。この
SetValueイベントの後にある次のイベント (時刻 \(T_1\) を持つ)がLinearRampToValueまたはExponentialRampToValue型でない場合、\(T_0 \leq t < T_1\) について:$$ v(t) = V $$言い換えると、この時間区間中、値は一定のままであり、 「ステップ」関数を作成できます。
この
SetValueイベントの次のイベントがLinearRampToValueまたはExponentialRampToValue型の場合、それぞれlinearRampToValueAtTime()またはexponentialRampToValueAtTime()を参照してください。AudioParam.setValueAtTime() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 valuefloat✘ ✘ 指定された時刻にパラメーターが変化する先の値。 startTimedouble✘ ✘ パラメーターが指定された値へ変化する時刻で、 BaseAudioContextのcurrentTime属性と同じ時間座標系の時刻です。startTimeが負または 有限数でない場合、RangeError例外を投げなければなりません。startTime がcurrentTime未満の場合、currentTimeにクランプされます。戻り値の型:AudioParam setValueCurveAtTime(values, startTime, duration)-
指定された時刻から指定された継続時間にわたり、 任意のパラメーター値の配列を設定します。値の数は 希望する継続時間に収まるようスケーリングされます。
\(T_0\) を
startTime、 \(T_D\) をduration、 \(V\) をvalues配列、 \(N\) をvalues配列の長さとします。次に、 時間区間 \(T_0 \le t < T_0 + T_D\) の間、$$ \begin{align*} k &= \left\lfloor \frac{N - 1}{T_D}(t-T_0) \right\rfloor \\ \end{align*} $$とし、\(v(t)\) は \(V[k]\) と \(V[k+1]\) の間を線形補間して計算します。
曲線の時間区間が終了した後(\(t \ge T_0 + T_D\))、 値は別のオートメーションイベント(存在する場合)が発生するまで、 曲線の最終値で一定のままです。
後続のオートメーションが
setValueCurveAtTime()イベントの終了点から開始するように、 時刻 \(T_0 + T_D\)、値 \(V[N-1]\) でsetValueAtTime()が暗黙的に呼び出されます。AudioParam.setValueCurveAtTime() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 valuessequence<float>✘ ✘ パラメーター値曲線を表す float 値のシーケンス。これらの値は 指定された時刻から指定された継続時間にわたって適用されます。このメソッドが 呼び出されると、オートメーションのために曲線の内部コピーが作成されます。そのため、 渡された配列の内容を後で変更しても AudioParamには影響しません。 この属性が長さ 2 未満のsequence<float>オブジェクトである場合、InvalidStateErrorを投げなければなりません。startTimedouble✘ ✘ 値曲線の適用を開始する時刻で、 AudioContextのcurrentTime属性と同じ時間座標系の開始時刻です。startTimeが負または 有限数でない場合、RangeError例外を投げなければなりません。startTime がcurrentTime未満の場合、currentTimeにクランプされます。durationdouble✘ ✘ startTimeパラメーターの後に、valuesパラメーターに従って値が計算される時間(秒)。durationが厳密に正でない、または 有限数でない場合、RangeError例外を投げなければなりません。戻り値の型:AudioParam
1.6.3. 値の計算
AudioParam
には 2 種類あり、
単純
パラメーターと複合パラメーターです。
単純パラメーター(既定)は、
AudioNode
の最終オーディオ出力を計算するために単独で使用されます。
複合
パラメーターは、他の
AudioParam
とともに使用され、後で
AudioNode
の出力を計算する入力として使用される値を計算する
AudioParam
です。
computedValue は、 オーディオ DSP を制御する最終値であり、各レンダリング時間量子中に オーディオレンダリングスレッドによって計算されます。
AudioParam
の値の計算は、2 つの部分で構成されます:
-
value属性および任意のオートメーション イベントから計算される paramIntrinsicValue 値。 -
オーディオ DSP を制御する最終値であり、各 レンダー量子中に オーディオレンダリングスレッドによって計算される paramComputedValue。
これらの値は次のように計算しなければなりません:
-
paramIntrinsicValue は各時刻で計算されます。 これは
value属性に直接設定された値、または この時刻以前またはこの時刻と同じ時刻を持つ オートメーション イベントがある場合は、それらのイベントから計算された 値です。指定された時間範囲からオートメーション イベントが削除された場合、 paramIntrinsicValue 値は変更されず、value属性が直接設定されるか、 その時間範囲にオートメーションイベントが追加されるまで、 以前の値を保持します。 -
[[current value]]を、このレンダー 量子の開始時点における paramIntrinsicValue の値に設定します。 -
paramComputedValue は、paramIntrinsicValue 値と入力 AudioParam バッファーの値の合計です。合計が
NaNの場合、 合計をdefaultValueに置き換えます。 -
この
AudioParamが複合パラメーターである場合、 他のAudioParamとともにその最終値を計算します。 -
computedValue を paramComputedValue に設定します。
computedValue の
公称範囲は、
このパラメーターが実質的に取り得る下限値と上限値です。
単純パラメーターでは、
computedValue は
このパラメーターの単純な公称
範囲にクランプされます。複合
パラメーターでは、それを構成する異なる
AudioParam
値から最終値を計算した後、
公称
範囲にクランプされます。
オートメーションメソッドを使用する場合も、クランプは適用されます。 ただし、オートメーション自体は、クランプがまったく存在しないかのように実行されます。 オートメーション値が出力に適用されるときにのみ、 上記の指定どおりクランプされます。
N. p. setValueAtTime( 0 , 0 ); N. p. linearRampToValueAtTime( 4 , 1 ); N. p. linearRampToValueAtTime( 0 , 2 );
曲線の初期傾斜は 4 で、最大値 1 に達するまで続き、 その時点で出力は一定に保持されます。最後に、 時刻 2 付近で曲線の傾斜は -4 になります。これは下のグラフに示されており、 破線はクリッピングがなければ生じていたものを示し、 実線は公称範囲へのクリッピングによる audioparam の 実際に期待される動作を示します。
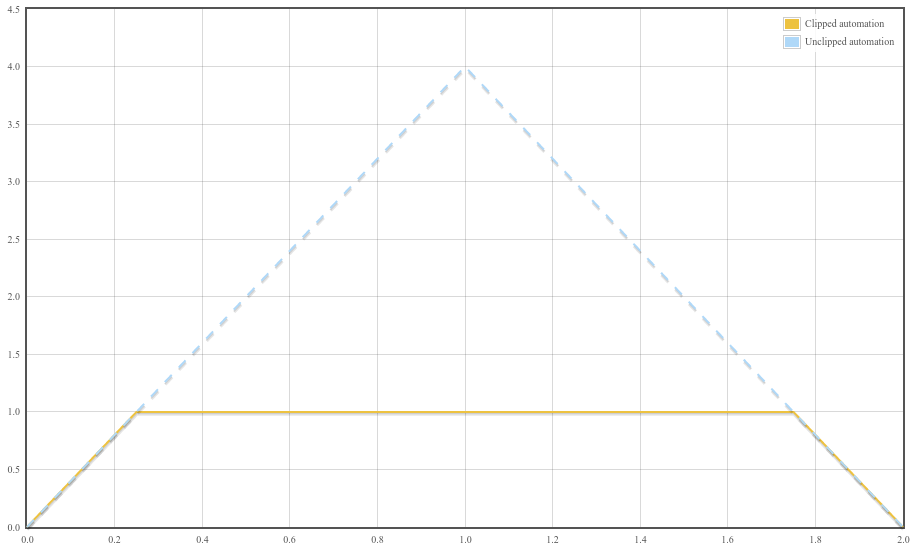
1.6.4.
AudioParam
オートメーションの例
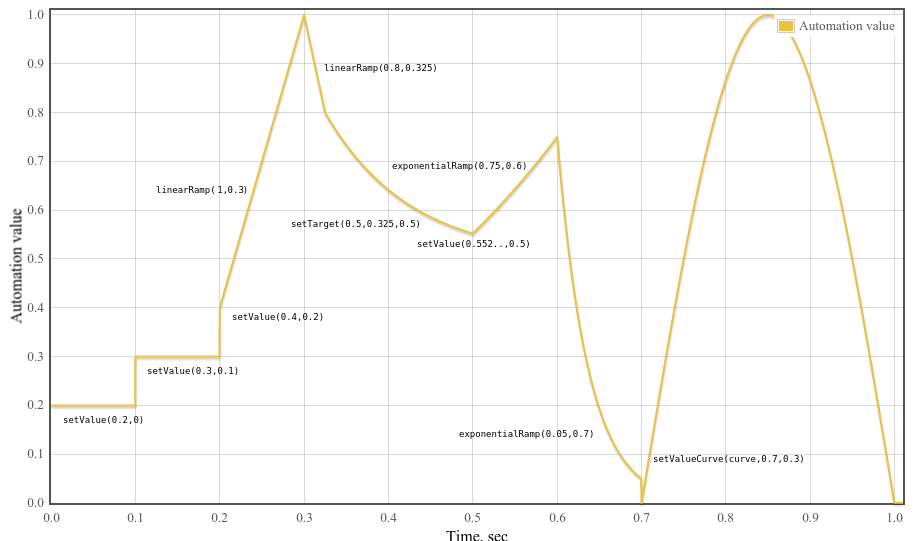
const curveLength= 44100 ; const curve= new Float32Array( curveLength); for ( const i= 0 ; i< curveLength; ++ i) curve[ i] = Math. sin( Math. PI* i/ curveLength); const t0= 0 ; const t1= 0.1 ; const t2= 0.2 ; const t3= 0.3 ; const t4= 0.325 ; const t5= 0.5 ; const t6= 0.6 ; const t7= 0.7 ; const t8= 1.0 ; const timeConstant= 0.1 ; param. setValueAtTime( 0.2 , t0); param. setValueAtTime( 0.3 , t1); param. setValueAtTime( 0.4 , t2); param. linearRampToValueAtTime( 1 , t3); param. linearRampToValueAtTime( 0.8 , t4); param. setTargetAtTime( .5 , t4, timeConstant); // 時刻 t5 における setTargetAtTime の位置を計算して、 // 後続の指数変化を正しい位置から開始し、 // ジャンプによる不連続が生じないようにする。仕様より、次を得る。 // v(t) = 0.5 + (0.8 - 0.5)*exp(-(t-t4)/timeConstant) // したがって v(t5) = 0.5 + (0.8 - 0.5)*exp(-(t5-t4)/timeConstant) param. setValueAtTime( 0.5 + ( 0.8 - 0.5 ) * Math. exp( - ( t5- t4) / timeConstant), t5); param. exponentialRampToValueAtTime( 0.75 , t6); param. exponentialRampToValueAtTime( 0.05 , t7); param. setValueCurveAtTime( curve, t7, t8- t7);
1.7.
AudioScheduledSourceNode
インターフェイス
このインターフェイスは、
AudioBufferSourceNode、
ConstantSourceNode、
および
OscillatorNode
などのソースノードに共通する機能を表します。
ソースが開始される前(start()
を呼び出す前)、ソースノードは
無音(0)を出力しなければなりません。ソースが停止された後(
stop()
を呼び出した後)、ソースはその後
無音(0)を出力しなければなりません。
AudioScheduledSourceNode
は直接インスタンス化できず、
ソースノードの具体的なインターフェイスによって拡張されます。
AudioScheduledSourceNode
は、関連付けられた BaseAudioContext
の currentTime
が、AudioScheduledSourceNode
が開始するよう設定された時刻以上であり、
停止するよう設定された時刻未満であるとき、
再生中であると言います。
AudioScheduledSourceNode
は内部ブーリアン
スロット [[source started]]
を持って作成され、初期値は
false に設定されます。
[Exposed =Window ]interface AudioScheduledSourceNode :AudioNode {attribute EventHandler onended ;undefined start (optional double when = 0);undefined stop (optional double when = 0); };
1.7.1. 属性
onended, 型は EventHandler-
AudioScheduledSourceNodeノード型へ配送されるendedイベント型のイベントハンドラーを設定するために使用されるプロパティ。 ソースノードの再生が停止したとき(具体的なノードによって決定される)、Eventインターフェイスを使用するイベントが イベントハンドラーへ配送されます。すべての
AudioScheduledSourceNodeについて、endedイベントは、stop()によって決定された停止時刻に 到達したときに配送されます。AudioBufferSourceNodeでは、durationに到達した場合、またはbuffer全体が再生された場合にも、 イベントが配送されます。
1.7.2. メソッド
start(when)-
正確な時刻にサウンドを再生するようスケジュールします。
このメソッドが呼び出されたとき、 次の手順を実行します:-
この
AudioScheduledSourceNodeの内部 スロット[[source started]]が true の場合、InvalidStateError例外を投げなければなりません。 -
以下に説明するパラメーター制約により投げなければならない エラーがないか確認します。この手順中に例外が投げられた場合、 これらの手順を中止します。
-
この
AudioScheduledSourceNode上の内部スロット[[source started]]をtrueに設定します。 -
パラメーター値をメッセージに含めて、
AudioScheduledSourceNodeを開始するための制御メッセージをキューに入れます。 -
次の条件がすべて満たされている場合にのみ、 関連付けられた
AudioContextへ制御メッセージを送信し、 そのレンダリングスレッドの実行を開始します:-
コンテキストの
[[control thread state]]が "suspended" である。 -
コンテキストが開始を許可されている。
-
[[suspended by user]]フラグがfalseである。
注: これにより、現在 開始を許可されているものの、 以前は開始を妨げられていた
AudioContextをstart()が開始できる場合があります。 -
AudioScheduledSourceNode.start(when) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 whendouble✘ ✔ whenパラメーターは、サウンドの再生を開始する時刻(秒)を表します。これはAudioContextのcurrentTime属性と同じ時間座標系です。AudioScheduledSourceNodeが出力する信号がサウンドの開始時刻に依存する場合、whenの正確な値は常に、最も近いサンプルフレームへ丸めることなく使用されます。 この値に 0 が渡された場合、または値がcurrentTime未満の場合、サウンドの再生は直ちに開始されます。whenが負の場合、RangeError例外を投げなければなりません。戻り値の型:undefined -
stop(when)-
正確な時刻にサウンドの再生を停止するようスケジュールします。
stopがすでに呼び出された後に再び呼び出された場合、 最後の呼び出しだけが適用されます。後続の呼び出しより前に バッファーがすでに停止している場合を除き、以前の呼び出しで設定された停止時刻は 適用されません。バッファーがすでに停止している場合、 それ以降のstop呼び出しは効果を持ちません。 スケジュールされた開始時刻より前に停止時刻へ到達した場合、 サウンドは再生されません。このメソッドが呼び出されたとき、次の手順を実行します:-
この
AudioScheduledSourceNodeの内部 スロット[[source started]]がtrueでない場合、InvalidStateError例外を投げなければなりません。 -
以下に説明するパラメーター制約により投げなければならない エラーがないか確認します。
-
パラメーター値をメッセージに含めて、
AudioScheduledSourceNodeを停止するための制御メッセージをキューに入れます。
ノードがAudioBufferSourceNodeの場合、AudioBufferSourceNodeを停止するための制御 メッセージを実行するとは、 再生 アルゴリズム内のhandleStop()関数を呼び出すことを意味します。AudioScheduledSourceNode.stop(when) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 whendouble✘ ✔ whenパラメーターは、ソースの再生を停止する時刻(秒)を表します。これはAudioContextのcurrentTime属性と同じ時間座標系です。この値に 0 が渡された場合、または値がcurrentTime未満の場合、サウンドの再生は直ちに停止します。whenが負の場合、RangeError例外を投げなければなりません。戻り値の型:undefined -
1.8.
AnalyserNode
インターフェイス
このインターフェイスは、リアルタイムの 周波数および時間領域解析情報を提供できるノードを表します。オーディオストリームは 入力から出力へ未処理のまま渡されます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | この出力は未接続のままにできます。 |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
[Exposed =Window ]interface AnalyserNode :AudioNode {constructor (BaseAudioContext ,context optional AnalyserOptions = {});options undefined getFloatFrequencyData (Float32Array );array undefined getByteFrequencyData (Uint8Array );array undefined getFloatTimeDomainData (Float32Array );array undefined getByteTimeDomainData (Uint8Array );array attribute unsigned long fftSize ;readonly attribute unsigned long frequencyBinCount ;attribute double minDecibels ;attribute double maxDecibels ;attribute double smoothingTimeConstant ; };
1.8.1. コンストラクター
AnalyserNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option で呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化しなければなりません。AnalyserNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい AnalyserNodeが関連付けられるBaseAudioContext。optionsAnalyserOptions✘ ✔ この AnalyserNodeの省略可能な初期パラメーター値。
1.8.2. 属性
fftSize, 型は unsigned long-
周波数領域解析に使用する FFT のサイズ(サンプルフレーム単位)。 これは 32 から 32768 の範囲の 2 の累乗でなければならず、そうでなければ
IndexSizeError例外を投げなければなりません。既定値は 2048 です。 大きな FFT サイズは計算コストが高くなる場合があることに注意してください。fftSizeが別の値へ変更された場合、 周波数データの平滑化に関連するすべての状態 (getByteFrequencyData()およびgetFloatFrequencyData()用)が リセットされます。つまり、時間方向の平滑化 に使用される前のブロック \(\hat{X}_{-1}[k]\) は、 すべての \(k\) について 0 に設定されます。fftSizeを増やすと、現在の時間領域データを、 以前には含まれていなかった過去の フレームを含むよう拡張しなければならないことに注意してください。これは、AnalyserNodeが実質的に最後の 32768 サンプルフレームを保持しなければならず、 現在の時間領域 データは、その中の最新のfftSizeサンプルフレームであることを意味します。 frequencyBinCount, 型は unsigned long、読み取り専用-
FFT サイズの半分。
maxDecibels, 型は double-
maxDecibelsは、FFT 解析データを符号なしバイト値へ変換するための スケーリング範囲における最大パワー値です。既定値は -30 です。 この属性の値をminDecibels以下の値に設定した場合、IndexSizeError例外を投げなければなりません。 minDecibels, 型は double-
minDecibelsは、FFT 解析データを符号なしバイト値へ変換するための スケーリング範囲における最小パワー値です。既定値は -100 です。 この属性の値をmaxDecibels以上の値に設定した場合、IndexSizeError例外を投げなければなりません。 smoothingTimeConstant, 型は double-
0 から 1 までの値で、0 は直前の解析フレームとの 時間平均を行わないことを表します。既定値は 0.8 です。 この属性の値を 0 未満または 1 より大きい値に設定した場合、
IndexSizeError例外を投げなければなりません。
1.8.3. メソッド
getByteFrequencyData(array)-
現在の周波数データを array に書き込みます。 array のバイト長が
frequencyBinCount未満の場合、余分な要素は破棄されます。array の バイト長がfrequencyBinCountより大きい場合、余分な要素は無視されます。周波数データの計算には、 最新のfftSizeフレームが使用されます。getByteFrequencyData()またはgetFloatFrequencyData()の別の呼び出しが、直前の呼び出しと同じ レンダー量子内で発生した場合、 現在の 周波数データは同じデータで更新されません。代わりに、 以前に計算されたデータが返されます。符号なしバイト配列に格納される値は、 次の方法で計算されます。現在の周波数 データを FFT の窓関数処理と 平滑化で説明される \(Y[k]\) とします。このときバイト値 \(b[k]\) は
$$
    b[k] = \left\lfloor
            \frac{255}{\mbox{dB}_{max} - \mbox{dB}_{min}}
            \left(Y[k] - \mbox{dB}_{min}\right)
        \right\rfloor
$$
ここで \(\mbox{dB}_{min}\) は
minDecibels、 \(\mbox{dB}_{max}\) はmaxDecibelsAnalyserNode.getByteFrequencyData() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 arrayUint8Array✘ ✘ 周波数領域解析データのコピー先となるパラメーター。 戻り値の型:undefined getByteTimeDomainData(array)-
現在の時間領域 データ(波形データ)を array に書き込みます。 array のバイト長が
fftSize未満の場合、余分な要素は破棄されます。array の バイト長がfftSizeより大きい場合、余分な要素は無視されます。 バイトデータの計算には、最新のfftSizeフレームが使用されます。符号なしバイト配列に格納される値は、 次の方法で計算されます。\(x[k]\) を時間領域データとします。このとき バイト値 \(b[k]\) は
$$
    b[k] = \left\lfloor 128(1 + x[k]) \right\rfloor.
$$
\(b[k]\) が 0 から 255 の範囲外にある場合、 \(b[k]\) はその範囲内に収まるようクリップされます。
AnalyserNode.getByteTimeDomainData() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 arrayUint8Array✘ ✘ 時間領域のサンプルデータのコピー先となるパラメーター。 戻り値の型:undefined getFloatFrequencyData(array)-
現在の周波数データを array に書き込みます。 array の要素数が
frequencyBinCount未満の場合、余分な要素は破棄されます。array の要素数がfrequencyBinCountより多い場合、余分な要素は無視されます。周波数データの計算には、最新のfftSizeフレームが使用されます。getFloatFrequencyData()またはgetByteFrequencyData()の別の呼び出しが、直前の呼び出しと同じ レンダー量子内で発生した場合、 現在の 周波数データは同じデータで更新されません。代わりに、 以前に計算されたデータが返されます。周波数データの単位は dB です。
AnalyserNode.getFloatFrequencyData() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 arrayFloat32Array✘ ✘ 周波数領域解析データのコピー先となるパラメーター。 戻り値の型:undefined getFloatTimeDomainData(array)-
現在の時間領域 データ(波形データ)を array に書き込みます。 array の要素数が
fftSizeの値より少ない場合、余分な要素は破棄されます。array の要素数がfftSizeの値より多い場合、余分な要素は無視されます。最新のfftSizeフレームが (ダウンミックス後に)書き込まれます。AnalyserNode.getFloatTimeDomainData() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 arrayFloat32Array✘ ✘ 時間領域のサンプルデータのコピー先となるパラメーター。 戻り値の型:undefined
1.8.4.
AnalyserOptions
これは、
AnalyserNode
を構築するときに使用するオプションを指定します。
すべてのメンバーは省略可能です。指定されていない場合、
通常の既定値を使用してノードを構築します。
dictionary AnalyserOptions :AudioNodeOptions {unsigned long fftSize = 2048;double maxDecibels = -30;double minDecibels = -100;double smoothingTimeConstant = 0.8; };
1.8.4.1.
AnalyserOptions
辞書のメンバー
fftSize, 型は unsigned long、既定値は2048-
周波数領域解析に使用する FFT の希望する初期サイズ。
maxDecibels, 型は double、既定値は-30-
FFT 解析の希望する初期最大パワー(dB)。
minDecibels, 型は double、既定値は-100-
FFT 解析の希望する初期最小パワー(dB)。
smoothingTimeConstant, 型は double、既定値は0.8-
FFT 解析の希望する初期平滑化定数。
1.8.5. 時間領域のダウンミックス
現在の
時間領域データを計算するとき、入力信号は、
channelCount
が 1、
channelCountMode
が
"max"、
channelInterpretation
が "speakers"
であるかのように、モノラルへダウンミックスしなければなりません。
これは AnalyserNode
自体の設定とは独立しています。ダウンミックス操作には、
最新の
fftSize
フレームが使用されます。
1.8.6. FFT の窓関数処理と時間方向の平滑化
現在の周波数 データを計算するとき、次の操作を 実行します:
-
現在の時間領域データを計算します。
-
時間領域入力データにBlackman 窓を適用します。
-
窓処理された時間領域入力データにフーリエ変換を適用して、 実数および虚数の周波数データを取得します。
-
周波数領域データを時間方向に平滑化します。
-
dB に変換します。
以下では、\(N\) をこの AnalyserNode
の fftSize
属性の値とします。
$$
\begin{align*}
    \alpha &= \mbox{0.16} \\ a_0 &= \frac{1-\alpha}{2} \\
    a_1 &= \frac{1}{2} \\
    a_2 &= \frac{\alpha}{2} \\
    w[n] &= a_0 - a_1 \cos\frac{2\pi n}{N} + a_2 \cos\frac{4\pi n}{N}, \mbox{ for } n = 0, \ldots, N - 1
\end{align*}
$$
窓処理された信号 \(\hat{x}[n]\) は
$$
    \hat{x}[n] = x[n] w[n], \mbox{ for } n = 0, \ldots, N - 1
$$
$$
    X[k] = \frac{1}{N} \sum_{n = 0}^{N - 1} \hat{x}[n]\, W^{-kn}_{N}
$$
\(k = 0, \dots, N/2-1\)、ここで \(W_N = e^{2\pi i/N}\) です。
-
\(\hat{X}_{-1}[k]\) を、 前のブロック に対してこの操作を行った結果とします。 前の ブロックは、 直前の時間方向の平滑化操作で計算されたバッファー、 またはこれが最初の時間方向の平滑化である場合は \(N\) 個の 0 からなる配列として定義されます。
-
\(\tau\) を、この
AnalyserNodeのsmoothingTimeConstant属性の値とします。 -
\(X[k]\) を、現在のブロックにフーリエ変換を適用した結果とします。
このとき、平滑化された値 \(\hat{X}[k]\) は次のように計算されます
$$
    \hat{X}[k] = \tau\, \hat{X}_{-1}[k] + (1 - \tau)\, \left|X[k]\right|
$$
-
\(\hat{X}[k]\) が
NaN、正の無限大、または負の無限大の場合、 \(\hat{X}[k]\) = 0 に設定します。
\(k = 0, \ldots, N - 1\) について。
$$
    Y[k] = 20\log_{10}\hat{X}[k]
$$
\(k = 0, \ldots, N-1\) について。
この配列 \(Y[k]\) は、
getFloatFrequencyData()
の出力配列へコピーされます。
getByteFrequencyData()
では、\(Y[k]\) は
minDecibels
と
maxDecibelsminDecibels
が値 0、
maxDecibels
1.9.
AudioBufferSourceNode
インターフェイス
このインターフェイスは、AudioBuffer
内のメモリー上のオーディオ資産からのオーディオソースを表します。
高度なスケジュール柔軟性と
精度を必要とするオーディオ資産の再生に有用です。ネットワークまたはディスク上の
資産をサンプル精度で再生する必要がある場合、実装者は
AudioWorkletNode
を使用して再生を実装するべきです。
start()
メソッドは、
サウンドの再生時刻をスケジュールするために使用されます。
start()
メソッドを複数回
呼び出すことはできません。バッファーのオーディオデータが完全に再生されたとき
(loop
属性が false の場合)、または
stop()
メソッドが呼び出され、指定された時刻へ到達したとき、
再生は自動的に停止します。詳細については、
start()
および
stop()
の説明を参照してください。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
出力のチャンネル数は、
buffer
属性に割り当てられた AudioBuffer のチャンネル数と等しく、
buffer
が
null の場合は、無音の 1 チャンネルです。
さらに、バッファーが複数のチャンネルを持つ場合、
AudioBufferSourceNode
の出力は、次のいずれかの条件が成立する時刻の後にある
レンダー量子の開始時点で、無音の 1 チャンネルへ
変更しなければなりません:
AudioBufferSourceNode
の再生ヘッド位置は、
バッファー内の最初のサンプルフレームの時間座標に対する、
秒単位の時間オフセットを表す任意の量として定義されます。
このような値は、ノードの playbackRate および detune
パラメーターとは独立して考慮されます。
一般に、再生ヘッド位置はサブサンプル精度を持つことができ、
正確なサンプルフレーム位置を参照する必要はありません。0 から
バッファーの継続時間までの有効な値を取ることができます。
playbackRate
および
detune
属性は
複合パラメーター
を形成します。
これらは、computedPlaybackRate 値を決定するために
一緒に使用されます:
computedPlaybackRate(t) = playbackRate(t) * pow(2, detune(t) / 1200)
この複合パラメーター の公称範囲は \((-\infty, \infty)\) です。
AudioBufferSourceNode
は内部ブーリアン
スロット [[buffer set]]
を持って作成され、初期値は false に設定されます。
[Exposed =Window ]interface AudioBufferSourceNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional AudioBufferSourceOptions = {});options attribute AudioBuffer ?buffer ;readonly attribute AudioParam playbackRate ;readonly attribute AudioParam detune ;attribute boolean loop ;attribute double loopStart ;attribute double loopEnd ;undefined start (optional double when = 0,optional double offset ,optional double duration ); };
1.9.1. コンストラクター
AudioBufferSourceNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option で呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化しなければなりません。AudioBufferSourceNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい AudioBufferSourceNodeが関連付けられるBaseAudioContext。optionsAudioBufferSourceOptions✘ ✔ この AudioBufferSourceNodeの省略可能な初期パラメーター値。
1.9.2. 属性
buffer, 型は AudioBuffer、 null 許容-
再生するオーディオ資産を表します。
buffer属性を設定するには、次の手順を実行します:-
new buffer を、
bufferに割り当てるAudioBufferまたはnull値とします。 -
new buffer が
nullでなく、[[buffer set]]が true の場合、InvalidStateErrorを投げて、これらの手順を中止します。 -
new buffer が
nullでない場合、[[buffer set]]を true に設定します。 -
new buffer を
buffer属性に割り当てます。
-
detune, 型は AudioParam、 読み取り専用-
オーディオストリームがレンダリングされる速度を変調するための、 セント単位の追加パラメーター。このパラメーターは
playbackRateとともに computedPlaybackRate を形成する複合 パラメーターです。パラメーター 値 注記 defaultValue0 minValue最小負単精度浮動小数点値 約 -3.4028235e38 maxValue最大正単精度浮動小数点値 約 3.4028235e38 automationRate" k-rate"オートメーションレート 制約あり loop, 型は boolean-
loopStartとloopEndで指定されたオーディオデータ領域を、 ループで連続的に再生するかどうかを示します。 既定値はfalseです。 loopEnd, 型は double-
loop属性が true の場合にループを終了する、省略可能な 再生ヘッド 位置。その値はループ内容に含まれません。 既定のvalueは 0 であり、0 からバッファーの継続時間までの 任意の値に設定すると有用です。loopEndが 0 以下である場合、またはloopEndがバッファーの継続時間より大きい場合、 ループはバッファーの終端で終了します。 loopStart, 型は double-
loop属性が true の場合にループを開始する、省略可能な 再生ヘッド位置。 既定のvalueは 0 であり、0 からバッファーの継続時間までの 任意の値に設定すると有用です。loopStartが 0 未満の場合、ループは 0 から開始します。loopStartがバッファーの継続時間より大きい場合、ループは バッファーの終端から開始します。 playbackRate, 型は AudioParam、 読み取り専用-
オーディオストリームをレンダリングする速度。これは
detuneとともに computedPlaybackRate を形成する複合 パラメーターです。パラメーター 値 注記 defaultValue1 minValue最小負単精度浮動小数点値 約 -3.4028235e38 maxValue最大正単精度浮動小数点値 約 3.4028235e38 automationRate" k-rate"オートメーションレート 制約あり
1.9.3. メソッド
start(when, offset, duration)-
正確な時刻にサウンドを再生するようスケジュールします。
このメソッドが呼び出されたとき、次の手順を実行します:-
この
AudioBufferSourceNodeの内部 スロット[[source started]]がtrueの場合、InvalidStateError例外を投げなければなりません。 -
以下に説明するパラメーター制約により投げなければならない エラーがないか確認します。この手順中に 例外が投げられた場合、 これらの手順を中止します。
-
この
AudioBufferSourceNode上の内部スロット[[source started]]をtrueに設定します。 -
パラメーター値をメッセージに含めて、
AudioBufferSourceNodeを開始するための制御 メッセージをキューに入れます。 -
次の条件がすべて満たされている場合にのみ、 関連付けられた
AudioContextへ制御メッセージを送信し、 そのレンダリングスレッドの実行を開始します:-
コンテキストの
[[control thread state]]がsuspendedである。 -
コンテキストが開始を許可されている。
-
[[suspended by user]]フラグがfalseである。
注: これにより、現在 開始を許可されているものの、 以前は開始を妨げられていた
AudioContextをstart()が開始できる場合があります。 -
AudioBufferSourceNode.start(when, offset, duration) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 whendouble✘ ✔ whenパラメーターは、サウンドの再生を開始する時刻(秒)を 表します。これはAudioContextのcurrentTime属性と同じ時間座標系です。この値に 0 が渡された場合、または値が currentTime 未満の場合、サウンドの再生は直ちに開始されます。whenが負の場合、RangeError例外を投げなければなりません。offsetdouble✘ ✔ offsetパラメーターは、再生を開始する 再生ヘッド位置 を指定します。この値に 0 が渡された場合、再生は バッファーの先頭から開始します。offsetが負の場合、RangeError例外を投げなければなりません。offsetがloopEndより大きく、playbackRateが正または 0 で、loopがtrueの場合、再生はloopEndから開始します。offsetがloopStartより大きく、playbackRateが負で、loopがtrueの場合、再生はloopStartから開始します。startTimeに到達したとき、offsetは暗黙的に [0,duration] にクランプされます。 ここでdurationは、このAudioBufferSourceNodeのbuffer属性に設定されたAudioBufferのduration属性の値です。durationdouble✘ ✔ durationパラメーターは再生するサウンドの継続時間を表し、 完全または部分的なループ反復を含む、出力するバッファー内容の合計秒数として表されます。durationの単位は、playbackRateの効果とは独立しています。 たとえば、再生レート 0.5 でdurationが 5 秒の場合、5 秒分のバッファー内容を半分の速度で出力し、 10 秒の可聴出力が生成されます。durationが負の場合、RangeError例外を投げなければなりません。戻り値の型:undefined -
1.9.4.
AudioBufferSourceOptions
これは、
AudioBufferSourceNode
を構築するためのオプションを指定します。
すべてのメンバーは
省略可能です。指定されていない場合、
ノードの構築には通常の既定値が使用されます。
dictionary AudioBufferSourceOptions {AudioBuffer ?buffer ;float detune = 0;boolean loop =false ;double loopEnd = 0;double loopStart = 0;float playbackRate = 1; };
1.9.4.1.
AudioBufferSourceOptions
辞書のメンバー
buffer, 型は AudioBuffer、 null 許容-
再生するオーディオ資産。これは
bufferをAudioBufferSourceNodeのbuffer属性へ割り当てることと同等です。 detune, 型は float、既定値は0-
detuneAudioParam の初期値。 loop, 型は boolean、既定値はfalse-
loop属性の初期値。 loopEnd, 型は double、既定値は0-
loopEnd属性の初期値。 loopStart, 型は double、既定値は0-
loopStart属性の初期値。 playbackRate, 型は float、既定値は1-
playbackRateAudioParam の初期値。
1.9.5. ループ
この節は非規範的です。規範的要件については、再生 アルゴリズムを参照してください。
loop
属性を true に設定すると、ループ領域のいずれかの部分が
一度再生された後、
loopStart
および loopEnd
の端点によって定義されるバッファー領域の再生が
無期限に継続します。
loop
が true のままである間、
ループ再生は次のいずれかが発生するまで継続します:
ループ本体は、
loopStart
から loopEnd
まで(ただし loopEnd は含まない)の領域を占めると見なされます。
ループ領域の再生方向は、ノードの再生レートの符号に従います。
正の再生レートでは、
loopStart
から loopEnd
へループし、負のレートでは
loopEnd
から
loopStart
へループします。
ループは、
start()
の offset 引数の解釈には影響しません。
再生は常に要求されたオフセットから開始し、
ループは再生中にループ本体へ到達したときにのみ開始します。
有効なループ開始点および終了点は、以下のアルゴリズムで指定されるように、
0 からバッファーの継続時間までの範囲内にある必要があります。
loopEnd
にはさらに、loopStart
以上でなければならないという制約があります。
これらの制約のいずれかに違反した場合、
ループはバッファーの内容全体を含むものと見なされます。
ループ端点はサブサンプル精度を持ちます。端点が正確な サンプルフレームオフセット上にない場合、または再生レートが 1 と等しくない場合、ループの再生は、 ループされたオーディオがバッファー内の連続した非ループ領域に存在する場合と同様に、 ループの開始点と終了点を接続するよう補間されます。
ループ関連のプロパティはバッファーの再生中に変更でき、 一般には次のレンダー量子から有効になります。 正確な結果は、後述する規範的な再生アルゴリズムによって 定義されます。
loopStart
および loopEnd
属性の既定値はいずれも 0 です。
loopEnd
の値 0 はバッファーの長さと等価であるため、
既定の端点ではバッファー全体がループに含まれます。
ループ端点の値はバッファーのサンプルレートに基づく
時間オフセットとして表されることに注意してください。つまり、
これらの値は、再生中に動的に変化できるノードの
playbackRate
パラメーターとは独立しています。
1.9.6. AudioBuffer 内容の再生
この規範的な節では、次の要因が組み合わさって 再生に影響することを考慮しながら、 バッファー内容の再生を指定します:
-
サブサンプル精度で表現できる開始オフセット。
-
サブサンプル精度で表現でき、 再生中に動的に変化できるループ点。
-
正または負の有限値を取り得る単一の computedPlaybackRate を生成するために組み合わされる、 再生レートおよびデチューンパラメーター。
AudioBufferSourceNode
から出力を生成するために内部で従うアルゴリズムは、
次の原則に従います:
-
バッファーのリサンプリングは、出力の効率または品質を高めるため、 UA によって任意の時点で任意に実行できます。
-
サブサンプル開始オフセットまたはループ点では、 サンプルフレーム間の追加の補間が必要になる場合があります。
-
ループされたバッファーの再生は、補間による影響を除き、 ループされたオーディオ内容が連続して出現する非ループバッファーと 同一に動作するべきです。
アルゴリズムの説明は次のとおりです:
let buffer; // AudioBuffer employed by this node let context; // AudioContext employed by this node // The following variables capture attribute and AudioParam values for the node. // They are updated on a k-rate basis, prior to each invocation of process(). let loop; let detune; let loopStart; let loopEnd; let playbackRate; // Variables for the node's playback parameters let start= 0 , offset= 0 , duration= Infinity ; // Set by start() let stop= Infinity ; // Set by stop() // Variables for tracking node's playback state let bufferTime= 0 , started= false , enteredLoop= false ; let bufferTimeElapsed= 0 ; let dt= 1 / context. sampleRate; // Handle invocation of start method call function handleStart( when, pos, dur) { if ( arguments. length>= 1 ) { start= when; } offset= pos; if ( arguments. length>= 3 ) { duration= dur; } } // Handle invocation of stop method call function handleStop( when) { if ( arguments. length>= 1 ) { stop= when; } else { stop= context. currentTime; } } // Interpolate a multi-channel signal value for some sample frame. // Returns an array of signal values. function playbackSignal( position) { /* This function provides the playback signal function for buffer, which is a function that maps from a playhead position to a set of output signal values, one for each output channel. If |position| corresponds to the location of an exact sample frame in the buffer, this function returns that frame. Otherwise, its return value is determined by a UA-supplied algorithm that interpolates sample frames in the neighborhood of |position|. If |position| is greater than or equal to |loopEnd| and there is no subsequent sample frame in buffer, then interpolation should be based on the sequence of subsequent frames beginning at |loopStart|. */ ... } // Generate a single render quantum of audio to be placed // in the channel arrays defined by output. Returns an array // of |numberOfFrames| sample frames to be output. function process( numberOfFrames) { let currentTime= context. currentTime; // context time of next rendered frame const output= []; // accumulates rendered sample frames // Combine the two k-rate parameters affecting playback rate const computedPlaybackRate= playbackRate* Math. pow( 2 , detune/ 1200 ); // Determine loop endpoints as applicable let actualLoopStart, actualLoopEnd; if ( loop&& buffer!= null ) { if ( loopStart>= 0 && loopEnd> 0 && loopStart< loopEnd) { actualLoopStart= loopStart; actualLoopEnd= Math. min( loopEnd, buffer. duration); } else { actualLoopStart= 0 ; actualLoopEnd= buffer. duration; } } else { // If the loop flag is false, remove any record of the loop having been entered enteredLoop= false ; } // Handle null buffer case if ( buffer== null ) { stop= currentTime; // force zero output for all time } // Render each sample frame in the quantum for ( let index= 0 ; index< numberOfFrames; index++ ) { // Check that currentTime and bufferTimeElapsed are // within allowable range for playback if ( currentTime< start|| currentTime>= stop|| bufferTimeElapsed>= duration) { output. push( 0 ); // this sample frame is silent currentTime+= dt; continue ; } if ( ! started) { // Take note that buffer has started playing and get initial // playhead position. if ( loop&& computedPlaybackRate>= 0 && offset>= actualLoopEnd) { offset= actualLoopEnd; } if ( computedPlaybackRate< 0 && loop&& offset< actualLoopStart) { offset= actualLoopStart; } bufferTime= offset; started= true ; } // Handle loop-related calculations if ( loop) { // Determine if looped portion has been entered for the first time if ( ! enteredLoop) { if ( offset< actualLoopEnd&& bufferTime>= actualLoopStart) { // playback began before or within loop, and playhead is // now past loop start enteredLoop= true ; } if ( offset>= actualLoopEnd&& bufferTime< actualLoopEnd) { // playback began after loop, and playhead is now prior // to the loop end enteredLoop= true ; } } // Wrap loop iterations as needed. Note that enteredLoop // may become true inside the preceding conditional. if ( enteredLoop) { while ( bufferTime>= actualLoopEnd) { bufferTime-= actualLoopEnd- actualLoopStart; } while ( bufferTime< actualLoopStart) { bufferTime+= actualLoopEnd- actualLoopStart; } } } if ( bufferTime>= 0 && bufferTime< buffer. duration) { output. push( playbackSignal( bufferTime)); } else { output. push( 0 ); // past end of buffer, so output silent frame } bufferTime+= dt* computedPlaybackRate; bufferTimeElapsed+= dt* computedPlaybackRate; currentTime+= dt; } // End of render quantum loop if ( currentTime>= stop) { // End playback state of this node. No further invocations of process() // will occur. Schedule a change to set the number of output channels to 1. } return output; }
以下の非規範的な図は、さまざまな主要なシナリオにおける アルゴリズムの動作を示しています。バッファーの動的リサンプリングは 考慮されていませんが、ループ 位置の時刻が変更されない限り、結果として得られる 再生に実質的な影響はありません。すべての図では、次の規則が 適用されます:
-
コンテキストのサンプルレートは 1000 Hz
-
AudioBufferの内容は、最初のサンプルフレームを x 原点に置いて示されます。 -
出力信号は、時刻
startに位置するサンプルフレームを x 原点に置いて示されます。 -
全体を通して線形補間が示されていますが、UA は 他の補間手法を使用することもできます。
-
図に示されている
durationの値はbufferを指し、start()の引数ではありません。
この図は、バッファーの基本的な再生を示しており、 バッファー内の最後のサンプルフレームの後で終了する単純なループを使用しています:
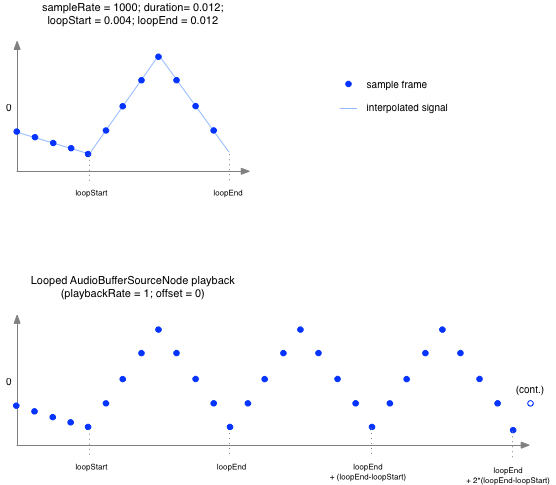
AudioBufferSourceNode
の基本的な再生
この図は playbackRate の補間を示しており、
バッファー内容を半分の速度で再生し、出力サンプルフレームの
1 つおきが補間されます。特に注目すべきなのは、
ループ出力の最後のサンプルフレームで、これは
ループ開始点を使用して補間されます:
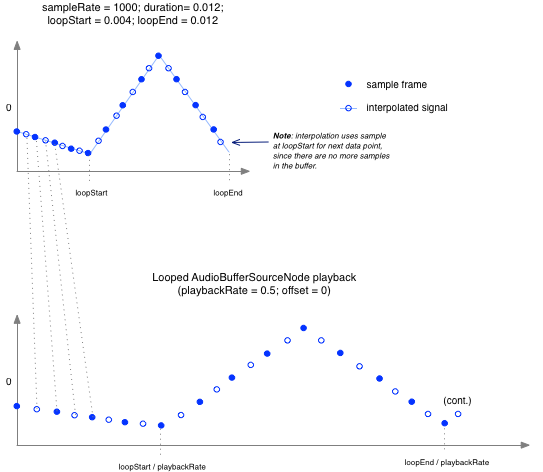
AudioBufferSourceNode
の playbackRate 補間
この図はサンプルレート補間を示しており、 サンプルレートがコンテキストのサンプルレートの 50% であるバッファーを再生し、 バッファーとコンテキストのサンプルレートの差を補正する 計算済み再生レート 0.5 になります。 結果として得られる出力は前の例と同じですが、 理由は異なります。
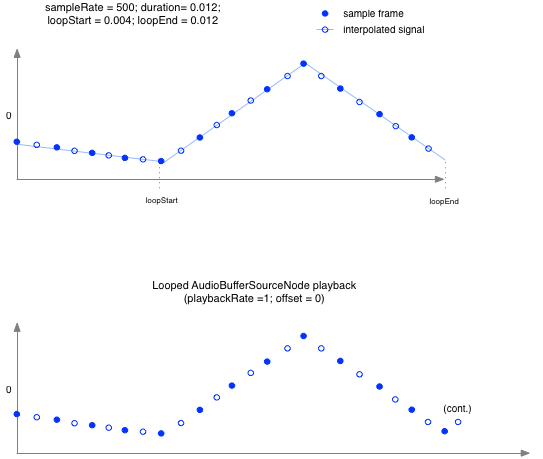
AudioBufferSourceNode
のサンプルレート補間。
この図はサブサンプルオフセット再生を示しており、 バッファー内のオフセットがサンプルフレームのちょうど半分の位置から始まります。 その結果、すべての出力フレームが補間されます:
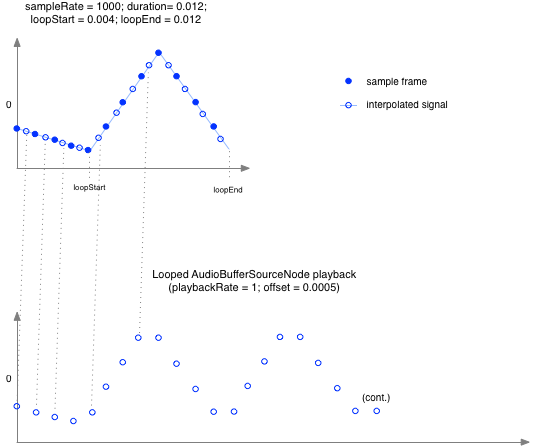
AudioBufferSourceNode
のサブサンプルオフセット再生
この図はサブサンプルループ再生を示しており、 ループ端点の小数フレームオフセットが、 それらのオフセットを正確なサンプルフレームへの参照であるかのように尊重する バッファー内の補間されたデータ点へどのように対応するかを示します:
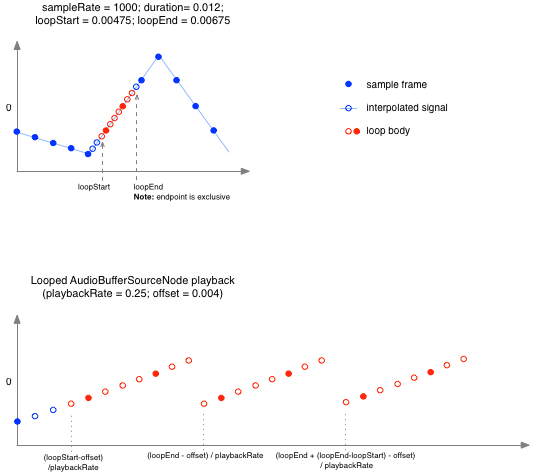
AudioBufferSourceNode
のサブサンプルループ再生
1.10.
AudioDestinationNode
インターフェイス
これは最終的なオーディオ
デスティネーションを表す AudioNode
であり、最終的にユーザーが聞くものです。多くの場合、
スピーカーに接続されたオーディオ出力デバイスと見なすことができます。
聞こえるようにレンダリングされたすべてのオーディオは、
AudioContext
のルーティング
グラフにおける「終端」ノードであるこのノードへルーティングされます。
各 AudioContext
には AudioDestinationNode が 1 つだけ存在し、
AudioContext
の destination 属性を通じて提供されます。
AudioDestinationNode
の出力は
入力を合計することで生成され、
たとえば MediaStreamAudioDestinationNode
や
MediaRecorder([mediastream-recording]で説明されています)へ、
AudioContext
の出力をキャプチャできます。
AudioDestinationNode
は、
AudioContext
または OfflineAudioContext
のデスティネーションにすることができ、
チャンネル
プロパティはコンテキストが何であるかによって異なります。
AudioContext
の場合、既定値は次のとおりです
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | いいえ |
channelCount
は、maxChannelCount
以下の任意の
値に設定できます。
この値が有効範囲内でない場合、
IndexSizeError
例外を投げなければなりません。 具体的な
例として、オーディオハードウェアが 8 チャンネル出力をサポートしている場合、
channelCount
を 8 に設定し、8
チャンネルの出力をレンダリングできます。
OfflineAudioContext
の場合、既定値は次のとおりです
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| numberOfChannels | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | いいえ |
ここで numberOfChannels は、
OfflineAudioContext
を構築するときに指定されたチャンネル数です。
この
値は変更できません。channelCount
が異なる値へ変更された場合、
NotSupportedError
例外を投げなければなりません。
[Exposed =Window ]interface AudioDestinationNode :AudioNode {readonly attribute unsigned long maxChannelCount ; };
1.10.1. 属性
maxChannelCount, 型は unsigned long、読み取り専用-
channelCount属性に設定できる チャンネルの最大数。オーディオ ハードウェアのエンドポイントを表すAudioDestinationNode(通常の場合)は、オーディオハードウェアが マルチチャンネルであれば、2 チャンネルを超えるオーディオを出力できる可能性があります。maxChannelCountは、このハードウェアがサポート可能な チャンネルの最大数です。
1.11.
AudioListener
インターフェイス
このインターフェイスは、オーディオシーンを聴いている人の
位置と向きを表します。すべての PannerNode
オブジェクトは、
BaseAudioContext
の
listener
に対して相対的に空間化されます。
空間化の詳細については、§ 6 空間化/パンニング
を参照してください。
positionX、
positionY、
および positionZ
パラメーターは、
3D デカルト座標空間におけるリスナーの位置を表します。
PannerNode
オブジェクトは、個々のオーディオソースに対するこの相対位置を
空間化に使用します。
forwardX、
forwardY、
および forwardZ
パラメーターは、
3D 空間内の方向ベクトルを表します。forward ベクトルと
up ベクトルの両方を使用して、リスナーの向きを決定します。
人間にとって分かりやすく言えば、forward ベクトルは
人の鼻がどの方向を向いているかを表します。
up ベクトルは、人の
頭頂部が向いている方向を表します。これら 2 つのベクトルは
線形独立であることが期待されます。これらの値をどのように
解釈するかに関する規範的要件については、§ 6 空間化/パンニングの節を参照してください。
[Exposed =Window ]interface AudioListener {readonly attribute AudioParam positionX ;readonly attribute AudioParam positionY ;readonly attribute AudioParam positionZ ;readonly attribute AudioParam forwardX ;readonly attribute AudioParam forwardY ;readonly attribute AudioParam forwardZ ;readonly attribute AudioParam upX ;readonly attribute AudioParam upY ;readonly attribute AudioParam upZ ;undefined setPosition (float ,x float ,y float );z undefined setOrientation (float ,x float ,y float ,z float ,xUp float ,yUp float ); };zUp
1.11.1. 属性
forwardX, 型は AudioParam、 読み取り専用-
3D デカルト座標空間においてリスナーが向いている 前方向の x 座標成分を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" forwardY, 型は AudioParam、 読み取り専用-
3D デカルト座標空間においてリスナーが向いている 前方向の y 座標成分を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" forwardZ, 型は AudioParam、 読み取り専用-
3D デカルト座標空間においてリスナーが向いている 前方向の z 座標成分を設定します。
パラメーター 値 注記 defaultValue-1 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" positionX, 型は AudioParam、 読み取り専用-
3D デカルト座標空間におけるオーディオリスナーの x 座標位置を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" positionY, 型は AudioParam、 読み取り専用-
3D デカルト座標空間におけるオーディオリスナーの y 座標位置を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" positionZ, 型は AudioParam、 読み取り専用-
3D デカルト座標空間におけるオーディオリスナーの z 座標位置を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" upX, 型は AudioParam、 読み取り専用-
3D デカルト座標空間においてリスナーが向いている 上方向の x 座標成分を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" upY, 型は AudioParam、 読み取り専用-
3D デカルト座標空間においてリスナーが向いている 上方向の y 座標成分を設定します。
パラメーター 値 注記 defaultValue1 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate" upZ, 型は AudioParam、 読み取り専用-
3D デカルト座標空間においてリスナーが向いている 上方向の z 座標成分を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"
1.11.2. メソッド
setOrientation(x, y, z, xUp, yUp, zUp)-
このメソッドは非推奨です。これは、
forwardX.value、forwardY.value、forwardZ.value、upX.value、upY.value、 およびupZ.valueを、それぞれ指定されたx、y、z、xUp、yUp、およびzUpの値に直接設定することと等価です。したがって、このメソッドが呼び出された時点で、
forwardX、forwardY、forwardZ、upX、upYおよびupZAudioParamのいずれかにsetValueCurveAtTime()を使用してオートメーションカーブが設定されている場合、NotSupportedErrorを 投げなければなりません。setOrientation()は、3D デカルト座標空間でリスナーがどの方向を向いているかを記述します。前方ベクトルと 上方ベクトルの両方が 提供されます。人間にとって分かりやすく言えば、 前方ベクトルは、人の 鼻がどの方向を向いているかを表します。上方ベクトルは、 人の頭頂部が向いている方向を表します。これら 2 つのベクトルは 線形独立であることが期待されます。これらの値をどのように解釈するかに関する 規範的要件については、§ 6 空間化/パンニングを参照してください。x、y、 およびzパラメーターは、3D 空間内の前方 方向ベクトルを表し、既定値は (0,0,-1) です。xUp、yUp、 およびzUpパラメーターは、 3D 空間内の上方方向 ベクトルを表し、既定値は (0,1,0) です。AudioListener.setOrientation() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 xfloat✘ ✘ AudioListenerの前方 x 方向yfloat✘ ✘ AudioListenerの前方 y 方向zfloat✘ ✘ AudioListenerの前方 z 方向xUpfloat✘ ✘ AudioListenerの上方 x 方向yUpfloat✘ ✘ AudioListenerの上方 y 方向zUpfloat✘ ✘ AudioListenerの上方 z 方向戻り値の型:undefined setPosition(x, y, z)-
このメソッドは非推奨です。これは、
positionX.value、positionY.value、 およびpositionZ.valueを、それぞれ指定されたx、y、およびzの値に直接設定することと等価です。したがって、この
AudioListenerのpositionX、positionY、 およびpositionZAudioParamのいずれかに、 このメソッドが呼び出された時点でsetValueCurveAtTime()を使用してオートメーションカーブが設定されている場合、NotSupportedErrorを 投げなければなりません。setPosition()は、3D デカルト座標 空間内でリスナーの位置を設定します。PannerNodeオブジェクトは、個々のオーディオソースに対するこの相対位置を 空間化に使用します。x、y、 およびzパラメーターは、3D 空間内の座標を 表します。既定値は (0,0,0) です。
AudioListener.setPosition() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 xfloat✘ ✘ AudioListenerの位置の x 座標yfloat✘ ✘ AudioListenerの位置の y 座標zfloat✘ ✘ AudioListenerの位置の z 座標
1.11.3. 処理
AudioListener
の
パラメーターは AudioNode
と接続でき、
また同じグラフ内の PannerNode の
出力にも影響を与えられるため、ノード
順序付けアルゴリズムは処理順序を
計算するときに AudioListener
を考慮するべきです。このため、
グラフ内のすべての PannerNode は
AudioListener
を入力として持ちます。
1.12.
AudioProcessingEvent
インターフェイス - 非推奨
これは
ScriptProcessorNode
ノードへ配送される Event
オブジェクトです。代替となる
AudioWorkletNode
は異なるアプローチを使用するため、
ScriptProcessorNode が削除されるときにこれも削除されます。
イベントハンドラーは、inputBuffer 属性から
オーディオデータへアクセスすることにより、入力(存在する場合)からのオーディオを処理します。
処理結果であるオーディオデータ(または
入力がない場合は合成されたデータ)は、その後
outputBuffer
に配置されます。
[Exposed =Window ]interface AudioProcessingEvent :Event {(constructor DOMString ,type AudioProcessingEventInit );eventInitDict readonly attribute double playbackTime ;readonly attribute AudioBuffer inputBuffer ;readonly attribute AudioBuffer outputBuffer ; };
1.12.1. 属性
inputBuffer, 型は AudioBuffer、 読み取り専用-
入力オーディオデータを含む AudioBuffer。これは createScriptProcessor() メソッドの
numberOfInputChannelsパラメーターと等しい チャンネル数を持ちます。この AudioBuffer は、audioprocessイベントハンドラー関数のスコープ内でのみ有効です。 このスコープ外では、その値に意味はありません。 outputBuffer, 型は AudioBuffer、 読み取り専用-
出力オーディオデータを書き込まなければならない AudioBuffer。これは createScriptProcessor() メソッドの
numberOfOutputChannelsパラメーターと等しい チャンネル数を持ちます。audioprocessイベントハンドラー関数のスコープ内のスクリプトコードは、 この AudioBuffer 内のチャンネルデータを表すFloat32Array配列を 変更することが期待されます。このスコープ外でこの AudioBuffer に対して行われた スクリプトによる変更は、可聴効果を 生じません。 playbackTime, 型は double、読み取り専用-
AudioContextのcurrentTimeと同じ時間座標系において、オーディオが再生される時刻。
1.12.2.
AudioProcessingEventInit
dictionary AudioProcessingEventInit :EventInit {required double playbackTime ;required AudioBuffer inputBuffer ;required AudioBuffer outputBuffer ; };
1.12.2.1.
AudioProcessingEventInit
辞書のメンバー
inputBuffer, 型は AudioBuffer-
イベントの
inputBuffer属性に 割り当てる値。 outputBuffer, 型は AudioBuffer-
イベントの
outputBuffer属性に 割り当てる値。 playbackTime, 型は double-
イベントの
playbackTime属性に 割り当てる値。
1.13.
BiquadFilterNode
インターフェイス
BiquadFilterNode
は、非常に一般的な低次フィルターを実装する
AudioNode
プロセッサーです。
低次フィルターは、基本的な音質調整
(低音、中音、高音)、グラフィックイコライザー、およびより高度なフィルターの構成要素です。
複数の BiquadFilterNode
フィルターを組み合わせて、
より複雑なフィルターを形成できます。frequency
などのフィルターパラメーターは、
フィルタースイープなどのために時間とともに変更できます。各
BiquadFilterNode
は、以下の IDL に示す
一般的なフィルター型のいずれかとして構成できます。既定の
フィルター型は "lowpass" です。
frequency
と detune
はどちらも
複合パラメーター
を形成し、どちらも a-rate です。これらは
computedFrequency
値を決定するために
一緒に使用されます:
computedFrequency(t) = frequency(t) * pow(2, detune(t) / 1200)
この複合パラメーターの 公称範囲は [0, ナイキスト周波数] です。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | あり | 入力が 0 でも無音ではないオーディオを出力し続けます。これは IIR フィルターであるため、 フィルターは永続的に 0 でない出力を生成しますが、実際には、出力が十分に 0 に近づいた有限時間後に制限できます。実際の時間は フィルター係数に依存します。 |
出力のチャンネル数は常に 入力のチャンネル数と等しくなります。
enum {BiquadFilterType "lowpass" ,"highpass" ,"bandpass" ,"lowshelf" ,"highshelf" ,"peaking" ,"notch" ,"allpass" };
| 列挙値 | 説明 |
|---|---|
"lowpass"
|
ローパス
フィルターは、カットオフ周波数より低い周波数を
通過させ、カットオフより高い周波数を減衰させます。
12dB/オクターブのロールオフを持つ標準的な 2 次共振ローパスフィルターを実装します。
|
"highpass"
|
ハイパス
フィルターはローパスフィルターの逆です。カットオフ周波数
より高い周波数は通過しますが、カットオフ
より低い周波数は減衰します。12dB/オクターブのロールオフを持つ
標準的な 2 次共振ハイパスフィルターを実装します。
|
"bandpass"
|
バンドパス
フィルターは、ある範囲の周波数を通過させ、
この周波数範囲より低い周波数と高い周波数を
減衰させます。2 次バンドパスフィルターを実装します。
|
"lowshelf"
|
ローシェルフフィルターはすべての周波数を通過させますが、低い
周波数にブースト(または減衰)を加えます。
2 次ローシェルフフィルターを実装します。
|
"highshelf"
|
ハイシェルフフィルターはローシェルフフィルターの逆で、
すべての周波数を通過させますが、高い
周波数にブーストを加えます。2 次ハイシェルフフィルターを実装します。
|
"peaking"
|
ピーキングフィルターはすべての周波数を通過させますが、
ある範囲の周波数にブースト(または減衰)を加えます。
|
"notch"
|
ノッチフィルター(帯域阻止または
帯域除去フィルターとも呼ばれます)は、バンドパス
フィルターの逆です。特定の
周波数を除き、すべての周波数を通過させます。
|
"allpass"
| オールパスフィルターはすべての周波数を通過させますが、 各周波数間の位相関係を変更します。 2 次オールパスフィルターを実装します。 |
BiquadFilterNode
のすべての属性は a-rate の AudioParam
です。
[Exposed =Window ]interface BiquadFilterNode :AudioNode {(constructor BaseAudioContext ,context optional BiquadFilterOptions = {});options attribute BiquadFilterType type ;readonly attribute AudioParam frequency ;readonly attribute AudioParam detune ;readonly attribute AudioParam Q ;readonly attribute AudioParam gain ;undefined getFrequencyResponse (Float32Array ,frequencyHz Float32Array ,magResponse Float32Array ); };phaseResponse
1.13.1. コンストラクター
BiquadFilterNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。BiquadFilterNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい BiquadFilterNodeが関連付けられるBaseAudioContext。optionsBiquadFilterOptions✘ ✔ この BiquadFilterNodeの省略可能な初期パラメーター値。
1.13.2. 属性
Q, 型は AudioParam、 読み取り専用-
フィルターの Q 値。
lowpassおよびhighpassフィルターでは、Q値は dB 単位として解釈されます。 これらのフィルターの公称範囲は \([-Q_{lim}, Q_{lim}]\) であり、ここで \(Q_{lim}\) は \(10^{Q/20}\) がオーバーフローしない最大の 値です。これはおよそ \(770.63678\) です。bandpass、notch、allpass、 およびpeakingフィルターでは、この値は 線形値です。この値はフィルターの帯域幅に 関係するため、正の値であるべきです。 公称範囲は \([0, 3.4028235e38]\) で、上限は 最も正の単精度浮動小数点数です。これは
lowshelfおよびhighshelfフィルターでは使用されません。パラメーター 値 注記 defaultValue1 minValue最も負の単精度浮動小数点数 約 -3.4028235e38。ただし、フィルターごとの実際の制限については上記を 参照してください maxValue最も正の単精度浮動小数点数 約 3.4028235e38。ただし、フィルターごとの実際の制限については上記を 参照してください automationRate" a-rate" detune, 型は AudioParam、 読み取り専用-
周波数に対するセント単位のデチューン値。これは
frequencyと複合 パラメーターを形成し、 computedFrequency を形成します。パラメーター 値 注記 defaultValue0 minValue\(\approx -153600\) maxValue\(\approx 153600\) この値はおよそ \(1200\ \log_2 \mathrm{FLT\_MAX}\) であり、FLT_MAX は 最大の float値です。automationRate" a-rate" frequency, 型は AudioParam、 読み取り専用-
BiquadFilterNodeが動作する周波数(Hz)。これはdetuneと複合パラメーターを形成し、 computedFrequency を形成します。パラメーター 値 注記 defaultValue350 minValue0 maxValueナイキスト周波数 automationRate" a-rate" gain, 型は AudioParam、 読み取り専用-
フィルターのゲイン。その値は dB 単位です。ゲインは
lowshelf、highshelf、 およびpeakingフィルターでのみ使用されます。パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue\(\approx 1541\) この値はおよそ \(40\ \log_{10} \mathrm{FLT\_MAX}\) であり、FLT_MAX は 最大の float値です。automationRate" a-rate" type, 型は BiquadFilterType-
この
BiquadFilterNodeの型。その 既定値は "lowpass" です。 その他のパラメーターの正確な意味は、type属性の値によって異なります。
1.13.3. メソッド
getFrequencyResponse(frequencyHz, magResponse, phaseResponse)-
各フィルターパラメーターの
[[current value]]が与えられると、指定された周波数について 周波数応答を同期的に計算します。3 つのパラメーターは 同じ長さのFloat32Arrayでなければならず、そうでない場合はInvalidAccessErrorを投げなければなりません。返される周波数応答は、現在の 処理ブロックについてサンプリングされた
AudioParamを使用して計算しなければなりません。BiquadFilterNode.getFrequencyResponse() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 frequencyHzFloat32Array✘ ✘ このパラメーターは、応答値を計算する周波数の配列を Hz 単位で指定します。 magResponseFloat32Array✘ ✘ このパラメーターは、線形振幅応答値を受け取る出力配列を指定します。 frequencyHzパラメーター内の値が [0, sampleRate/2] の範囲内でない場合、 ここでsampleRateはsampleRateプロパティの値であり、そのAudioContextに対応するmagResponse配列の同じインデックスの値はNaNでなければなりません。phaseResponseFloat32Array✘ ✘ このパラメーターは、ラジアン単位の位相応答値を受け取る出力配列を指定します。 frequencyHzパラメーター内の値が [0; sampleRate/2] の範囲内でない場合、 ここでsampleRateはsampleRateプロパティの値であり、そのAudioContextに対応するphaseResponse配列の同じインデックスの値はNaNでなければなりません。戻り値の型:undefined
1.13.4.
BiquadFilterOptions
これは BiquadFilterNode
を構築するときに使用するオプションを指定します。
すべてのメンバーは省略可能です。指定されない場合、
通常の既定値を使用してノードが構築されます。
dictionary BiquadFilterOptions :AudioNodeOptions {BiquadFilterType type = "lowpass";float Q = 1;float detune = 0;float frequency = 350;float gain = 0; };
1.13.4.1.
BiquadFilterOptions
辞書のメンバー
Q, 型は float、既定値は1-
Qに対する望ましい初期値。 detune, 型は float、既定値は0-
detuneに対する望ましい初期値。 frequency, 型は float、既定値は350-
frequencyに対する望ましい初期値。 gain, 型は float、既定値は0-
gainに対する望ましい初期値。 type, 型は BiquadFilterType、既定値は"lowpass"-
フィルターの望ましい初期型。
1.13.5. フィルター特性
BiquadFilterNode
を通じて利用可能な種類のフィルターを実装する方法は複数あり、
それぞれ非常に異なる特性を持ちます。この節の数式は、
異なるフィルター型の特性を決定するため、
適合実装が実装しなければならない
フィルターを記述します。これらは
Audio EQ Cookbook
にある数式から着想を得ています。
BiquadFilterNode
は次の伝達関数でオーディオを処理します
$$
 H(z) = \frac{\frac{b_0}{a_0} + \frac{b_1}{a_0}z^{-1} + \frac{b_2}{a_0}z^{-2}}
                                           {1+\frac{a_1}{a_0}z^{-1}+\frac{a_2}{a_0}z^{-2}}
$$
これは次の時間領域方程式と等価です:
$$
a_0 y(n) + a_1 y(n-1) + a_2 y(n-2) =
    b_0 x(n) + b_1 x(n-1) + b_2 x(n-2)
$$
フィルターの初期状態は 0 です。
注: 固定フィルターは安定していますが、
AudioParam
のオートメーションを使用すると、不安定なバイクアッドフィルターを作成することが
可能です。これを管理することは
開発者の責任です。
注: UA は、フィルター状態で NaN 値が発生したことを ユーザーに通知する警告を生成してもかまいません。これは通常、不安定なフィルターを示しています。
上記の伝達関数の係数は、
ノード型ごとに異なります。これらを計算するには、
BiquadFilterNode
の AudioParam
の computedValue に基づいて、
次の中間変数が必要です。
-
\(F_s\) を、この
AudioContextのsampleRate属性の値とします。 -
\(f_0\) を computedFrequency の値とします。
-
\(G\) を
gainAudioParamの値とします。 -
\(Q\) を
QAudioParamの値とします。 -
最後に次のようにします
$$
\begin{align*}
    A &= 10^{\frac{G}{40}} \\
    \omega_0 &= 2\pi\frac{f_0}{F_s} \\
    \alpha_Q &= \frac{\sin\omega_0}{2Q} \\
    \alpha_{Q_{dB}} &= \frac{\sin\omega_0}{2 \cdot 10^{Q/20}} \\
    S &= 1 \\
    \alpha_S &= \frac{\sin\omega_0}{2}\sqrt{\left(A+\frac{1}{A}\right)\left(\frac{1}{S}-1\right)+2}
\end{align*}
$$
各フィルター型の 6 つの係数 (\(b_0, b_1, b_2, a_0, a_1, a_2\))は次のとおりです:
- "
lowpass" -
$$ \begin{align*} b_0 &= \frac{1 - \cos\omega_0}{2} \\ b_1 &= 1 - \cos\omega_0 \\ b_2 &= \frac{1 - \cos\omega_0}{2} \\ a_0 &= 1 + \alpha_{Q_{dB}} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_{Q_{dB}} \end{align*} $$ - "
highpass" -
$$ \begin{align*} b_0 &= \frac{1 + \cos\omega_0}{2} \\ b_1 &= -(1 + \cos\omega_0) \\ b_2 &= \frac{1 + \cos\omega_0}{2} \\ a_0 &= 1 + \alpha_{Q_{dB}} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_{Q_{dB}} \end{align*} $$ - "
bandpass" -
$$ \begin{align*} b_0 &= \alpha_Q \\ b_1 &= 0 \\ b_2 &= -\alpha_Q \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
notch" -
$$ \begin{align*} b_0 &= 1 \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
allpass" -
$$ \begin{align*} b_0 &= 1 - \alpha_Q \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 + \alpha_Q \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
peaking" -
$$ \begin{align*} b_0 &= 1 + \alpha_Q\, A \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 - \alpha_Q\,A \\ a_0 &= 1 + \frac{\alpha_Q}{A} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \frac{\alpha_Q}{A} \end{align*} $$ - "
lowshelf" -
$$ \begin{align*} b_0 &= A \left[ (A+1) - (A-1) \cos\omega_0 + 2 \alpha_S \sqrt{A})\right] \\ b_1 &= 2 A \left[ (A-1) - (A+1) \cos\omega_0 )\right] \\ b_2 &= A \left[ (A+1) - (A-1) \cos\omega_0 - 2 \alpha_S \sqrt{A}) \right] \\ a_0 &= (A+1) + (A-1) \cos\omega_0 + 2 \alpha_S \sqrt{A} \\ a_1 &= -2 \left[ (A-1) + (A+1) \cos\omega_0\right] \\ a_2 &= (A+1) + (A-1) \cos\omega_0 - 2 \alpha_S \sqrt{A}) \end{align*} $$ - "
highshelf" -
$$
    \begin{align*}
        b_0 &= A\left[ (A+1) + (A-1)\cos\omega_0 + 2\alpha_S\sqrt{A} )\right] \\
        b_1 &= -2A\left[ (A-1) + (A+1)\cos\omega_0 )\right] \\
        b_2 &= A\left[ (A+1) + (A-1)\cos\omega_0 - 2\alpha_S\sqrt{A} )\right] \\
        a_0 &= (A+1) - (A-1)\cos\omega_0 + 2\alpha_S\sqrt{A} \\
        a_1 &= 2\left[ (A-1) - (A+1)\cos\omega_0\right] \\
        a_2 &= (A+1) - (A-1)\cos\omega_0 - 2\alpha_S\sqrt{A}
    \end{align*}
$$
1.14.
ChannelMergerNode
インターフェイス
ChannelMergerNode
は、より高度な
アプリケーションで使用するためのもので、多くの場合
ChannelSplitterNode
と組み合わせて使用されます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 注記を参照 | 既定値は 6 ですが、ChannelMergerOptions
の numberOfInputs
または createChannelMerger
で指定された値によって決定されます。
|
numberOfOutputs
| 1 | |
channelCount
| 1 | channelCount 制約があります |
channelCountMode
| "explicit"
| channelCountMode 制約があります |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
このインターフェイスは、複数のオーディオストリームのチャンネルを
単一のオーディオストリームへ結合するための AudioNode
を表します。入力数は可変(既定値は 6)ですが、
すべてを接続する必要はありません。出力は 1 つで、
いずれかの入力がアクティブに処理中の場合、
そのオーディオストリームのチャンネル数は入力数と等しくなります。
どの入力もアクティブに
処理中でない場合、出力は 1 チャンネルの無音です。
複数の入力を 1 つのストリームへ結合するため、 各入力は指定されたミキシング規則に基づいて 1 チャンネル(モノラル)へダウンミックスされます。 未接続の入力も、出力では1 つの無音チャンネルとして数えられます。 入力ストリームを変更しても、出力チャンネルの順序には 影響しません。
ChannelMergerNode
に
2 つの接続されたステレオ入力がある場合、第 1 および第 2 入力は
結合前にそれぞれモノラルへダウンミックスされます。出力は
6 チャンネルストリームとなり、最初の 2 チャンネルには
最初の 2 つの(ダウンミックスされた)入力が入り、残りのチャンネルは無音になります。
また、ChannelMergerNode
は、5.1 サラウンド構成などのマルチチャンネル
スピーカー配列向けに、複数のオーディオストリームを特定の順序で
配置するためにも使用できます。マージャーは
チャンネルの意味(左、右など)を解釈せず、
入力された順序で単純にチャンネルを結合します。

[Exposed =Window ]interface ChannelMergerNode :AudioNode {constructor (BaseAudioContext ,context optional ChannelMergerOptions = {}); };options
1.14.1. コンストラクター
ChannelMergerNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。ChannelMergerNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい ChannelMergerNodeが関連付けられるBaseAudioContext。optionsChannelMergerOptions✘ ✔ この ChannelMergerNodeの省略可能な初期パラメーター値。
1.14.2.
ChannelMergerOptions
dictionary ChannelMergerOptions :AudioNodeOptions {unsigned long numberOfInputs = 6; };
1.14.2.1.
ChannelMergerOptions
辞書のメンバー
numberOfInputs, 型は unsigned long、既定値は6-
ChannelMergerNodeの入力数。 この値の制約についてはcreateChannelMerger()を参照してください。
1.15.
ChannelSplitterNode
インターフェイス
ChannelSplitterNode
は、より高度な
アプリケーションで使用するためのもので、多くの場合
ChannelMergerNode
と組み合わせて使用されます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 注記を参照 | 既定値は 6 ですが、それ以外の場合は ChannelSplitterOptions.numberOfOutputs
または createChannelSplitter
で指定された値、あるいは
numberOfOutputs
メンバーを持つ ChannelSplitterOptions
辞書の constructor
によって決定されます。
|
channelCount
| numberOfOutputs
| channelCount 制約があります |
channelCountMode
| "explicit"
| channelCountMode 制約があります |
channelInterpretation
| "discrete"
| channelInterpretation 制約があります |
| テールタイム | なし |
このインターフェイスは、ルーティンググラフ内の
オーディオストリームの個々のチャンネルへアクセスするための AudioNode
を表します。入力は 1 つで、「アクティブ」な出力数は
入力オーディオストリームのチャンネル数と等しくなります。たとえば、
ステレオ入力が
ChannelSplitterNode
に接続されている場合、アクティブな
出力数は 2(左チャンネルから 1 つ、右チャンネルから
1 つ)になります。常に合計 N 個の出力が存在し(
AudioContext
の createChannelSplitter()
メソッドに渡される numberOfOutputs パラメーターによって決定されます)、
この値が指定されない場合の既定数は 6 です。「アクティブ」でない出力は
無音を出力し、通常は
何にも接続されません。
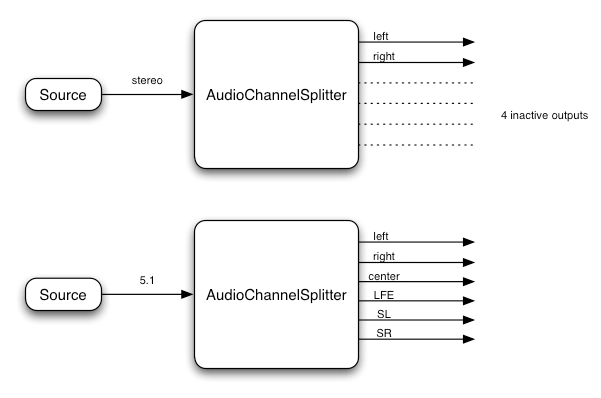
ChannelSplitterNode
の用途の 1 つは、
各チャンネルの個別のゲイン制御が必要な「マトリックスミキシング」です。
[Exposed =Window ]interface ChannelSplitterNode :AudioNode {constructor (BaseAudioContext ,context optional ChannelSplitterOptions = {}); };options
1.15.1. コンストラクター
ChannelSplitterNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。ChannelSplitterNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい ChannelSplitterNodeが関連付けられるBaseAudioContext。optionsChannelSplitterOptions✘ ✔ この ChannelSplitterNodeの省略可能な初期パラメーター値。
1.15.2.
ChannelSplitterOptions
dictionary ChannelSplitterOptions :AudioNodeOptions {unsigned long numberOfOutputs = 6; };
1.15.2.1.
ChannelSplitterOptions
辞書のメンバー
numberOfOutputs, 型は unsigned long、既定値は6-
ChannelSplitterNodeの出力数。 この値の制約についてはcreateChannelSplitter()を参照してください。
1.16.
ConstantSourceNode
インターフェイス
このインターフェイスは、出力が
公称的に一定値である定値オーディオソースを表します。一般的な定値ソースノードとして
有用であり、その
offset
を自動化するか、別のノードを接続することで、構築可能な
AudioParam
であるかのように使用できます。
このノードの単一の出力は 1 チャンネル(モノラル)で構成されます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
[Exposed =Window ]interface ConstantSourceNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional ConstantSourceOptions = {});options readonly attribute AudioParam offset ; };
1.16.1. コンストラクター
ConstantSourceNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。ConstantSourceNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい ConstantSourceNodeが関連付けられるBaseAudioContext。optionsConstantSourceOptions✘ ✔ この ConstantSourceNodeの省略可能な初期パラメーター値。
1.16.2. 属性
offset, 型は AudioParam、 読み取り専用-
ソースの定値。
パラメーター 値 注記 defaultValue1 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"
1.16.3.
ConstantSourceOptions
これは
ConstantSourceNode
を構築するためのオプションを指定します。
すべてのメンバーは省略可能です。
指定されない場合、通常の既定値を使用して
ノードが構築されます。
dictionary ConstantSourceOptions {float offset = 1; };
1.16.3.1.
ConstantSourceOptions
辞書のメンバー
offset, 型は float、既定値は1-
このノードの
offsetAudioParam の初期値。
1.17.
ConvolverNode
インターフェイス
このインターフェイスは、インパルス応答を与えて線形 畳み込みエフェクトを適用する処理ノードを表します。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 制約があります |
channelCountMode
| "clamped-max"
| channelCountMode 制約があります |
channelInterpretation
| "speakers"
| |
| テールタイム | あり | buffer
の長さの間、入力が 0 でも無音ではないオーディオを出力し続けます。
|
このノードの入力はモノラル(1 チャンネル)またはステレオ(2 チャンネル)のいずれかで、これを増やすことはできません。より多くの チャンネルを持つノードからの接続は適切にダウンミックスされます。
このノードには channelCount 制約と channelCountMode 制約があります。これらの制約により、 ノードへの入力がモノラルまたはステレオのいずれかになることが保証されます。
[Exposed =Window ]interface ConvolverNode :AudioNode {constructor (BaseAudioContext ,context optional ConvolverOptions = {});options attribute AudioBuffer ?buffer ;attribute boolean normalize ; };
1.17.1. コンストラクター
ConvolverNode(context, options)-
コンストラクターが
BaseAudioContextcontext と オプションオブジェクト options を指定して呼び出されたとき、次の手順を実行します:-
normalize属性を、disableNormalizationの値の反転値に設定します。 -
bufferが存在する場合、buffer属性をその値に設定します。注: これは、バッファーが
normalize属性の値に従って正規化されることを意味します。 -
o を新しい
AudioNodeOptions辞書とします。 -
options 内に
channelCountが存在する場合、 o 上のchannelCountを同じ値に設定します。 -
options 内に
channelCountModeが存在する場合、 o 上のchannelCountModeを同じ値に設定します。 -
options 内に
channelInterpretationが存在する場合、 o 上のchannelInterpretationを同じ値に設定します。 -
c と o を引数として、 this の AudioNode を 初期化します。
ConvolverNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい ConvolverNodeが関連付けられるBaseAudioContext。optionsConvolverOptions✘ ✔ この ConvolverNodeの省略可能な初期パラメーター値。 -
1.17.2. 属性
buffer, 型は AudioBuffer、 null 許容-
この属性が設定された時点で、
bufferとnormalize属性の状態を使用して、 指定された正規化を適用したこのインパルス応答でConvolverNodeを構成します。この属性の初期値は null です。buffer attributeを設定するとき、次の 手順を同期的に実行します:-
バッファーの
number of channelsが 1、2、4 のいずれでもない場合、または バッファーのsample-rateが、それに関連付けられたBaseAudioContextのsample-rateと同じでない場合、NotSupportedErrorを投げなければなりません。 -
AudioBufferの内容を取得します。
注:
bufferが新しいバッファーに設定されると、 オーディオにグリッチが発生する可能性があります。これが望ましくない場合は、 古いものを置き換える新しいConvolverNodeを作成し、 必要に応じて 2 つの間でクロスフェードすることが推奨されます。注:
ConvolverNodeがモノラル出力を生成するのは、 入力チャンネルが 1 つで、 1 チャンネルのbufferがある場合だけです。 それ以外のすべての場合、 出力はステレオです。特に、bufferが 4 チャンネルで入力が 2 チャンネルの場合、ConvolverNodeはマトリックス「トゥルー」ステレオ 畳み込みを実行します。規範的な情報については、 チャンネル 構成図を参照してください。 -
normalize, 型は boolean-
buffer属性が設定されたときに、バッファーからのインパルス応答を 等電力正規化によってスケーリングするかどうかを制御します。 多様なインパルス応答を読み込んだときにコンボルバーから より均一な出力レベルを得るため、既定値はtrueです。normalizeがfalseに設定された場合、畳み込みは インパルス応答を前処理/スケーリングせずにレンダリングされます。 この値への変更は、次にbuffer属性が設定されるまで有効になりません。buffer属性が設定されたとき、normalize属性が false の場合、ConvolverNodeはbuffer内に含まれる正確なインパルス応答を使用して 線形畳み込みを実行します。それ以外で、
buffer属性が設定されたとき、normalize属性が true の場合、ConvolverNodeはまずbuffer内のオーディオデータについてスケーリングされた RMS パワー解析を実行し、次のアルゴリズムによって normalizationScale を計算します:function calculateNormalizationScale( buffer) { const GainCalibration= 0.00125 ; const GainCalibrationSampleRate= 44100 ; const MinPower= 0.000125 ; // RMS パワーで正規化する。 const numberOfChannels= buffer. numberOfChannels; const length= buffer. length; let power= 0 ; for ( let i= 0 ; i< numberOfChannels; i++ ) { let channelPower= 0 ; const channelData= buffer. getChannelData( i); for ( let j= 0 ; j< length; j++ ) { const sample= channelData[ j]; channelPower+= sample* sample; } power+= channelPower; } power= Math. sqrt( power/ ( numberOfChannels* length)); // 偶発的なオーバーロードを防ぐ。 if ( ! isFinite( power) || isNaN( power) || power< MinPower) power= MinPower; let scale= 1 / power; // 知覚音量が未処理時と同じになるよう較正する。 scale*= GainCalibration; // スケールはサンプルレートに依存する。 if ( buffer. sampleRate) scale*= GainCalibrationSampleRate/ buffer. sampleRate; // トゥルーステレオ補正。 if ( numberOfChannels== 4 ) scale*= 0.5 ; return scale; } 処理中、ConvolverNode はこの 計算済みの normalizationScale 値を取り、 入力をインパルス応答(
bufferで表されます)で処理して得られる線形畳み込みの結果に乗算して、 最終出力を生成します。または、 入力に normalizationScale をあらかじめ乗算する、 あるいはインパルス応答のバージョンに normalizationScale をあらかじめ乗算するなど、 数学的に等価な任意の演算を使用できます。
1.17.3.
ConvolverOptions
これは
ConvolverNode
を構築するためのオプションを指定します。
すべてのメンバーは省略可能です。指定されない場合、
ノードは通常の既定値を使用して構築されます。
dictionary ConvolverOptions :AudioNodeOptions {AudioBuffer ?buffer ;boolean disableNormalization =false ; };
1.17.3.1.
ConvolverOptions
辞書のメンバー
buffer, 型は AudioBuffer、 null 許容-
ConvolverNodeに望ましいバッファー。 このバッファーはdisableNormalizationの値に従って正規化されます。 disableNormalization, 型は boolean、既定値はfalse-
ConvolverNodeのnormalize属性に対する望ましい初期値の反対値。
1.17.4. 入力、インパルス応答、および出力のチャンネル構成
実装は、1 または 2 チャンネルの入力でさまざまなリバーブ効果を
実現するため、ConvolverNode
における次の許容されるインパルス応答チャンネル構成を
サポートしなければなりません。
下の図に示すように、単一チャンネル畳み込みは
モノラルオーディオ入力に対して動作し、モノラルインパルス応答を使用して、
モノラル出力を生成します。図の残りの
画像は、入力のチャンネル数が 1 または 2 で、
buffer
のチャンネル数が 1、2、または 4 の場合にサポートされる
モノラルおよびステレオ再生のケースを示しています。
より複雑で任意のマトリックス処理を必要とする開発者は、
ChannelSplitterNode、
複数の単一チャンネル
ConvolverNode
および
ChannelMergerNode
を使用できます。
このノードがアクティブに処理中でない場合、出力は 1 チャンネルの無音です。
注: 下の図は、アクティブに 処理中の場合の出力を示しています。
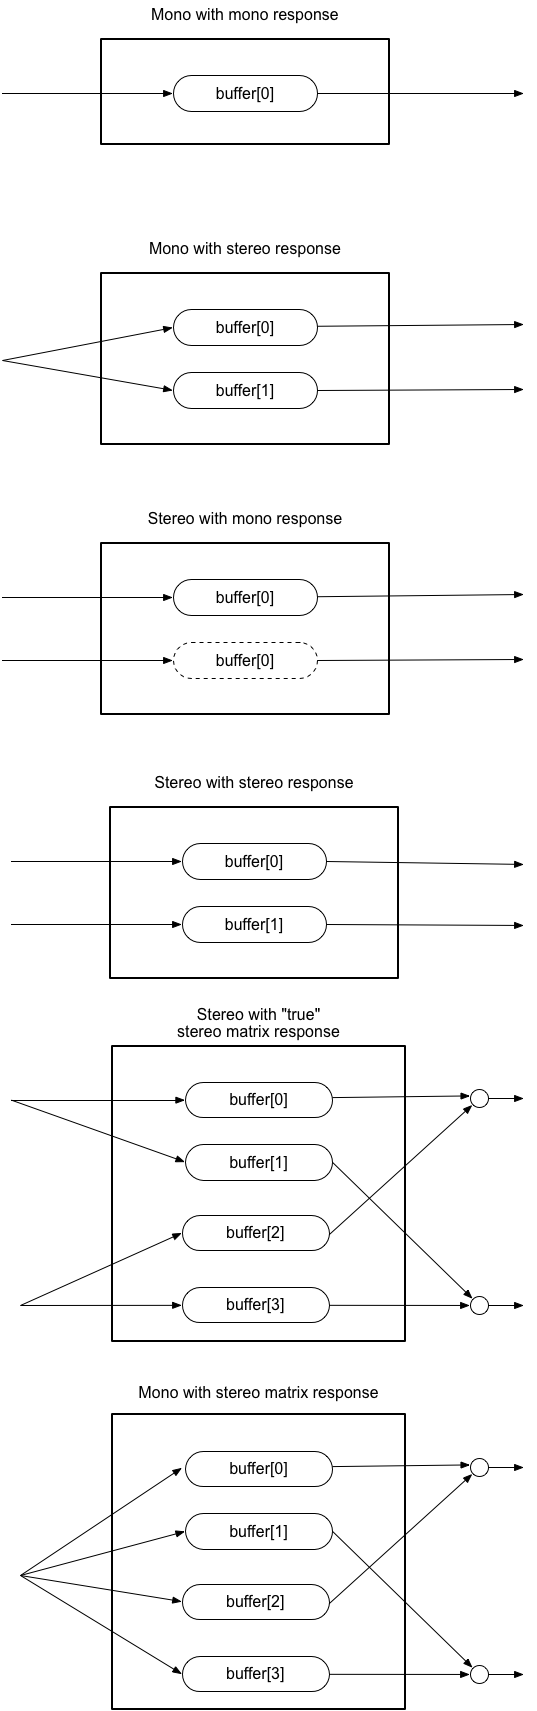
ConvolverNode
を使用するときにサポートされる入力および出力チャンネル数の
組み合わせを図示したもの。
1.18.
DelayNode
インターフェイス
ディレイラインはオーディオアプリケーションにおける基本的な構成要素です。
このインターフェイスは、1 つの
入力と 1 つの出力を持つ AudioNode
です。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | あり | ノードの maxDelayTime
まで、入力が 0 でも無音ではないオーディオを出力し続けます。
|
出力のチャンネル数は常に 入力のチャンネル数と等しくなります。
入力オーディオ信号を一定量遅延させます。
具体的には、各時刻 t において、入力信号
input(t)、遅延時間 delayTime(t)、出力信号
output(t) に対して、出力は output(t) = input(t -
delayTime(t)) となります。既定の delayTime は 0 秒
(遅延なし)です。
DelayNode
の入力のチャンネル数が変更されると
(したがって出力チャンネル数も変更されると)、
まだノードから出力されておらず、
内部状態の一部である遅延済みオーディオサンプルが存在する可能性があります。
これらのサンプルが以前に異なるチャンネル数で受信されていた場合、
新しく受信した入力と結合する前に
アップミックスまたはダウンミックスしなければならず、
すべての内部ディレイラインミキシングが単一の現在有効なチャンネル
レイアウトを使用して行われるようにしなければなりません。
注: 定義上、DelayNode
は遅延量と等しいオーディオ処理
レイテンシーを導入します。
[Exposed =Window ]interface DelayNode :AudioNode {constructor (BaseAudioContext ,context optional DelayOptions = {});options readonly attribute AudioParam delayTime ; };
1.18.1. コンストラクター
DelayNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。DelayNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい DelayNodeが関連付けられるBaseAudioContext。optionsDelayOptions✘ ✔ この DelayNodeの省略可能な初期パラメーター値。
1.18.2. 属性
delayTime, 型は AudioParam、 読み取り専用-
適用する遅延量(秒)を表す
AudioParamオブジェクトです。既定のvalueは 0(遅延なし)です。最小値は 0 で、 最大値はAudioContextのcreateDelay()メソッドへのmaxDelayTime引数、またはコンストラクター用のDelayOptions辞書のmaxDelayTimeメンバーによって決定されます。DelayNodeが循環の一部である場合、delayTime属性の値は、最小で 1 レンダー量子にクランプされます。パラメーター 値 注記 defaultValue0 minValue0 maxValuemaxDelayTimeautomationRate" a-rate"
1.18.3.
DelayOptions
これは
DelayNode
を構築するためのオプションを指定します。
すべてのメンバーは省略可能です。指定されない場合、
ノードは通常の既定値を使用して構築されます。
dictionary DelayOptions :AudioNodeOptions {double maxDelayTime = 1;double delayTime = 0; };
1.18.3.1.
DelayOptions
辞書のメンバー
delayTime, 型は double、既定値は0-
ノードの初期遅延時間。
maxDelayTime, 型は double、既定値は1-
ノードの最大遅延時間。制約については
createDelay(maxDelayTime)を参照してください。
1.18.4. 処理
DelayNode
は delayTime
秒分のオーディオを保持する内部バッファーを持ちます。
DelayNode
の処理は
2 つの部分に分かれます。ディレイラインへの書き込みと、
ディレイラインからの読み取りです。これは 2 つの内部
AudioNode
(作者からは利用できず、
ノードの内部動作の説明を簡単にするためだけに存在します)を介して行われます。
どちらも DelayNode
から作成されます。
DelayNode
に対して DelayWriter を作成するとは、
AudioNode
と同じインターフェイスを持ち、
入力オーディオを DelayNode
の内部バッファーへ書き込むオブジェクトを作成することを意味します。
これは、作成元の DelayNode
と同じ入力接続を持ちます。
DelayNode
に対して DelayReader を作成するとは、
AudioNode
と同じインターフェイスを持ち、
DelayNode
の内部バッファーからオーディオデータを読み取れるオブジェクトを作成することを意味します。
これは、作成元の DelayNode
と同じ AudioNode
に接続されます。DelayReader は
ソースノードです。
入力バッファーを処理するとき、DelayWriter はオーディオを
DelayNode
の内部バッファーへ書き込まなければなりません。
出力バッファーを生成するとき、DelayReader は、
対応する DelayWriter に
delayTime
秒前に書き込まれたオーディオを正確に生成しなければなりません。
注: これは、チャンネル数の変更が 遅延時間の経過後に 反映されることを意味します。
1.19.
DynamicsCompressorNode
インターフェイス
DynamicsCompressorNode
は、ダイナミクス
圧縮エフェクトを実装する AudioNode
プロセッサーです。
ダイナミクス圧縮は、音楽制作や ゲームオーディオで非常によく使用されます。信号の最も大きい部分の音量を下げ、 最も小さい部分の音量を上げます。全体として、より大きく、 豊かで、厚みのある音を実現できます。特に、 多数の個別のサウンドを同時に再生するゲームや音楽アプリケーションで、 全体の信号レベルを制御し、 スピーカーへのオーディオ出力のクリッピング(歪み)を避けるために 重要です。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 制約があります |
channelCountMode
| "clamped-max"
| channelCountMode 制約があります |
channelInterpretation
| "speakers"
| |
| テールタイム | あり | このノードには、ルックアヘッド遅延により、 入力が 0 でも無音ではないオーディオを出力し続ける テールタイムがあります。 |
[Exposed =Window ]interface DynamicsCompressorNode :AudioNode {constructor (BaseAudioContext ,context optional DynamicsCompressorOptions = {});options readonly attribute AudioParam threshold ;readonly attribute AudioParam knee ;readonly attribute AudioParam ratio ;readonly attribute float reduction ;readonly attribute AudioParam attack ;readonly attribute AudioParam release ; };
1.19.1. コンストラクター
DynamicsCompressorNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。[[internal reduction]]を this 上のプライベートスロットとし、 デシベル単位の浮動小数点数を保持します。[[internal reduction]]を 0.0 に設定します。DynamicsCompressorNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい DynamicsCompressorNodeが関連付けられるBaseAudioContext。optionsDynamicsCompressorOptions✘ ✔ この DynamicsCompressorNodeの省略可能な初期パラメーター値。
1.19.2. 属性
attack, 型は AudioParam、 読み取り専用-
ゲインを 10dB 減少させるのにかかる時間(秒)。
パラメーター 値 注記 defaultValue.003 minValue0 maxValue1 automationRate" k-rate"オートメーションレート 制約があります knee, 型は AudioParam、読み取り専用-
しきい値を超えて、カーブが「ratio」部分へ 滑らかに遷移する範囲を表すデシベル値。
パラメーター 値 注記 defaultValue30 minValue0 maxValue40 automationRate" k-rate"オートメーションレート 制約があります ratio, 型は AudioParam、 読み取り専用-
出力が 1 dB 変化するために必要な入力の dB 変化量。
パラメーター 値 注記 defaultValue12 minValue1 maxValue20 automationRate" k-rate"オートメーションレート 制約があります reduction, 型は float、読み取り専用-
メータリング用途の読み取り専用デシベル値で、 コンプレッサーが現在信号に適用している ゲインリダクション量を表します。信号が入力されていない場合、 値は 0(ゲインリダクションなし)になります。この属性を読み取ると、 プライベートスロット
[[internal reduction]]の値を返します。 release, 型は AudioParam、 読み取り専用-
ゲインを 10dB 増加させるのにかかる時間(秒)。
パラメーター 値 注記 defaultValue.25 minValue0 maxValue1 automationRate" k-rate"オートメーションレート 制約があります threshold, 型は AudioParam、 読み取り専用-
これを超えると圧縮が効果を発揮し始めるデシベル値。
パラメーター 値 注記 defaultValue-24 minValue-100 maxValue0 automationRate" k-rate"オートメーションレート 制約があります
1.19.3.
DynamicsCompressorOptions
これは
DynamicsCompressorNode
を構築するときに使用するオプションを指定します。すべてのメンバーは
省略可能です。指定されない場合、通常の既定値を使用して
ノードが構築されます。
dictionary DynamicsCompressorOptions :AudioNodeOptions {float attack = 0.003;float knee = 30;float ratio = 12;float release = 0.25;float threshold = -24; };
1.19.3.1.
DynamicsCompressorOptions
辞書のメンバー
attack, 型は float、既定値は0.003-
attackAudioParam の初期値。 knee, 型は float、既定値は30-
kneeAudioParam の初期値。 ratio, 型は float、既定値は12-
ratioAudioParam の初期値。 release, 型は float、既定値は0.25-
releaseAudioParam の初期値。 threshold, 型は float、既定値は-24-
thresholdAudioParam の初期値。
1.19.4. 処理
ダイナミクス圧縮はさまざまな方法で実装できます。
DynamicsCompressorNode
は、次の特性を持つ
ダイナミクスプロセッサーを実装します:
-
固定ルックアヘッド(これは
DynamicsCompressorNodeが信号チェーンに固定のレイテンシーを 加えることを意味します)。 -
構成可能なアタック速度、リリース速度、しきい値、ニーの 硬さ、およびレシオ。
-
サイドチェインはサポートされません。
-
ゲインリダクションは、
DynamicsCompressorNodeのreductionプロパティを介して報告されます。 -
圧縮カーブは 3 つの部分からなります:
-
第 1 部分は恒等関数です: \(f(x) = x\)。
-
第 2 部分はソフトニー部分で、単調増加関数で なければなりません。
-
第 3 部分は線形関数です: \(f(x) = \frac{1}{ratio} \cdot x \)。
このカーブは連続かつ区分的に微分可能でなければならず、 入力レベルに基づく目標出力レベルに 対応します。
-
グラフで表すと、このようなカーブはおおよそ次のようになります:

内部的には、DynamicsCompressorNode
は、ゲインリダクション値を計算するための
特別なアルゴリズムとともに、他の AudioNode
の組み合わせで記述されます。
次の AudioNode
グラフが内部で使用されます。
input と output はそれぞれ入力および出力の AudioNode、
context はこの
DynamicsCompressorNode
の BaseAudioContext、
そして新しいクラス EnvelopeFollower は、
以下で説明する AudioNode
のように動作する特殊なオブジェクトを
インスタンス化します:
const delay = new DelayNode(context, {delayTime: 0.006});
const gain = new GainNode(context);
const compression = new EnvelopeFollower();

input.connect(delay).connect(gain).connect(output);
input.connect(compression).connect(gain.gain);

DynamicsCompressorNode
の処理アルゴリズムの一部として使用される内部 AudioNode
のグラフ。
注: これはプリディレイと リダクションゲインの適用を実装します。
次のアルゴリズムは、入力 信号に適用してゲインリダクション値を生成する EnvelopeFollower オブジェクトが 行う処理を記述します。 EnvelopeFollower は、浮動小数点 値を保持する 2 つのスロットを持ちます。これらの値はこのアルゴリズムの呼び出し間でも保持されます。
-
[[detector average]]を、 0.0 で初期化された浮動小数点 数とします。 -
[[compressor gain]]を、 1.0 で初期化された浮動小数点 数とします。
-
attack と release を、それぞれ処理時に サンプリングされた
attackとreleaseの値(これらは k-rate パラメーターです)に、このDynamicsCompressorNodeが関連付けられているBaseAudioContextのサンプルレートを乗算した値とします。 -
detector average をスロット
[[detector average]]の値とします。 -
compressor gain をスロット
[[compressor gain]]の値とします。 -
処理するレンダー量子の各入力サンプル input について、 次の手順を実行します:
-
input の絶対値が 0.0001 未満の場合、attenuation を 1.0 とします。それ以外の場合、 shaped input を input の絶対値に圧縮カーブを適用した値とします。 attenuation を shaped input を input の絶対値で除算した値とします。
-
attenuation が compressor gain より大きい場合は releasing を
true、 それ以外の場合はfalseとします。 -
detector rate を、 attenuation に 検出カーブを適用した結果とします。
-
attenuation から detector average を減算し、その結果に detector rate を乗算します。この新しい結果を detector average に加算します。
-
detector average を最大 1.0 にクランプします。
-
envelope rate を、attack と release の値に基づいて エンベロープレートを計算した結果とします。
-
releasing が
trueの場合、 compressor gain を compressor gain と envelope rate の積に設定し、 最大 1.0 にクランプします。 -
それ以外で、releasing が
falseの場合、 gain increment を detector average から compressor gain を引いた値とします。gain increment に envelope rate を乗算し、その結果を compressor gain に加算します。 -
reduction gain を、compressor gain と メイクアップ ゲインを計算した戻り値との積として計算します。
-
metering gain を、reduction gain をデシベルへ 変換した値として計算します。
-
-
[[compressor gain]]を compressor gain に設定します。 -
[[detector average]]を detector average に設定します。 -
内部スロット
[[internal reduction]]を metering gain の値にアトミックに設定します。注: この手順により、メータリングゲインは ブロック処理の最後に、ブロックごとに 1 回 更新されます。
メイクアップゲインは、コンプレッサーのレシオ、 ニー、およびしきい値パラメーターにのみ依存し、 入力信号には依存しない固定ゲイン段です。ここでの目的は、 コンプレッサーの出力レベルを上げて、 入力レベルと同程度にすることです。
-
full range gain を、値 1.0 に 圧縮カーブを適用して返された値とします。
-
full range makeup gain を full range gain の逆数とします。
-
full range makeup gain の 0.6 乗を取った結果を返します。
-
エンベロープレートは、 compressor gain と detector average の比から 計算しなければなりません。
注: アタック中、この数値は 1 以下であり、リリース中は 厳密に 1 より大きくなります。
-
アタックカーブは、範囲 \([0, 1]\) において連続した単調増加 関数でなければなりません。このカーブの形状は
attackによって制御してもかまいません。 -
リリースカーブは、常に 1 より大きい連続した単調 減少関数でなければなりません。このカーブの形状は
releaseによって制御してもかまいません。
この操作は、この関数を compressor gain と detector average の比に適用して計算した値を返します。
アタックまたはリリース時の変化率に 検出 カーブを適用することで、 アダプティブリリースを実装できます。これは次の 制約を満たさなければならない関数です:
-
関数の出力は \([0,1]\) の範囲内でなければなりません。
-
関数は単調増加かつ連続でなければなりません。
注: たとえば、 圧縮が強いほど速くリリースする アダプティブリリースを行うコンプレッサーや、 アタックとリリースで異なる形状のカーブを持つコンプレッサーも 許可されます。
-
threshold と knee を、 それぞれ
thresholdとkneeの値を線形 単位へ変換し、このブロックの処理時に (k-rate パラメーターとして)サンプリングした値とします。 -
thresholdとkneeの合計も、このブロックの処理時に (k-rate パラメーターとして)サンプリングして計算します。 -
knee end threshold を、この 合計を線形 単位へ変換した値とします。
-
ratio を、
ratioの値を、このブロックの処理時に (k-rate パラメーターとして)サンプリングした値とします。 -
この関数は、線形の threshold の値までは恒等関数です(つまり \(f(x) = x\))。
-
threshold から knee end threshold までのカーブ形状は、ユーザーエージェントが 選択できます。関数全体は単調 増加かつ連続でなければなりません。
注: knee が 0 の場合、
DynamicsCompressorNodeはハードニーコンプレッサーと呼ばれます。 -
この関数は、threshold とソフトニーの後では ratio に基づく線形関数です(つまり \(f(x) = \frac{1}{ratio} \cdot x \))。
-
\(v\) が 0 に等しい場合、-1000 を返します。
-
それ以外の場合、\( 20 \, \log_{10}{v} \) を返します。
1.20.
GainNode
インターフェイス
オーディオ信号のゲインを変更することは、
オーディオアプリケーションにおける基本的な操作です。この
インターフェイスは 1 つの入力と
1 つの出力を持つ AudioNode
です:
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
GainNode
の入力データの各チャンネルの各サンプルには、
gain
AudioParam
の computedValue を
乗算しなければなりません。
[Exposed =Window ]interface GainNode :AudioNode {constructor (BaseAudioContext ,context optional GainOptions = {});options readonly attribute AudioParam gain ; };
1.20.1. コンストラクター
GainNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。GainNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい GainNodeが関連付けられるBaseAudioContext。optionsGainOptions✘ ✔ この GainNodeの省略可能な初期パラメーター値。
1.20.2. 属性
gain, 型は AudioParam、読み取り専用-
適用するゲイン量を表します。
パラメーター 値 注記 defaultValue1 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"
1.20.3.
GainOptions
これは
GainNode
を構築するときに使用するオプションを指定します。すべての
メンバーは省略可能です。指定されない場合、
通常の既定値を使用してノードが構築されます。
dictionary GainOptions :AudioNodeOptions {float gain = 1.0; };
1.20.3.1.
GainOptions
辞書のメンバー
gain, 型は float、既定値は1.0-
gainAudioParam の初期ゲイン値。
1.21.
IIRFilterNode
インターフェイス
IIRFilterNode
は、汎用的な IIR
フィルターを実装する AudioNode
プロセッサーです。一般に、次の理由から
高次フィルターの実装には BiquadFilterNode
を使用するのが最善です:
-
一般に数値的な問題の影響を受けにくい
-
フィルターパラメーターをオートメーションできる
-
すべての偶数次数の IIR フィルターを作成できる
ただし、奇数次数のフィルターは作成できないため、そのようなフィルターが 必要な場合、またはオートメーションが不要な場合は、IIR フィルターが 適切なことがあります。
作成後は、IIR フィルターの係数を変更できません。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | あり | 入力が 0 でも無音ではないオーディオを出力し続けます。これは IIR フィルターであるため、 フィルターは永続的に 0 でない出力を生成しますが、実際には、出力が十分に 0 に近くなる有限時間後に制限できます。実際の時間は フィルター係数に依存します。 |
出力のチャンネル数は常に 入力のチャンネル数と等しくなります。
[Exposed =Window ]interface IIRFilterNode :AudioNode {constructor (BaseAudioContext ,context IIRFilterOptions );options undefined getFrequencyResponse (Float32Array ,frequencyHz Float32Array ,magResponse Float32Array ); };phaseResponse
1.21.1. コンストラクター
IIRFilterNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。IIRFilterNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい IIRFilterNodeが関連付けられるBaseAudioContext。optionsIIRFilterOptions✘ ✘ この IIRFilterNodeの初期パラメーター値。
1.21.2. メソッド
getFrequencyResponse(frequencyHz, magResponse, phaseResponse)-
現在のフィルターパラメーター 設定が与えられると、指定された周波数について 周波数応答を同期的に計算します。3 つのパラメーターは 同じ長さの
Float32Arrayでなければならず、そうでない場合はInvalidAccessErrorを投げなければなりません。IIRFilterNode.getFrequencyResponse() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 frequencyHzFloat32Array✘ ✘ このパラメーターは、応答値を計算する周波数の配列を Hz 単位で指定します。 magResponseFloat32Array✘ ✘ このパラメーターは、線形振幅応答値を受け取る出力配列を指定します。 frequencyHzパラメーター内の値が [0, sampleRate/2] の範囲内でない場合、 ここでsampleRateはsampleRateプロパティの値であり、そのAudioContextに対応するmagResponse配列の同じインデックスの値はNaNでなければなりません。phaseResponseFloat32Array✘ ✘ このパラメーターは、ラジアン単位の位相応答値を受け取る出力配列を指定します。 frequencyHzパラメーター内の値が [0; sampleRate/2] の範囲内でない場合、 ここでsampleRateはsampleRateプロパティの値であり、そのAudioContextに対応するphaseResponse配列の同じインデックスの値はNaNでなければなりません。戻り値の型:undefined
1.21.3.
IIRFilterOptions
IIRFilterOptions 辞書は、
IIRFilterNode
のフィルター係数を指定するために使用されます。
dictionary IIRFilterOptions :AudioNodeOptions {required sequence <double >feedforward ;required sequence <double >feedback ; };
1.21.3.1.
IIRFilterOptions
辞書のメンバー
feedforward, 型は sequence<double>-
IIRFilterNodeのフィードフォワード係数。 このメンバーは必須です。その他の制約についてはcreateIIRFilter()のfeedforward引数を参照してください。 feedback, 型は sequence<double>-
IIRFilterNodeのフィードバック係数。 このメンバーは必須です。その他の制約についてはcreateIIRFilter()のfeedback引数を参照してください。
1.21.4. フィルター定義
\(b_m\) を feedforward 係数、
\(a_n\) を createIIRFilter()
または IIRFilterOptions
辞書で constructor
に指定された feedback 係数とします。
このとき、一般的な IIR フィルターの
伝達関数は次のようになります
$$
    H(z) = \frac{\sum_{m=0}^{M} b_m z^{-m}}{\sum_{n=0}^{N} a_n z^{-n}}
$$
ここで \(M + 1\) は \(b\) 配列の長さ、\(N + 1\) は
\(a\) 配列の長さです。係数 \(a_0\) は 0 であってはなりません(createIIRFilter()
の feedback parameter
を参照してください)。
\(b_m\) の少なくとも 1 つは 0 以外でなければなりません(createIIRFilter()
の feedforward parameter
を参照してください)。
同等に、時間領域方程式は次のとおりです:
$$
    \sum_{k=0}^{N} a_k y(n-k) = \sum_{k=0}^{M} b_k x(n-k)
$$
フィルターの初期状態は全要素が 0 の状態です。
注: UA は、フィルター状態で NaN 値が発生したことを ユーザーに通知する警告を生成してもかまいません。これは通常、不安定なフィルターを示しています。
1.22.
MediaElementAudioSourceNode
インターフェイス
このインターフェイスは、
audio
または
video
要素からのオーディオソースを表します。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| テールタイム参照 | なし |
出力のチャンネル数は、
HTMLMediaElement
が参照するメディアのチャンネル数に対応します。
したがって、メディア要素の
src 属性を変更すると、このノードが出力するチャンネル数が
変化する可能性があります。
HTMLMediaElement
のサンプルレートが、関連付けられた
AudioContext
のサンプルレートと異なる場合、
HTMLMediaElement
からの出力は、コンテキストの
sample rate
に一致するようリサンプリングしなければなりません。
MediaElementAudioSourceNode
は、AudioContext
の createMediaElementSource()
メソッド、または
MediaElementAudioSourceOptions
辞書の mediaElement
メンバーを constructor
に使用して、指定された
HTMLMediaElement
から作成されます。
単一出力のチャンネル数は、
createMediaElementSource()
の引数として渡された HTMLMediaElement
が参照するオーディオのチャンネル数と等しく、
HTMLMediaElement
にオーディオがない場合は 1 です。
HTMLMediaElement
は、MediaElementAudioSourceNode
が作成された後も、レンダリングされたオーディオが直接聞こえなくなり、
代わりに
MediaElementAudioSourceNode
がルーティンググラフを通して接続される結果として聞こえる点を除いて、
同一の動作をしなければなりません。
したがって、一時停止、シーク、音量、src
属性の変更、および HTMLMediaElement
のその他の側面は、
MediaElementAudioSourceNode
とともに使用されていない場合と通常どおり同じように
動作しなければなりません。
const mediaElement= document. getElementById( 'mediaElementID' ); const sourceNode= context. createMediaElementSource( mediaElement); sourceNode. connect( filterNode);
[Exposed =Window ]interface MediaElementAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaElementAudioSourceOptions ); [options SameObject ]readonly attribute HTMLMediaElement mediaElement ; };
1.22.1. コンストラクター
MediaElementAudioSourceNode(context, options)-
-
context と options を引数として、 this の AudioNode を 初期化します。
MediaElementAudioSourceNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextAudioContext✘ ✘ この新しい MediaElementAudioSourceNodeが関連付けられるAudioContext。optionsMediaElementAudioSourceOptions✘ ✘ この MediaElementAudioSourceNodeの初期パラメーター値。 -
1.22.2. 属性
mediaElement, 型は HTMLMediaElement、読み取り専用-
この
MediaElementAudioSourceNodeを構築するときに使用されたHTMLMediaElement。
1.22.3.
MediaElementAudioSourceOptions
これは
MediaElementAudioSourceNode
を構築するときに使用するオプションを指定します。
dictionary MediaElementAudioSourceOptions {required HTMLMediaElement mediaElement ; };
1.22.3.1.
MediaElementAudioSourceOptions
辞書のメンバー
mediaElement, 型は HTMLMediaElement-
再ルーティングされるメディア要素。これは指定しなければなりません。
1.22.4. MediaElementAudioSourceNode とクロスオリジンリソースのセキュリティ
HTMLMediaElement
はクロスオリジン
リソースの再生を可能にします。Web Audio ではリソースの内容を
検査できるため(たとえば MediaElementAudioSourceNode
と
AudioWorkletNode
または ScriptProcessorNode
を使用してサンプルを読み取るなど)、ある
オリジンのスクリプトが
別の オリジンのリソースの内容を
検査すると、情報漏えいが発生する可能性があります。
これを防ぐため、MediaElementAudioSourceNode
は、
fetch
アルゴリズム [FETCH] の実行によって
リソースが
CORS-cross-origin
とラベル付けされた HTMLMediaElement
を使用して作成されている場合、
HTMLMediaElement
の通常の出力の代わりに無音を出力しなければなりません。
1.23.
MediaStreamAudioDestinationNode
インターフェイス
このインターフェイスは、kind が "audio" である
単一の MediaStreamTrack
を持つ MediaStream
を表すオーディオデスティネーションです。この MediaStream
はノードの作成時に作成され、
stream
属性を介してアクセスできます。このストリームは、
getUserMedia()
を介して取得された MediaStream
と同様の方法で使用でき、たとえば
RTCPeerConnection(
[webrtc]で説明されています)の
addStream() メソッドを使用して
リモートピアへ送信できます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 0 | |
channelCount
| 2 | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
入力のチャンネル数は既定では 2(ステレオ)です。
[Exposed =Window ]interface MediaStreamAudioDestinationNode :AudioNode {constructor (AudioContext ,context optional AudioNodeOptions = {});options readonly attribute MediaStream stream ; };
1.23.1. コンストラクター
MediaStreamAudioDestinationNode(context, options)-
-
context と options を引数として、 this の AudioNode を 初期化します。
MediaStreamAudioDestinationNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextAudioContext✘ ✘ この新しい MediaStreamAudioDestinationNodeが関連付けられるBaseAudioContext。optionsAudioNodeOptions✘ ✔ この MediaStreamAudioDestinationNodeの省略可能な初期パラメーター値。 -
1.23.2. 属性
stream, 型は MediaStream、読み取り専用-
ノード自体と同じ チャンネル数を持ち、
kind属性の値が"audio"である 単一のMediaStreamTrackを含むMediaStream。
1.24.
MediaStreamAudioSourceNode
インターフェイス
このインターフェイスは、
MediaStream
からのオーディオソースを表します。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| テールタイム参照 | なし |
出力のチャンネル数は、
MediaStreamTrack
のチャンネル数に対応します。
MediaStreamTrack
が終了すると、この
AudioNode
は 1 チャンネルの無音を出力します。
MediaStreamTrack
のサンプルレートが、関連付けられた
AudioContext
のサンプルレートと異なる場合、
MediaStreamTrack
の出力は、コンテキストの
sample rate
に一致するようリサンプリングされます。
[Exposed =Window ]interface MediaStreamAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaStreamAudioSourceOptions ); [options SameObject ]readonly attribute MediaStream mediaStream ; };
1.24.1. コンストラクター
MediaStreamAudioSourceNode(context, options)-
-
optionsのmediaStreamメンバーが、kind属性の値が"audio"であるMediaStreamTrackを少なくとも 1 つ持つMediaStreamを参照していない場合、InvalidStateErrorを投げてこれらの手順を中止します。それ以外の場合、 このストリームを inputStream とします。 -
tracks を、 inputStream のすべての
MediaStreamTrackのうち、kindが"audio"であるもののリストとします。 -
tracks 内の要素を、その
id属性に基づいて、コード単位 値のシーケンス上の順序を使用して並べ替えます。 -
context と options を引数として、 this の AudioNode を 初期化します。
-
この
MediaStreamAudioSourceNode上の内部スロット[[input track]]を tracks の最初の要素に設定します。 これがこのMediaStreamAudioSourceNodeの入力オーディオとして使用されるトラックです。
構築後、コンストラクターへ渡された
MediaStreamに変更があっても、このAudioNodeの基盤となる出力には影響しません。スロット
[[input track]]は、MediaStreamTrackへの参照を保持するためだけに使用されます。注: これは、 このコンストラクターへ渡された
MediaStreamから、MediaStreamAudioSourceNodeのコンストラクターによって選択されたトラックを削除しても、MediaStreamAudioSourceNodeは引き続き同じトラックから 入力を取得することを意味します。注: 出力するトラックを選択する動作は、 レガシー上の理由から任意です。入力として使用するトラックを明示するには、 代わりに
MediaStreamTrackAudioSourceNodeを使用できます。MediaStreamAudioSourceNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextAudioContext✘ ✘ この新しい MediaStreamAudioSourceNodeが関連付けられるAudioContext。optionsMediaStreamAudioSourceOptions✘ ✘ この MediaStreamAudioSourceNodeの初期パラメーター値。 -
1.24.2. 属性
mediaStream, 型は MediaStream、読み取り専用-
この
MediaStreamAudioSourceNodeを構築するときに使用されたMediaStream。
1.24.3.
MediaStreamAudioSourceOptions
これは MediaStreamAudioSourceNode
を構築するためのオプションを指定します。
dictionary MediaStreamAudioSourceOptions {required MediaStream mediaStream ; };
1.24.3.1.
MediaStreamAudioSourceOptions
辞書のメンバー
mediaStream, 型は MediaStream-
ソースとして機能するメディアストリーム。これは指定しなければなりません。
1.25.
MediaStreamTrackAudioSourceNode
インターフェイス
このインターフェイスは、MediaStreamTrack
からのオーディオソースを表します。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| テールタイム参照 | なし |
出力のチャンネル数は、
mediaStreamTrack
のチャンネル数に対応します。
MediaStreamTrack
のサンプルレートが、関連付けられた
AudioContext
のサンプルレートと異なる場合、
mediaStreamTrack
の出力は、
コンテキストの sample rate
に一致するようリサンプリングされます。
[Exposed =Window ]interface MediaStreamTrackAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaStreamTrackAudioSourceOptions ); };options
1.25.1. コンストラクター
MediaStreamTrackAudioSourceNode(context, options)-
-
mediaStreamTrackのkind属性が"audio"でない場合、InvalidStateErrorを投げてこれらの手順を中止します。 -
context と options を引数として、 this の AudioNode を 初期化します。
MediaStreamTrackAudioSourceNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextAudioContext✘ ✘ この新しい MediaStreamTrackAudioSourceNodeが関連付けられるAudioContext。optionsMediaStreamTrackAudioSourceOptions✘ ✘ この MediaStreamTrackAudioSourceNodeの初期パラメーター値。 -
1.25.2.
MediaStreamTrackAudioSourceOptions
これは
MediaStreamTrackAudioSourceNode
を構築するためのオプションを指定します。これは
必須です。
dictionary MediaStreamTrackAudioSourceOptions {required MediaStreamTrack mediaStreamTrack ; };
1.25.2.1.
MediaStreamTrackAudioSourceOptions
辞書のメンバー
mediaStreamTrack, 型は MediaStreamTrack-
ソースとして機能するメディアストリームトラック。この
MediaStreamTrackのkind属性が"audio"でない場合、InvalidStateErrorを投げなければなりません。
1.26.
OscillatorNode
インターフェイス
OscillatorNode
は周期波形を生成するオーディオソースを
表します。一般的に使用されるいくつかの波形に設定できます。
さらに、PeriodicWave
オブジェクトを使用して、任意の周期
波形に設定できます。
オシレーターは、オーディオ
合成における一般的な基本構成要素です。OscillatorNode は、
start()
メソッドで指定された時刻に音を出し始めます。
数学的に言えば、連続時間周期波形は、 周波数領域で考えると非常に高い(または無限に高い)周波数情報を 持つことがあります。この波形を特定のサンプルレートで 離散時間デジタルオーディオ信号としてサンプリングする場合、 波形をデジタル形式へ変換する前に、 ナイキスト周波数より高い高周波 情報を破棄(フィルタリング)するよう注意しなければなりません。 これを行わない場合、エイリアシングにより、 ナイキスト 周波数より高い周波数が鏡像として折り返され、 ナイキスト 周波数より低い周波数に現れます。多くの場合、これにより 聴感上好ましくないアーティファクトが発生します。これはオーディオ DSP の 基本的でよく理解された原則です。
実装がこのエイリアシングを回避するために採用できる 実用的なアプローチはいくつかあります。アプローチにかかわらず、 理想化された離散時間デジタルオーディオ信号は数学的に 明確に定義されています。実装にとってのトレードオフは、 実装コスト(CPU 使用量の観点)と、この理想を 実現する忠実度との間の問題です。
実装はこの理想を達成するために一定の配慮を行うことが 期待されますが、低性能なハードウェアでは、より低品質で コストの低いアプローチを検討することも合理的です。
frequency
と detune
はどちらも a-rate
パラメーターであり、複合パラメーターを形成します。これらは
computedOscFrequency 値を決定するために
一緒に使用されます:
computedOscFrequency(t) = frequency(t) * pow(2, detune(t) / 1200)
各時刻における OscillatorNode の瞬時位相は、 ノードの正確な開始時刻で位相角が 0 であると仮定した場合の computedOscFrequency の時間に関する定積分です。その 公称範囲は [-ナイキスト 周波数, ナイキスト周波数] です。
このノードの単一の出力は 1 チャンネル(モノラル)で構成されます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
enum {OscillatorType "sine" ,"square" ,"sawtooth" ,"triangle" ,"custom" };
| 列挙値 | 説明 |
|---|---|
"sine"
| 正弦波 |
"square"
| デューティ比 0.5 の矩形波 |
"sawtooth"
| のこぎり波 |
"triangle"
| 三角波 |
"custom"
| カスタム周期波 |
[Exposed =Window ]interface OscillatorNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional OscillatorOptions = {});options attribute OscillatorType type ;readonly attribute AudioParam frequency ;readonly attribute AudioParam detune ;undefined setPeriodicWave (PeriodicWave ); };periodicWave
1.26.1. コンストラクター
OscillatorNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。OscillatorNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい OscillatorNodeが関連付けられるBaseAudioContext。optionsOscillatorOptions✘ ✔ この OscillatorNodeの省略可能な初期パラメーター値。
1.26.2. 属性
detune, 型は AudioParam、 読み取り専用-
frequencyを指定された量だけオフセットする デチューン値(セント単位)です。既定のvalueは 0 です。このパラメーターは a-rate です。frequencyと 複合パラメーターを形成し、 computedOscFrequency を形成します。以下に示す公称 範囲により、このパラメーターはfrequencyを可能な周波数の 全範囲にわたってデチューンできます。パラメーター 値 注記 defaultValue0 minValue\(\approx -153600\) maxValue\(\approx 153600\) この値はおよそ \(1200\ \log_2 \mathrm{FLT\_MAX}\) であり、FLT_MAX は 最大の float値です。automationRate" a-rate" frequency, 型は AudioParam、 読み取り専用-
周期波形の周波数(ヘルツ単位)。既定の
valueは 440 です。このパラメーターは a-rate です。detuneと 複合パラメーターを形成し、 computedOscFrequency を形成します。その 公称範囲 は [-ナイキスト 周波数, ナイキスト周波数] です。パラメーター 値 注記 defaultValue440 minValue-ナイキスト周波数 maxValueナイキスト周波数 automationRate" a-rate" type, 型は OscillatorType-
周期波形の形状です。これは、"
custom" を除く 任意の型定数値に直接設定できます。 そうすると、InvalidStateError例外を投げなければなりません。setPeriodicWave()メソッドを 使用してカスタム波形を設定でき、その結果、この属性は "custom" に設定されます。 既定値は "sine" です。 この 属性が設定されるとき、オシレーターの位相は保持されなければなりません。
1.26.3. メソッド
setPeriodicWave(periodicWave)-
PeriodicWaveを指定して、任意のカスタム周期波形を設定します。OscillatorNode.setPeriodicWave() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 periodicWavePeriodicWave✘ ✘ オシレーターが使用するカスタム波形 戻り値の型:undefined
1.26.4.
OscillatorOptions
これは
OscillatorNode
を構築するときに使用するオプションを指定します。
すべてのメンバーは
省略可能です。指定されない場合、通常の既定値を使用して
オシレーターが構築されます。
dictionary OscillatorOptions :AudioNodeOptions {OscillatorType type = "sine";float frequency = 440;float detune = 0;PeriodicWave periodicWave ; };
1.26.4.1.
OscillatorOptions
辞書のメンバー
detune, 型は float、既定値は0-
OscillatorNodeの初期 detune 値。 frequency, 型は float、既定値は440-
OscillatorNodeの初期周波数。 periodicWave, 型は PeriodicWave-
OscillatorNodeのためのPeriodicWave。 これが指定された場合、typeの有効な値はすべて無視され、 "custom" が指定されたものとして扱われます。 type, 型は OscillatorType、既定値は"sine"-
構築するオシレーターの型。
periodicWaveも指定せずにこれを "custom" に設定した場合、InvalidStateError例外を投げなければなりません。periodicWaveが指定された場合、typeの有効な値はすべて無視され、 "custom" に設定されたものとして扱われます。
1.26.5. 基本波形の位相
各種オシレーター 型の理想化された数学的波形を以下に定義します。要約すると、すべての波形は 時刻 0 で正の傾きを持つ奇関数として数学的に定義されます。 オシレーターによって実際に生成される波形は、 エイリアシングの影響を防ぐために異なる場合があります。
オシレーターは、適切な フーリエ
級数を持ち、disableNormalization
が false に設定された PeriodicWave
を使用してこれらの
基本波形を作成した場合と同じ結果を生成しなければなりません。
- "
sine" -
正弦波オシレーターの波形は次のとおりです:
$$ x(t) = \sin t $$ - "
square" -
矩形波オシレーターの波形は次のとおりです:
$$
    x(t) = \begin{cases}
                 1 & \mbox{for } 0≤ t < \pi \\
                 -1 & \mbox{for } -\pi < t < 0.
                 \end{cases}
$$
波形が周期 \(2\pi\) の奇関数であることを利用して、 これをすべての \(t\) に拡張します。
- "
sawtooth" -
のこぎり波オシレーターの波形は次のランプです:
$$
    x(t) = \frac{t}{\pi} \mbox{ for } -\pi < t ≤ \pi;
$$
波形が周期 \(2\pi\) の奇関数であることを利用して、 これをすべての \(t\) に拡張します。
- "
triangle" -
三角波オシレーターの波形は次のとおりです:
$$
    x(t) = \begin{cases}
                     \frac{2}{\pi} t & \mbox{for } 0 ≤ t ≤ \frac{\pi}{2} \\
                     1-\frac{2}{\pi} \left(t-\frac{\pi}{2}\right) & \mbox{for }
                     \frac{\pi}{2} < t ≤ \pi.
                 \end{cases}
$$
波形が周期 \(2\pi\) の奇関数であることを利用して、 これをすべての \(t\) に拡張します。
1.27.
PannerNode
インターフェイス
このインターフェイスは、入力オーディオ
ストリームを 3 次元空間内で配置 / 空間化する処理ノードを表します。
空間化は、BaseAudioContext
の
AudioListener
(listener
属性)に対して行われます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 制約があります |
channelCountMode
| "clamped-max"
| channelCountMode 制約があります |
channelInterpretation
| "speakers"
| |
| テールタイム | 場合による | panningModel
が "HRTF"
に設定されている場合、頭部応答に固有の処理により、
ノードは無音入力に対して無音でない出力を生成します。それ以外の場合、テールタイムは 0 です。
|
このノードの入力はモノラル(1 チャンネル)またはステレオ(2 チャンネル)のいずれかであり、増やすことはできません。チャンネル数が少ない または多いノードからの接続は適切にアップミックスまたはダウンミックス されます。
ノードがアクティブに処理中の場合、このノードの出力は ステレオ(2 チャンネル)に固定され、構成できません。ノードが アクティブに 処理中でない場合、出力は 1 チャンネルの 無音です。
PanningModelType
列挙型は、オーディオを 3D
空間内に配置するために使用する
空間化アルゴリズムを決定します。既定値は "equalpower"
です。
enum {PanningModelType "equalpower" ,"HRTF" };
| 列挙値 | 説明 |
|---|---|
"equalpower"
|
等電力パンニングを使用する、単純で効率的な
空間化アルゴリズム。
注: このパンニングモデルを
使用する場合、このノードの出力を計算するために使用されるすべての |
"HRTF"
|
人間の被験者から測定したインパルス応答との畳み込みを
使用する、より高品質な空間化アルゴリズム。このパンニング
手法はステレオ出力をレンダリングします。
注:このパンニングモデルを
使用する場合、このノードの出力を計算するために使用されるすべての |
PannerNode
の AudioParam
の 有効
オートメーションレートは、
panningModel
と
AudioParamのautomationRate
によって決定されます。
panningModel
が "HRTF"
の場合、
有効
オートメーションレートは "k-rate"
であり、automationRate
の設定とは無関係です。
それ以外の場合、有効オートメーションレートは
automationRate
の値です。
DistanceModelType
列挙型は、オーディオソースが
リスナーから遠ざかるにつれて音量を下げるために使用する
アルゴリズムを決定します。既定値は "inverse"
です。
以下の各距離モデルの説明では、\(d\) を
リスナーとパンナーの間の距離、\(d_{ref}\) を
refDistance
属性の値、\(d_{max}\) を
maxDistance
属性の値、\(f\) を
rolloffFactor
属性の値とします。
enum {DistanceModelType "linear" ,"inverse" ,"exponential" };
| 列挙値 | 説明 |
|---|---|
"linear"
|
次の式に従って distanceGain を
計算する線形距離モデル:
$$
    1 - f\ \frac{\max\left[\min\left(d, d'_{max}\right), d'_{ref}\right] - d'_{ref}}{d'_{max} - d'_{ref}}
$$
ここで \(d’_{ref} = \min\left(d_{ref}, d_{max}\right)\)、\(d’_{max} = \max\left(d_{ref}, d_{max}\right)\) です。\(d’_{ref} = d’_{max}\) の場合、線形モデルの値は \(1-f\) とします。 \(d\) は区間 \(\left[d’_{ref},\, d’_{max}\right]\) にクランプされることに注意してください。 |
"inverse"
|
次の式に従って
distanceGain を計算する逆距離モデル:
$$
    \frac{d_{ref}}{d_{ref} + f\ \left[\max\left(d, d_{ref}\right) - d_{ref}\right]}
$$
つまり、\(d\) は区間 \(\left[d_{ref},\, \infty\right)\) にクランプされます。\(d_{ref} = 0\) の場合、逆距離モデルの値は \(d\) と \(f\) の値にかかわらず 0 とします。 |
"exponential"
|
次の式に従って
distanceGain を計算する指数距離モデル:
$$
    \left[\frac{\max\left(d, d_{ref}\right)}{d_{ref}}\right]^{-f}
$$
つまり、\(d\) は区間 \(\left[d_{ref},\, \infty\right)\) にクランプされます。\(d_{ref} = 0\) の場合、指数距離モデルの値は \(d\) と \(f\) にかかわらず 0 とします。 |
[Exposed =Window ]interface PannerNode :AudioNode {constructor (BaseAudioContext ,context optional PannerOptions = {});options attribute PanningModelType panningModel ;readonly attribute AudioParam positionX ;readonly attribute AudioParam positionY ;readonly attribute AudioParam positionZ ;readonly attribute AudioParam orientationX ;readonly attribute AudioParam orientationY ;readonly attribute AudioParam orientationZ ;attribute DistanceModelType distanceModel ;attribute double refDistance ;attribute double maxDistance ;attribute double rolloffFactor ;attribute double coneInnerAngle ;attribute double coneOuterAngle ;attribute double coneOuterGain ;undefined setPosition (float ,x float ,y float );z undefined setOrientation (float ,x float ,y float ); };z
1.27.1. コンストラクター
PannerNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。PannerNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい PannerNodeが関連付けられるBaseAudioContext。optionsPannerOptions✘ ✔ この PannerNodeの省略可能な初期パラメーター値。
1.27.2. 属性
coneInnerAngle, 型は double-
指向性オーディオソースのためのパラメーターであり、 この角度の内側では音量低下が発生しない角度を度単位で表します。 既定値は 360 です。角度が 区間 [0, 360] の外にある場合、動作は未定義です。
coneOuterAngle, 型は double-
指向性オーディオソースのためのパラメーターであり、 この角度の外側では音量が
coneOuterGainの一定値まで低下する角度を度単位で表します。 既定値は 360 です。角度が区間 [0, 360] の外にある場合、動作は未定義です。 coneOuterGain, 型は double-
指向性オーディオソースのためのパラメーターで、
coneOuterAngleの外側でのゲインです。既定値は 0 です。範囲 [0, 1] の線形値(dB ではありません)です。パラメーターが この範囲外の場合、InvalidStateErrorを投げなければなりません。 distanceModel, 型は DistanceModelType-
この
PannerNodeが使用する距離モデルを指定します。 既定値は "inverse" です。 maxDistance, 型は double-
ソースとリスナーの間の最大距離であり、これを超えると 音量はそれ以上低下しません。既定値は 10000 です。 これが正でない値に設定された場合、
RangeError例外を投げなければなりません。 orientationX, 型は AudioParam、 読み取り専用-
3D デカルト座標空間において オーディオソースが向いている方向ベクトルの \(x\) 成分を表します。
パラメーター 値 注記 defaultValue1 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"オートメーションレート 制約があります orientationY, 型は AudioParam、 読み取り専用-
3D デカルト座標空間において オーディオソースが向いている方向ベクトルの \(y\) 成分を表します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"オートメーションレート 制約があります orientationZ, 型は AudioParam、 読み取り専用-
3D デカルト座標空間において オーディオソースが向いている方向ベクトルの \(z\) 成分を表します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"オートメーションレート 制約があります panningModel, 型は PanningModelType-
この
PannerNodeが使用するパンニングモデルを指定します。 既定値は "equalpower" です。 positionX, 型は AudioParam、 読み取り専用-
3D デカルト座標系におけるオーディオソースの \(x\) 座標位置を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"オートメーションレート 制約があります positionY, 型は AudioParam、 読み取り専用-
3D デカルト座標系におけるオーディオソースの \(y\) 座標位置を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"オートメーションレート 制約があります positionZ, 型は AudioParam、 読み取り専用-
3D デカルト座標系におけるオーディオソースの \(z\) 座標位置を設定します。
パラメーター 値 注記 defaultValue0 minValue最も負の単精度浮動小数点数 約 -3.4028235e38 maxValue最も正の単精度浮動小数点数 約 3.4028235e38 automationRate" a-rate"オートメーションレート 制約があります refDistance, 型は double-
ソースがリスナーから遠ざかるにつれて音量を下げるための 基準距離です。これより短い距離では、音量は低下しません。既定値は 1 です。 これが負の値に設定された場合、
RangeError例外を投げなければなりません。 rolloffFactor, 型は double-
ソースがリスナーから 遠ざかるにつれて、音量がどれだけ速く低下するかを記述します。既定値は 1 です。これが 負の値に設定された場合、
RangeError例外を投げなければなりません。rolloffFactorの公称範囲は、rolloffFactorが取り得る最小値と最大値を 指定します。範囲外の値は、この 範囲内に収まるようクランプされます。公称範囲はdistanceModelに応じて次のようになります:- "
linear" -
公称範囲は \([0, 1]\) です。
- "
inverse" -
公称範囲は \([0, \infty)\) です。
- "
exponential" -
公称範囲は \([0, \infty)\) です。
クランプは距離計算の 処理の一部として行われることに注意してください。属性は 設定された値を反映し、変更されません。
- "
1.27.3. メソッド
setOrientation(x, y, z)-
このメソッドは非推奨です。これは、
orientationX.value、orientationY.value、 およびorientationZ.value属性を、それぞれx、y、zパラメーターで直接設定することと等価です。したがって、このメソッドが呼び出された時点で、
orientationX、orientationY、 およびorientationZAudioParamのいずれかにsetValueCurveAtTime()を使用してオートメーションカーブが設定されている場合、NotSupportedErrorを 投げなければなりません。3D デカルト座標空間でオーディオソースが どの方向を向いているかを記述します。音の指向性の程度 (cone 属性によって制御されます)に応じて、 リスナーとは反対方向を向いている音は非常に小さくなるか、完全に 無音になる可能性があります。
x, y, zパラメーターは、3D 空間内の 方向ベクトルを表します。既定値は (1,0,0) です。
PannerNode.setOrientation() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 xfloat✘ ✘ yfloat✘ ✘ zfloat✘ ✘ 戻り値の型:undefined setPosition(x, y, z)-
このメソッドは非推奨です。これは、
positionX.value、positionY.value、 およびpositionZ.value属性を、それぞれx、y、zパラメーターで直接設定することと等価です。したがって、このメソッドが呼び出された時点で、
positionX、positionY、 およびpositionZAudioParamのいずれかにsetValueCurveAtTime()を使用してオートメーション カーブが設定されている場合、NotSupportedErrorを 投げなければなりません。listener属性に対するオーディオソースの位置を設定します。 3D デカルト 座標系を使用します。x, y, zパラメーターは、3D 空間内の座標を 表します。既定値は (0,0,0) です。
PannerNode.setPosition() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 xfloat✘ ✘ yfloat✘ ✘ zfloat✘ ✘ 戻り値の型:undefined
1.27.4.
PannerOptions
これは
PannerNode
を構築するためのオプションを指定します。
すべてのメンバーは省略可能です。指定されない場合、
通常の既定値を使用してノードが構築されます。
dictionary PannerOptions :AudioNodeOptions {PanningModelType panningModel = "equalpower";DistanceModelType distanceModel = "inverse";float positionX = 0;float positionY = 0;float positionZ = 0;float orientationX = 1;float orientationY = 0;float orientationZ = 0;double refDistance = 1;double maxDistance = 10000;double rolloffFactor = 1;double coneInnerAngle = 360;double coneOuterAngle = 360;double coneOuterGain = 0; };
1.27.4.1.
PannerOptions
辞書のメンバー
coneInnerAngle, 型は double、既定値は360-
ノードの
coneInnerAngle属性の初期値。 coneOuterAngle, 型は double、既定値は360-
ノードの
coneOuterAngle属性の初期値。 coneOuterGain, 型は double、既定値は0-
ノードの
coneOuterGain属性の初期値。 distanceModel, 型は DistanceModelType、既定値は"inverse"-
ノードに使用する距離モデル。
maxDistance, 型は double、既定値は10000-
ノードの
maxDistance属性の初期値。 orientationX, 型は float、既定値は1-
orientationXAudioParam の初期 \(x\) 成分値。 orientationY, 型は float、既定値は0-
orientationYAudioParam の初期 \(y\) 成分値。 orientationZ, 型は float、既定値は0-
orientationZAudioParam の初期 \(z\) 成分値。 panningModel, 型は PanningModelType、既定値は"equalpower"-
ノードに使用するパンニングモデル。
positionX, 型は float、既定値は0-
positionXAudioParam の初期 \(x\) 座標値。 positionY, 型は float、既定値は0-
positionYAudioParam の初期 \(y\) 座標値。 positionZ, 型は float、既定値は0-
positionZAudioParam の初期 \(z\) 座標値。 refDistance, 型は double、既定値は1-
ノードの
refDistance属性の初期値。 rolloffFactor, 型は double、既定値は1-
ノードの
rolloffFactor属性の初期値。
1.27.5. チャンネルの制限
StereoPannerNode
のチャンネル
制限の一式は、
PannerNode
にも適用されます。
1.28.
PeriodicWave
インターフェイス
PeriodicWave
は、OscillatorNode
で使用する任意の周期波形を表します。
適合実装は、少なくとも 8192 要素までの
PeriodicWave
をサポートしなければなりません。
[Exposed =Window ]interface PeriodicWave {constructor (BaseAudioContext ,context optional PeriodicWaveOptions = {}); };options
1.28.1. コンストラクター
PeriodicWave(context, options)-
-
p を新しい
PeriodicWaveオブジェクトとします。[[real]]と[[imag]]をFloat32Array型の 2 つの内部スロットとし、[[normalize]]を内部 スロットとします。 -
optionsを、次のいずれかの場合に従って処理します:-
options.realとoptions.imagの両方が存在する場合-
options.realとoptions.imagの長さが異なる場合、またはいずれかの長さが 2 未満の場合、IndexSizeErrorを投げ、このアルゴリズムを中止します。 -
[[real]]と[[imag]]を、options.realと同じ長さの新しい配列に設定します。 -
options.realのすべての要素を[[real]]へ、options.imagのすべての要素を[[imag]]へコピーします。
-
-
options.realのみが存在する場合-
options.realの長さが 2 未満の場合、IndexSizeErrorを投げ、このアルゴリズムを中止します。 -
[[real]]と[[imag]]を、options.realと同じ長さの配列に設定します。 -
options.realを[[real]]へコピーし、[[imag]]のすべての要素を 0 に設定します。
-
-
options.imagのみが存在する場合-
options.imagの長さが 2 未満の場合、IndexSizeErrorを投げ、このアルゴリズムを中止します。 -
[[real]]と[[imag]]を、options.imagと同じ長さの配列に設定します。 -
options.imagを[[imag]]へコピーし、[[real]]のすべての要素を 0 に設定します。
-
-
それ以外の場合
注: この
PeriodicWaveをOscillatorNodeに設定する場合、 これは組み込み型 "sine" を使用することと等価です。
-
-
[[real]]と[[imag]]の両方について、インデックス 0 の要素を 0 に設定します。(これにより DC 成分が 0 に設定されます。) -
[[normalize]]を、PeriodicWaveOptions上のPeriodicWaveConstraintsのdisableNormalization属性の反転値で初期化します。 -
p を返します。
PeriodicWave.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい PeriodicWaveが関連付けられるBaseAudioContext。AudioBufferとは異なり、PeriodicWaveはAudioContextまたはOfflineAudioContext間で共有できません。 特定のBaseAudioContextに関連付けられます。optionsPeriodicWaveOptions✘ ✔ この PeriodicWaveの省略可能な初期パラメーター値。 -
1.28.2.
PeriodicWaveConstraints
PeriodicWaveConstraints
辞書は、波形をどのように正規化するかを
指定するために使用されます。
dictionary PeriodicWaveConstraints {boolean disableNormalization =false ; };
1.28.2.1.
PeriodicWaveConstraints
辞書のメンバー
disableNormalization, 型は boolean、既定値はfalse-
周期波を正規化するかどうかを制御します。
trueの場合、波形は正規化されません。それ以外の場合、 波形は正規化されます。
1.28.3.
PeriodicWaveOptions
PeriodicWaveOptions
辞書は、
波形をどのように構築するかを指定するために使用されます。real
または imag
の一方だけが指定された場合、もう一方は
以下の辞書メンバーの
説明で指定されているように、同じ長さですべて 0 の配列であるかのように扱われます。どちらも指定されない場合、
PeriodicWave
が作成され、それは
OscillatorNode
の
type
が "sine"
である場合と等価でなければなりません。
両方が指定された場合、シーケンスは同じ長さでなければならず、そうでない場合は
NotSupportedError
型のエラーを投げなければなりません。
dictionary PeriodicWaveOptions :PeriodicWaveConstraints {sequence <float >real ;sequence <float >imag ; };
1.28.3.1.
PeriodicWaveOptions
辞書のメンバー
imag, 型は sequence<float>-
imagパラメーターは、sine項の配列を表します。最初の要素(インデックス 0)は フーリエ級数には存在しません。2 番目の要素 (インデックス 1)は基本周波数を表します。 3 番目は第 1 倍音を表し、以降も同様です。 real, 型は sequence<float>-
realパラメーターは、cosine項の配列を表します。最初の要素(インデックス 0)は 周期波形の DC オフセットです。2 番目の要素 (インデックス 1)は基本周波数を表します。 3 番目は第 1 倍音を表し、以降も同様です。
1.28.4. 波形生成
createPeriodicWave()
メソッドは、PeriodicWave
のフーリエ係数を指定するために 2 つの配列を受け取ります。
\(a\) と \(b\) を、それぞれ長さ \(L\) の [[real]]
配列と [[imag]]
配列を表すものとします。このとき、基本的な時間領域波形
\(x(t)\) は次を使用して計算できます:
$$
    x(t) = \sum_{k=1}^{L-1} \left[a[k]\cos2\pi k t + b[k]\sin2\pi k t\right]
$$
これが基本(未正規化)の波形です。
1.28.5. 波形の正規化
この
PeriodicWave
の内部スロット [[normalize]]
が true(既定値)の場合、
前節で定義した波形は、最大値が 1 になるように
正規化されます。正規化は次のように行われます。
次のようにします
$$
    \tilde{x}(n) = \sum_{k=1}^{L-1} \left(a[k]\cos\frac{2\pi k n}{N} + b[k]\sin\frac{2\pi k n}{N}\right)
$$
ここで \(N\) は 2 の累乗です。(注: \(\tilde{x}(n)\) は 逆 FFT を使用して容易に計算できます。)固定 正規化係数 \(f\) は次のように計算されます。
$$
    f = \max_{n = 0, \ldots, N - 1} |\tilde{x}(n)|
$$
したがって、実際の正規化済み波形 \(\hat{x}(n)\) は次のとおりです:
$$
    \hat{x}(n) = \frac{\tilde{x}(n)}{f}
$$
この固定正規化係数は、生成されるすべての 波形に適用されなければなりません。
1.28.6. オシレーター係数
組み込みのオシレーター型は PeriodicWave
オブジェクトを使用して作成されます。完全を期すため、各
組み込みオシレーター型の PeriodicWave
の係数を
ここに示します。これは、組み込み型を使用したいが
既定の正規化を適用したくない場合に便利です。
以下の説明では、\(a\) を実数
係数の配列、\(b\) を createPeriodicWave()
の虚数係数の配列とします。
すべての場合で、波形は奇関数であるため、すべての \(n\) について \(a[n] = 0\) です。
また、すべての場合で \(b[0] = 0\) です。したがって、以下では \(n \ge 1\) の
\(b[n]\) のみを指定します。
- "
sine" -
$$ b[n] = \begin{cases} 1 & \mbox{for } n = 1 \\ 0 & \mbox{otherwise} \end{cases} $$ - "
square" -
$$ b[n] = \frac{2}{n\pi}\left[1 - (-1)^n\right] $$ - "
sawtooth" -
$$ b[n] = (-1)^{n+1} \dfrac{2}{n\pi} $$ - "
triangle" -
$$
    b[n] = \frac{8\sin\dfrac{n\pi}{2}}{(\pi n)^2}
$$
1.29.
ScriptProcessorNode
インターフェイス - 非推奨
このインターフェイスは、
スクリプトを直接使用してオーディオを生成、処理、または解析できる
AudioNode
です。この
ノード型は非推奨であり、
AudioWorkletNode
に置き換えられる予定です。
このテキストは、実装がこのノード型を削除するまでの
情報提供目的でのみここにあります。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| numberOfInputChannels
| これは、このノードの構築時に指定されたチャンネル数です。channelCount 制約があります。 |
channelCountMode
| "explicit"
| channelCountMode 制約があります |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
ScriptProcessorNode
は、次の値のいずれかでなければならない
bufferSize
を指定して構築されます: 256、
512、1024、2048、4096、8192、16384。この値は、
audioprocess
イベントがどのくらいの頻度で配送されるか、および
各呼び出しで処理する必要があるサンプルフレーム数を制御します。audioprocess
イベントは、
ScriptProcessorNode
に少なくとも
1 つの入力または 1 つの出力が接続されている場合にのみ配送されます。bufferSize
の値が小さいほど
レイテンシーは低く(良好に)なります。値が大きいほど、
オーディオの途切れやグリッチを回避するために必要になります。この値は、
createScriptProcessor()
への bufferSize 引数が渡されない場合、または 0 に設定されている場合、
実装によって選択されます。
numberOfInputChannels
と numberOfOutputChannels
は、入力および出力チャンネル数を決定します。
numberOfInputChannels
と numberOfOutputChannels
の両方を 0 にすることは無効です。
[Exposed =Window ]interface ScriptProcessorNode :AudioNode {attribute EventHandler onaudioprocess ;readonly attribute long bufferSize ; };
1.29.1. 属性
bufferSize, 型は long、読み取り専用-
audioprocessが発火するたびに 処理する必要があるバッファーのサイズ(サンプルフレーム単位)。 有効な値は (256, 512, 1024, 2048, 4096, 8192, 16384) です。 onaudioprocess, 型は EventHandler-
ScriptProcessorNodeノード型へ配送されるaudioprocessイベント型の イベントハンドラーを設定するために使用されるプロパティです。 イベント ハンドラーへ配送されるイベントはAudioProcessingEventインターフェイスを使用します。
1.30.
StereoPannerNode
インターフェイス
このインターフェイスは、低コストのパンニング アルゴリズムを使用して、入力オーディオストリームを ステレオイメージ内に配置する処理ノードを表します。このパンニング効果は、 ステレオストリーム内でオーディオ要素を配置する際によく使用されます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 制約があります |
channelCountMode
| "clamped-max"
| channelCountMode 制約があります |
channelInterpretation
| "speakers"
| |
| テールタイム | なし |
このノードの入力はステレオ(2 チャンネル)であり、 増やすことはできません。チャンネル数が少ない、または多いノードからの接続は、 適切にアップミックスまたはダウンミックス されます。
このノードの出力はステレオ(2 チャンネル)に固定され、 構成できません。
[Exposed =Window ]interface StereoPannerNode :AudioNode {constructor (BaseAudioContext ,context optional StereoPannerOptions = {});options readonly attribute AudioParam pan ; };
1.30.1. コンストラクター
StereoPannerNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。StereoPannerNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい StereoPannerNodeが関連付けられるBaseAudioContext。optionsStereoPannerOptions✘ ✔ この StereoPannerNodeの省略可能な初期パラメーター値。
1.30.2. 属性
pan, 型は AudioParam、 読み取り専用-
出力のステレオイメージ内における入力の位置。-1 は 完全に左、+1 は完全に右を表します。
パラメーター 値 注記 defaultValue0 minValue-1 maxValue1 automationRate" a-rate"
1.30.3.
StereoPannerOptions
これは、
StereoPannerNode
を構築するときに使用するオプションを指定します。
すべてのメンバーは省略可能です。指定されない場合、
通常の既定値を使用してノードが構築されます。
dictionary StereoPannerOptions :AudioNodeOptions {float pan = 0; };
1.30.3.1.
StereoPannerOptions
辞書のメンバー
pan, 型は float、既定値は0-
panAudioParam の初期値。
1.30.4. チャンネルの制限
その処理は上記の定義によって制約されるため、
StereoPannerNode
は最大 2 チャンネルのオーディオをミキシングし、
正確に 2 チャンネルを生成するよう制限されています。
ChannelSplitterNode、
GainNode
やその他のノードのサブグラフによる中間処理、および
ChannelMergerNode
による再結合を使用して、任意の
パンニングおよびミキシング手法を実現できます。
1.31.
WaveShaperNode
インターフェイス
WaveShaperNode
は、非線形
ディストーションエフェクトを実装する
AudioNode
プロセッサーです。
非線形ウェーブシェーピングディストーションは、微妙な 非線形の暖かみを加える場合にも、より明瞭なディストーション効果にも一般的に使用されます。 任意の非線形シェーピングカーブを指定できます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | 場合による | oversample
属性が "2x"
または "4x"
に設定されている場合にのみ、テールタイムがあります。
このテールタイムの実際の長さは実装に依存します。
|
出力のチャンネル数は常に 入力のチャンネル数と等しくなります。
enum {OverSampleType "none" ,"2x" ,"4x" };
| 列挙値 | 説明 |
|---|---|
"none"
| オーバーサンプリングしない |
"2x"
| 2 倍でオーバーサンプリング |
"4x"
| 4 倍でオーバーサンプリング |
[Exposed =Window ]interface WaveShaperNode :AudioNode {constructor (BaseAudioContext ,context optional WaveShaperOptions = {});options attribute Float32Array ?curve ;attribute OverSampleType oversample ; };
1.31.1. コンストラクター
WaveShaperNode(context, options)-
コンストラクターが
BaseAudioContextc と オプションオブジェクト option を指定して呼び出されたとき、ユーザーエージェントは context と options を引数として、 this の AudioNode を初期化 しなければなりません。また、
[[curve set]]を、このWaveShaperNodeの内部 スロットとします。 このスロットをfalseに初期化します。optionsが指定され、curveが指定されている場合、[[curve set]]をtrueに設定します。WaveShaperNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい WaveShaperNodeが関連付けられるBaseAudioContext。optionsWaveShaperOptions✘ ✔ この WaveShaperNodeの省略可能な初期パラメーター値。
1.31.2. 属性
curve, 型は Float32Array、null 許容-
ウェーブシェーピング効果に使用するシェーピングカーブ。入力 信号は公称上 [-1, 1] の範囲内です。この範囲内の各入力サンプルは シェーピングカーブをインデックスし、配列の要素数が奇数の場合、 信号レベル 0 はカーブ配列の中央の値に対応し、 配列の要素数が偶数の場合は 中央の 2 つの値の間で補間されます。 -1 より小さいサンプル値は、カーブ配列の最初の値に対応します。 +1 より大きいサンプル値は、 カーブ配列の最後の値に対応します。
実装は、カーブ内の隣接する点の間で 線形補間を行わなければなりません。初期状態では curve 属性は null であり、これは WaveShaperNode が入力を 変更せずに出力へ渡すことを意味します。
カーブの値は [-1; 1] の範囲内に等間隔で配置されます。これは、 偶数個の値を持つ
curveには、信号レベル 0 に対応する値がなく、 奇数個の値を持つcurveには、信号レベル 0 に対応する値があることを意味します。 出力は次のアルゴリズムによって決定されます。-
\(x\) を入力サンプル、\(y\) を 対応するノードの出力、 \(c_k\) を
curveの \(k\) 番目の要素、\(N\) をcurveの長さとします。 -
次のようにします
$$ \begin{align*} v &= \frac{N-1}{2}(x + 1) \\ k &= \lfloor v \rfloor \\ f &= v - k \end{align*} $$ -
このとき
$$
    \begin{align*}
    y &=
        \begin{cases}
        c_0 & v \lt 0 \\
        c_{N-1} & v \ge N - 1 \\
        (1-f)\,c_k + fc_{k+1} & \mathrm{otherwise}
        \end{cases}
    \end{align*}
$$
この 属性に、
lengthが 2 未満のFloat32Arrayが設定された場合、InvalidStateErrorを投げなければなりません。この属性が設定されると、カーブの内部コピーが
WaveShaperNodeによって作成されます。したがって、 属性の設定に使用した配列の内容を後から変更しても 影響はありません。curve属性を設定するには、次の手順を実行します:-
new curve を、
Float32Arrayまたはnullとし、curveに割り当てるものとします。 . -
new curve が
nullではなく、[[curve set]]が true の場合、InvalidStateErrorを投げ、これらの手順を中止します。 -
new curve が
nullでない場合、[[curve set]]を true に設定します。 -
new curve を
curve属性に割り当てます。
注: 入力値が 0 のときに 0 以外の 出力値を生成するカーブを使用すると、このノードに 入力が接続されていなくても DC 信号が 生成されます。これは、 ノードが下流のノードから切断されるまで継続します。
-
oversample, 型は OverSampleType-
シェーピングカーブを適用するときに、 どの種類のオーバーサンプリング(存在する場合)を使用するかを指定します。既定値は "
none" であり、これはカーブが入力 サンプルへ直接適用されることを意味します。"2x" または "4x" の値は、一部のエイリアシングを回避することで 処理品質を向上させることができ、"4x" の値が 最も高い品質をもたらします。一部の用途では、非常に精密な シェーピングカーブを得るために、オーバーサンプリングを使用しない方が 適しています。"2x" または "4x" の値は、次の手順を 実行しなければならないことを意味します:-
入力サンプルを、
AudioContextのサンプルレートの 2 倍または 4 倍へアップサンプリングします。 したがって、各 レンダー 量子について、2 倍の場合は 2 倍、4 倍の場合は 4 倍のサンプルを生成します。 -
シェーピングカーブを適用します。
-
結果を
AudioContextのサンプルレートへダウンサンプリングします。 したがって、前に処理されたサンプルから 1 レンダー量子分のサンプルを 最終結果として生成します。
正確なアップサンプリングおよびダウンサンプリングフィルターは 指定されておらず、音質(低エイリアシングなど)、 低レイテンシー、またはパフォーマンスに合わせて調整できます。
注: オーバーサンプリングを使用すると、 アップサンプリングおよびダウンサンプリングフィルターにより、ある程度の オーディオ処理レイテンシーが発生します。この レイテンシー量は実装によって異なる場合があります。
-
1.31.3.
WaveShaperOptions
これは、
WaveShaperNode
を構築するためのオプションを指定します。
すべてのメンバーは省略可能です。指定されない場合、
通常の既定値を使用してノードが構築されます。
dictionary WaveShaperOptions :AudioNodeOptions {sequence <float >curve ;OverSampleType oversample = "none"; };
1.31.3.1.
WaveShaperOptions
辞書のメンバー
curve, 型は sequence<float>-
ウェーブシェーピング効果のシェーピングカーブ。
oversample, 型は OverSampleType、既定値は"none"-
シェーピングカーブに使用するオーバーサンプリングの種類。
1.32.
AudioWorklet
インターフェイス
[Exposed =Window ,SecureContext ]interface AudioWorklet :Worklet {readonly attribute MessagePort port ; };
1.32.1. 属性
port, 型は MessagePort、読み取り専用-
AudioWorkletGlobalScope上のポートに接続されたMessagePort。注: この
portの"message"イベントにイベントリスナーを登録する作者は、 リソースを回収できるようにするため、MessageChannelのどちらか一方の端 (AudioWorklet側またはAudioWorkletGlobalScope側)でcloseを呼び出すべきです。
1.32.2. 概念
AudioWorklet
オブジェクトは、開発者が
レンダリングスレッド上でオーディオを処理するためのスクリプト
(JavaScript や WebAssembly コードなど)を提供できるようにし、
カスタム AudioNode
をサポートします。この
処理機構により、スクリプトコードはオーディオ
グラフ内の他の組み込み AudioNode
と同期して実行されることが保証されます。
この機構を実現するため、関連付けられた 2 つのオブジェクト、
AudioWorkletNode
と
AudioWorkletProcessor
を定義しなければなりません。
前者は他の AudioNode
オブジェクトと同様にメイングローバルスコープの
インターフェイスを表し、後者は AudioWorkletGlobalScope
という特別なスコープ内で内部オーディオ処理を
実装します。
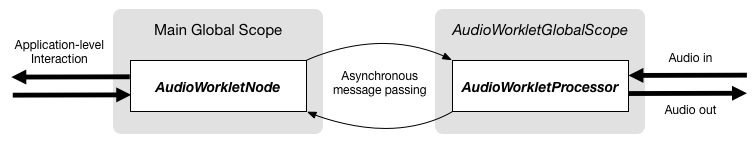
AudioWorkletNode
と
AudioWorkletProcessor
各 BaseAudioContext
は正確に 1 つの
AudioWorklet
を持ちます。
AudioWorklet
の
worklet グローバルスコープ型は
AudioWorkletGlobalScope
です。
AudioWorklet
の
worklet デスティネーション型は
"audioworklet" です。
addModule(moduleUrl)
メソッドを介してスクリプトをインポートすると、
AudioWorkletProcessor
のクラス定義が
AudioWorkletGlobalScope
に登録されます。インポートされたクラスコンストラクターと、
そのコンストラクターから作成されたアクティブなインスタンスのために
2 つの内部ストレージ領域があります。
AudioWorklet
には 1 つの内部スロットがあります:
-
ノード名からパラメーター記述子へのマップ。これは、 ノード名からプロセッサー コンストラクターへのマップと同一の文字列キー集合を含み、 対応する parameterDescriptors 値に関連付けられたマップです。この内部ストレージは、 レンダリングスレッドで
registerProcessor()メソッドを呼び出した結果として設定されます。設定は、 コンテキストのaudioWorklet上でaddModule()が返す Promise が解決される前に完了することが保証されます。
// bypass-processor.js スクリプトファイル。AudioWorkletGlobalScope 上で実行される class BypassProcessorextends AudioWorkletProcessor{ process( inputs, outputs) { // 単一入力、単一チャンネル。 const input= inputs[ 0 ]; const output= outputs[ 0 ]; output[ 0 ]. set( input[ 0 ]); // アクティブな入力がある間のみ処理する。 return false ; } }; registerProcessor( 'bypass-processor' , BypassProcessor);
// メイングローバルスコープ const context= new AudioContext(); context. audioWorklet. addModule( 'bypass-processor.js' ). then(() => { const bypassNode= new AudioWorkletNode( context, 'bypass-processor' ); });
メイングローバル
スコープで AudioWorkletNode
がインスタンス化されると、対応する AudioWorkletProcessor
も
AudioWorkletGlobalScope
内で作成されます。これら 2 つのオブジェクトは、
§ 2 処理モデルで説明されている非同期メッセージパッシングを介して
通信します。
1.32.3.
AudioWorkletGlobalScope
インターフェイス
この特別な実行コンテキストは、オーディオ
レンダリングスレッド内のスクリプトを直接使用して、
オーディオデータの生成、処理、および解析を可能にするよう設計されています。ユーザーが提供した
スクリプトコードは、このスコープ内で評価され、1 つ以上の
AudioWorkletProcessor
サブクラスを定義し、それらはさらに
メインスコープ内の AudioWorkletNode
と 1:1 で関連付けられた
AudioWorkletProcessor
のインスタンス化に使用されます。
1 つ以上の
AudioWorkletNode
を含む各
AudioContext
には、正確に 1 つの AudioWorkletGlobalScope
が存在します。
インポートされたスクリプトの実行は、
[HTML] で定義されているように UA によって行われます。
[HTML] で指定された既定値を上書きし、
AudioWorkletGlobalScope
はユーザーエージェントによって任意に
終了されてはなりません。
AudioWorkletGlobalScope
には次の内部スロットがあります:
-
ノード名からプロセッサーコンストラクターへのマップ。 これは、 プロセッサー名 →
AudioWorkletProcessorConstructorインスタンスのキーと値のペアを格納するマップです。 初期状態ではこのマップは空であり、registerProcessor()メソッドが呼び出されたときに設定されます。 -
保留中のプロセッサー構築データは、 対応する
AudioWorkletProcessorをインスタンス化するためにAudioWorkletNodeコンストラクターによって生成された一時データを格納します。 保留中のプロセッサー構築データ には次の項目が含まれます:-
ノード参照 は初期状態では空です。このストレージは、
AudioWorkletNodeコンストラクターから転送されるAudioWorkletNode参照のためのものです。 -
転送されたポート は初期状態では空です。このストレージは、
AudioWorkletNodeコンストラクターから転送される、逆シリアル化されたMessagePortのためのものです。
-
注: AudioWorkletGlobalScope
には、これらのインスタンス間で共有するその他のデータや
コードを含めることもできます。たとえば、複数の
プロセッサーがウェーブテーブルまたは
インパルス応答を定義する ArrayBuffer を共有することがあります。
注: AudioWorkletGlobalScope
は単一の
BaseAudioContext
およびそのコンテキスト用の単一のオーディオレンダリングスレッドに
関連付けられます。これにより、並行スレッド内で実行されるグローバル
スコープコードにデータ競合が発生することを防ぎます。
callback =AudioWorkletProcessorConstructor AudioWorkletProcessor (object ); [options Global =(Worklet ,AudioWorklet ),Exposed =AudioWorklet ]interface AudioWorkletGlobalScope :WorkletGlobalScope {undefined registerProcessor (DOMString name ,AudioWorkletProcessorConstructor processorCtor );readonly attribute unsigned long long currentFrame ;readonly attribute double currentTime ;readonly attribute float sampleRate ;readonly attribute unsigned long renderQuantumSize ;readonly attribute MessagePort port ; };
1.32.3.1. 属性
currentFrame, 型は unsigned long long、読み取り専用-
処理中のオーディオブロックの現在のフレーム。 これは、
BaseAudioContextの[[current frame]]内部スロットの値と等しくなければなりません。 currentTime, 型は double、読み取り専用-
処理中のオーディオブロックのコンテキスト時刻。これは
BaseAudioContextのcurrentTime属性の値と等しくなければなりません。 sampleRate, 型は float、読み取り専用-
関連付けられた
BaseAudioContextのサンプルレート。 renderQuantumSize, 型は unsigned long、読み取り専用-
関連付けられた
BaseAudioContextのプライベートスロット レンダー量子サイズの値。 port, 型は MessagePort、読み取り専用-
AudioWorklet上のポートに接続されたMessagePort。注: この
portの"message"イベントにイベントリスナーを登録する作者は、 リソースを回収できるようにするため、MessageChannelのどちらか一方の端 (AudioWorklet側またはAudioWorkletGlobalScope側)でcloseを呼び出すべきです。
1.32.3.2. メソッド
registerProcessor(name, processorCtor)-
AudioWorkletProcessorから派生したクラスコンストラクターを登録します。registerProcessor(name, processorCtor)メソッドが呼び出されたとき、次の手順を実行します。いずれかの 手順で例外が投げられた場合、残りの 手順を中止します。-
name が空文字列の場合、
NotSupportedErrorを投げます。 -
name がすでに ノード名からプロセッサー コンストラクターへのマップのキーとして存在する場合、
NotSupportedErrorを投げます。 -
IsConstructor(argument=processorCtor)の結果がfalseの場合、TypeErrorを投げます。 -
prototypeをGet(O=processorCtor, P="prototype")の結果とします。 -
Type(argument=prototype)の結果がObjectでない場合、TypeErrorを投げます。 -
parameterDescriptorsValue を、
Get(O=processorCtor, P="parameterDescriptors")の結果とします。 -
parameterDescriptorsValue が
undefinedでない場合、次の手順を実行します:-
parameterDescriptorSequence を、 parameterDescriptorsValue から
sequence<AudioParamDescriptor>型の IDL 値への 変換の結果とします。 -
paramNames を空の Array とします。
-
parameterDescriptorSequence の各
descriptor について:
-
paramName を、 descriptor 内のメンバー
nameの値とします。paramNames がすでに paramName 値を含む場合、NotSupportedErrorを投げます。 -
paramName を paramNames 配列へ追加します。
-
defaultValue を、 descriptor 内の メンバー
defaultValueの値とします。 -
minValue を、 descriptor 内の メンバー
minValueの値とします。 -
maxValue を、 descriptor 内の メンバー
maxValueの値とします。 -
式 minValue <= defaultValue <= maxValue が false の場合、
InvalidStateErrorを投げます。
-
-
-
キーと値のペア name → processorCtor を、関連付けられた
AudioWorkletGlobalScopeの ノード名からプロセッサー コンストラクターへのマップ に追加します。 -
メディア要素タスクをキューに入れ、キーと値のペア name → parameterDescriptorSequence を、関連付けられた
BaseAudioContextの ノード名からパラメーター記述子への マップに追加します。
注: クラスコンストラクターは 1 回だけ 検索されるべきであり、そのため 登録後に動的に変更される機会はありません。
AudioWorkletGlobalScope.registerProcessor(name, processorCtor) メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 nameDOMString✘ ✘ 登録するクラスコンストラクターを表す文字列キー。このキーは、 AudioWorkletNodeの構築中にAudioWorkletProcessorのコンストラクターを検索するために使用されます。processorCtorAudioWorkletProcessorConstructor✘ ✘ AudioWorkletProcessorから拡張されたクラスコンストラクター。戻り値の型:undefined -
1.32.3.3.
AudioWorkletProcessor
のインスタンス化
AudioWorkletNode
の構築の終了時に、
スレッド間転送のために、
プロセッサー
構築データ
という名前の 構造体
が準備されます。この
構造体
には次の
項目が含まれます:
-
name。これは、 ノード名からプロセッサーコンストラクターへのマップ で検索される
DOMStringです。 -
node。これは、作成された
AudioWorkletNodeへの参照です。 -
options。これは、
AudioWorkletNodeのconstructorに渡された、シリアル化されたAudioWorkletNodeOptionsです。 -
port。これは、
AudioWorkletNodeのportと対になった、シリアル化されたMessagePortです。
転送されたデータが AudioWorkletGlobalScope
に到着すると、
レンダリングスレッド
は次のアルゴリズムを呼び出します:
-
constructionData を、 制御スレッドから転送された プロセッサー構築データとします。
-
processorName、nodeReference、および serializedPort を、それぞれ constructionData の name、 node、および port とします。
-
serializedOptions を constructionData の options とします。
-
deserializedPort を、 StructuredDeserialize(serializedPort, 現在の Realm) の結果とします。
-
deserializedOptions を、 StructuredDeserialize(serializedOptions, 現在の Realm) の結果とします。
-
processorCtor を、
AudioWorkletGlobalScopeの ノード名からプロセッサーコンストラクターへの マップで processorName を検索した結果とします。 -
nodeReference と deserializedPort を、それぞれこの
AudioWorkletGlobalScopeの 保留中のプロセッサー構築データ の ノード参照 と 転送されたポート に格納します。 -
processorCtor から、 deserializedOptions を引数として コールバック関数を構築します。コールバックで例外が投げられた場合、 制御スレッドへ タスクをキューに入れ、nodeReference で
processorerrorという名前のイベントを、ErrorEventを使用して発火します。 -
保留中のプロセッサー構築データ スロットを空にします。
1.32.4.
AudioWorkletNode
インターフェイス
このインターフェイスは、
制御スレッド上に存在する、
ユーザー定義の AudioNode
を表します。ユーザーは
BaseAudioContext
から AudioWorkletNode
を作成でき、そのような
ノードを他の組み込み AudioNode
と接続して
オーディオグラフを形成できます。
| プロパティ | 値 | 注記 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| テールタイム | 注記を参照 | あらゆる テールタイムは ノード自体によって処理されます |
各 AudioWorkletProcessor
には、初期値が true の アクティブ
ソースフラグが関連付けられています。このフラグにより、
入力が接続されていない場合でも、ノードはメモリ内に保持され、
オーディオ処理を実行します。
AudioWorkletNode
から送信されるすべてのタスクは、
関連付けられた BaseAudioContext
のタスクキューへ送信されます。
[Exposed =Window ]interface {AudioParamMap readonly maplike <DOMString ,AudioParam >; };
このインターフェイスには、readonly maplike によってもたらされる
"entries"、"forEach"、"get"、"has"、"keys"、
"values"、@@iterator メソッド、および "size" getter があります。
[Exposed =Window ,SecureContext ]interface AudioWorkletNode :AudioNode {constructor (BaseAudioContext ,context DOMString ,name optional AudioWorkletNodeOptions = {});options readonly attribute AudioParamMap parameters ;readonly attribute MessagePort port ;attribute EventHandler onprocessorerror ; };
1.32.4.1. コンストラクター
AudioWorkletNode(context, name, options)-
AudioWorkletNode.constructor() メソッドの引数。 パラメーター 型 null 許容 省略可能 説明 contextBaseAudioContext✘ ✘ この新しい AudioWorkletNodeが関連付けられるBaseAudioContext。nameDOMString✘ ✘ BaseAudioContextの ノード名からパラメーター 記述子へのマップのキーとなる文字列。optionsAudioWorkletNodeOptions✘ ✔ この AudioWorkletNodeの省略可能な初期パラメーター値。コンストラクターが呼び出されたとき、ユーザーエージェントは 制御スレッド上で次の手順を実行しなければなりません:
AudioWorkletNodeコンストラクターが context、nodeName、options を指定して呼び出されたとき:-
nodeName が
BaseAudioContextの ノード名からパラメーター 記述子へのマップのキーとして存在しない場合、InvalidStateError例外を投げ、これらの手順を中止します。 -
node を this 値とします。
-
context と options を 引数として、node の AudioNode を初期化します。
-
options を使用して、node の 入力、出力、および出力チャンネルを構成します。 例外が投げられた場合、残りの手順を 中止します。
-
messageChannel を新しい
MessageChannelとします。 -
nodePort を、 messageChannel の
port1属性の値とします。 -
processorPortOnThisSide を、 messageChannel の
port2属性の値とします。 -
serializedProcessorPort を、 StructuredSerializeWithTransfer(processorPortOnThisSide, « processorPortOnThisSide ») の結果とします。
-
options 辞書を optionsObject に 変換します。
-
serializedOptions を、 StructuredSerialize(optionsObject) の結果とします。
-
node の
portを nodePort に設定します。 -
parameterDescriptors を、 ノード名からパラメーター 記述子へのマップから nodeName を取得した結果とします:
-
audioParamMap を新しい
AudioParamMapオブジェクトとします。 -
parameterDescriptors の各 descriptor について:
-
paramName を、 descriptor 内の
nameメンバーの値とします。 -
audioParam を新しい
AudioParamインスタンスとし、automationRate、defaultValue、minValue、 およびmaxValueの値を、 descriptor 上の対応するメンバーの値と 等しくします。 -
キーと値のペア paramName → audioParam を audioParamMap の エントリーへ追加します。
-
-
options 上に
parameterDataが 存在する場合、次の手順を 実行します:-
parameterData を
parameterDataの値とします。 -
parameterData の各 paramName → paramValue について:
-
audioParamMap に キー paramName を持つマップエントリーが 存在する場合、そのエントリーを audioParamInMap とします。
-
audioParamInMap の
valueプロパティを paramValue に設定します。
-
-
-
node の
parametersを audioParamMap に設定します。
-
-
制御 メッセージをキューに入れ、 対応する
AudioWorkletProcessorのconstructorを、次の要素からなる プロセッサー構築データを使用して 呼び出します: nodeName、 node、 serializedOptions、および serializedProcessorPort。
-
1.32.4.2. 属性
onprocessorerror, 型は EventHandler-
プロセッサーの
constructor、processメソッド、 またはユーザー定義のクラスメソッドから未処理の例外が投げられた場合、プロセッサーは メディア要素タスクをキューに入れ、イベントを発火して、processorerrorという名前のイベントを、関連付けられたAudioWorkletNodeに対してErrorEventを使用して発火します。ErrorEventは制御スレッド上で、そのmessage、filename、lineno、colno属性を適切に指定して作成および初期化されます。未処理の例外が一度投げられると、プロセッサーは そのライフタイム全体にわたって無音を出力することに注意してください。
parameters, 型は AudioParamMap、 読み取り専用-
parameters属性は、関連付けられた名前を持つAudioParamオブジェクトのコレクションです。この maplike オブジェクトは、インスタンス化時にAudioWorkletProcessorクラスコンストラクター内のAudioParamDescriptorのリストから設定されます。 port, 型は MessagePort、読み取り専用-
各
AudioWorkletNodeには、MessagePortである関連付けられたportがあります。 これは、対応するAudioWorkletProcessorオブジェクト上のポートに接続され、AudioWorkletNodeとそのAudioWorkletProcessorの間の双方向通信を可能にします。注: この
portの"message"イベントにイベントリスナーを登録する作者は、リソースを回収できるようにするため、MessageChannelのどちらか一方の端(AudioWorkletProcessor側またはAudioWorkletNode側)でcloseを呼び出すべきです。
1.32.4.3.
AudioWorkletNodeOptions
AudioWorkletNodeOptions
辞書は、
AudioWorkletNode
のインスタンス内の属性を初期化するために使用できます。
dictionary AudioWorkletNodeOptions :AudioNodeOptions {unsigned long numberOfInputs = 1;unsigned long numberOfOutputs = 1;sequence <unsigned long >outputChannelCount ;record <DOMString ,double >parameterData ;object processorOptions ; };
1.32.4.3.1.
AudioWorkletNodeOptions
辞書のメンバー
numberOfInputs, 型は unsigned long、既定値は1-
これは、
AudioNodeのnumberOfInputs属性の値を初期化するために使用されます。 numberOfOutputs, 型は unsigned long、既定値は1-
これは、
AudioNodeのnumberOfOutputs属性の値を初期化するために使用されます。 outputChannelCount, 型はsequence<unsigned long>-
この配列は、各出力のチャンネル数を 構成するために使用されます。
parameterData, 型は record<DOMString, double>-
これは、
AudioWorkletNode内で名前が一致するAudioParamの初期valueを設定するために使用される、ユーザー定義のキーと値のペアのリストです。 processorOptions, 型は object-
これは、
AudioWorkletNodeに関連付けられたAudioWorkletProcessorインスタンス内のカスタムプロパティを初期化するために使用できる 任意のユーザー定義データを保持します。
1.32.4.3.2.
AudioWorkletNodeOptions
によるチャンネルの構成
次のアルゴリズムは、AudioWorkletNodeOptions
を使用して
さまざまなチャンネル構成を設定する方法を説明します。
-
node を、このアルゴリズムに 与えられた
AudioWorkletNodeインスタンスとします。 -
numberOfInputsとnumberOfOutputsの両方が 0 の場合、NotSupportedErrorを投げ、残りの手順を中止します。 -
-
outputChannelCount内のいずれかの値が 0 であるか、 実装がサポートする最大チャンネル数を 超える場合、NotSupportedErrorを投げ、 残りの手順を中止します。 -
outputChannelCountの長さがnumberOfOutputsと等しくない場合、IndexSizeErrorを投げ、残りの 手順を中止します。 -
numberOfInputsとnumberOfOutputsの両方が 1 の場合、 node の出力のチャンネル数をoutputChannelCount内の唯一の値に設定します。 -
それ以外の場合、node の k 番目の出力の チャンネル数を、
outputChannelCountシーケンスの k 番目の要素に設定し、戻ります。
-
-
-
numberOfInputsとnumberOfOutputsの両方が 1 の場合、 node の出力の初期チャンネル数を 1 に設定し、戻ります。注: この場合、出力の チャンネル数は、実行時の入力と
channelCountModeに基づいて computedNumberOfChannels へ動的に 変更されます。 -
それ以外の場合、node の各出力のチャンネル数を 1 に設定し、戻ります。
-
1.32.5.
AudioWorkletProcessor
インターフェイス
このインターフェイスは、オーディオ
レンダリングスレッド上で実行されるオーディオ処理コードを表します。
これは AudioWorkletGlobalScope
内に存在し、クラスの定義が実際のオーディオ処理を実装します。
AudioWorkletProcessor
の構築は、
AudioWorkletNode
の構築の結果としてのみ発生できることに注意してください。
[Exposed =AudioWorklet ]interface AudioWorkletProcessor {constructor ();readonly attribute MessagePort port ; };callback AudioWorkletProcessCallback =boolean (FrozenArray <FrozenArray <Float32Array >>,inputs FrozenArray <FrozenArray <Float32Array >>,outputs object );parameters
AudioWorkletProcessor
には 2 つの内部スロットがあります:
[[node reference]]-
関連付けられた
AudioWorkletNodeへの参照。 [[callable process]]-
process() が 呼び出し可能な有効な関数であるかどうかを表すブールフラグ。
1.32.5.1. コンストラクター
AudioWorkletProcessor()-
AudioWorkletProcessorのコンストラクターが呼び出されたとき、 次の手順が レンダリングスレッド上で実行されます。-
nodeReference を、現在の
AudioWorkletGlobalScopeの 保留中のプロセッサー構築 データ上の ノード参照 を検索した結果とします。 スロットが空の場合、TypeError例外を投げます。 -
processor を this 値とします。
-
processor の
[[node reference]]を nodeReference に設定します。 -
processor の
[[callable process]]をtrueに設定します。 -
deserializedPort を、 保留中のプロセッサー構築 データから 転送された ポート を検索した結果とします。
-
processor の
portを deserializedPort に設定します。 -
保留中のプロセッサー構築 データ スロットを空にします。
-
1.32.5.2. 属性
port, 型は MessagePort、読み取り専用-
各
AudioWorkletProcessorには、MessagePortである関連付けられたportがあります。 これは対応するAudioWorkletNodeオブジェクト上のポートに接続され、AudioWorkletNodeとそのAudioWorkletProcessorの間の双方向通信を可能にします。注: この
portの"message"イベントにイベントリスナーを登録する作者は、リソースを回収できるようにするため、MessageChannelのどちらか一方の端(AudioWorkletProcessor側またはAudioWorkletNode側)でcloseを呼び出すべきです。
1.32.5.3.
コールバック AudioWorkletProcessCallback
ユーザーは AudioWorkletProcessor
を拡張することで、カスタムオーディオプロセッサーを定義できます。
サブクラスは、オーディオ処理
アルゴリズムを実装する
process()
という名前の AudioWorkletProcessCallback
を定義しなければならず、
parameterDescriptors
という名前の静的プロパティを持つことができます。これは
AudioParamDescriptor
の iterable です。
process() コールバック関数は、 グラフをレンダリングするときに指定されているように処理されます。
AudioWorkletProcessor
に関連付けられた
AudioWorkletNode
のライフタイムを制御します。
このライフタイムポリシーは、次のような 組み込みノードに見られるさまざまな手法をサポートできます:
-
入力を変換し、接続された入力やスクリプト参照が存在する間だけ アクティブになるノード。このような ノードは process() から
falseを返すべきであり、これにより 接続された入力の有無によってAudioWorkletNodeが アクティブに 処理中であるかどうかを決定できます。 -
入力を変換するものの、入力が切断された後も テールタイムの間アクティブであり続けるノード。 この場合、process() は、
inputsが 0 チャンネルを含むことが判明した後の 一定期間、trueを返すべきです。 このテールタイム区間の開始と終了を測定するため、 グローバルスコープのcurrentTimeから現在時刻を取得できます。または、 プロセッサーの内部状態に応じて 区間を動的に計算することもできます。 -
通常はライフタイムを持つ、出力のソースとして機能するノード。 このようなノードは、出力を生成しなくなる時点まで process() から
trueを返すべきです。
前述の定義は、process()
の実装から戻り値が提供されない場合、
false を返すことと同一の効果になることを意味する点に注意してください
(有効な戻り値は falsy 値である undefined
であるためです)。
これは、アクティブな入力がある場合のみ
アクティブになる AudioWorkletProcessor
にとって妥当な動作です。
以下の例は、AudioWorkletProcessor
内で AudioParam
を定義して使用する方法を示します。
class MyProcessorextends AudioWorkletProcessor{ static get parameterDescriptors() { return [{ name: 'myParam' , defaultValue: 0.5 , minValue: 0 , maxValue: 1 , automationRate: "k-rate" }]; } process( inputs, outputs, parameters) { // 最初の入力と出力を取得する。 const input= inputs[ 0 ]; const output= outputs[ 0 ]; const myParam= parameters. myParam; // 単一の入力と出力のための単純な増幅器。なお、 // automationRate は "k-rate" なので、各レンダー量子について // インデックス [0] に単一の値を持つ。 for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { output[ channel][ i] = input[ channel][ i] * myParam[ 0 ]; } } } }
1.32.5.3.1.
コールバック AudioWorkletProcessCallback
のパラメーター
以下では、AudioWorkletProcessCallback
関数のパラメーターについて説明します。
一般に、inputs
と
outputs
の配列は、メモリ割り当てが行われないよう、
呼び出し間で再利用されます。ただし、たとえば入力または
出力のチャンネル数が変わるなど、トポロジーが変更された場合は、
新しい配列が再割り当てされます。inputs
または
outputs
配列のいずれかの部分が
転送された場合も、新しい配列が再割り当てされます。
inputs, 型はFrozenArray<FrozenArray<Float32Array>>-
ユーザーエージェントによって提供される、入力接続からの入力オーディオバッファー。
inputs[n][m]は、第 \(n\) 入力の第 \(m\) チャンネルのオーディオサンプルを含むFloat32Arrayです。入力数は構築時に固定されますが、チャンネル数は computedNumberOfChannels に基づいて動的に変更できます。現在のレンダー量子について、
AudioWorkletNodeの第 \(n\) 入力に接続されたアクティブに処理中のAudioNodeが存在しない場合、inputs[n]の内容は空の配列となり、 利用可能な入力チャンネルが 0 であることを示します。これはinputs[n]の要素数が 0 になり得る唯一の状況です。 outputs, 型はFrozenArray<FrozenArray<Float32Array>>-
ユーザーエージェントによって使用される出力オーディオバッファー。
outputs[n][m]は、第 \(n\) 出力の第 \(m\) チャンネルの オーディオサンプルを含むFloat32Arrayオブジェクトです。各Float32Arrayは 0 で埋められています。出力のチャンネル数が computedNumberOfChannels と一致するのは、 ノードが単一の出力を持つ場合だけです。 parameters, 型はobject-
name → parameterValues の順序付きマップ。
parameters["name"]は parameterValues を返します。これは nameAudioParamのオートメーション値を持つFrozenArray<Float32Array> です。各配列について、配列にはレンダー量子内のすべてのフレームについてのパラメーターの computedValue が含まれます。 ただし、このレンダー量子中にオートメーションがスケジュールされていない場合、 配列は長さ 1 でもよく、その配列要素は レンダー 量子に対する
AudioParamの定数値です。このオブジェクトは、次の手順に従って凍結されます
-
parameter を、名前とパラメーター値の順序付き マップとします。
-
SetIntegrityLevel(parameter, frozen)
アルゴリズムで計算された、この凍結された順序付きマップが、
parameters引数へ渡されます。注: これはオブジェクトを変更できないことを意味し、 したがって、配列の長さが変化しない限り、 連続する呼び出しで同じオブジェクトを使用できます。
-
1.32.5.4.
AudioParamDescriptor
AudioParamDescriptor
辞書は、
AudioWorkletNode
で使用される AudioParam
オブジェクトのプロパティを指定するために使用されます。
dictionary AudioParamDescriptor {required DOMString name ;float defaultValue = 0;float minValue = -3.4028235e38;float maxValue = 3.4028235e38;AutomationRate automationRate = "a-rate"; };
1.32.5.4.1.
AudioParamDescriptor
辞書のメンバー
これらのメンバーの値には制約があります。制約については、AudioParamDescriptor を処理する アルゴリズムを参照してください。
automationRate, 型は AutomationRate、既定値は"a-rate"-
既定のオートメーションレートを表します。
defaultValue, 型は float、既定値は0-
パラメーターの既定値を表します。
maxValue, 型は float、既定値は3.4028235e38-
最大値を表します。
minValue, 型は float、既定値は-3.4028235e38-
最小値を表します。
name, 型は DOMString-
パラメーターの名前を表します。
1.32.6. AudioWorklet のイベントシーケンス
次の図は、AudioWorklet
に関連して発生する理想化されたイベントシーケンスを示します:
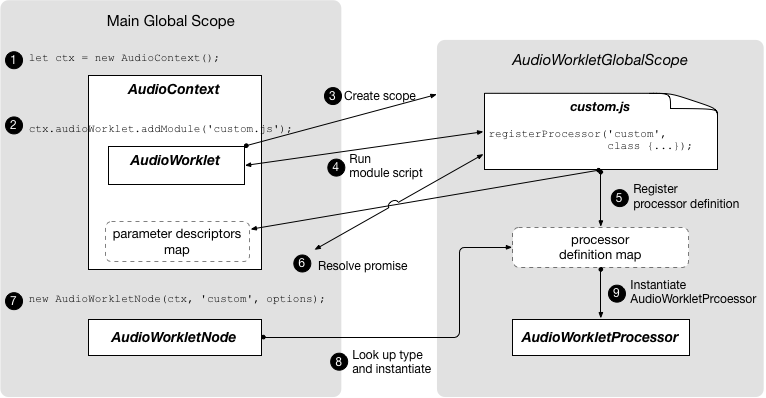
AudioWorklet
のシーケンス
図に示されている手順は、
AudioContext
と、それに関連付けられた AudioWorkletGlobalScope
の作成に続き、
AudioWorkletNode
とそれに関連付けられた
AudioWorkletProcessor
を作成する場合に起こり得るイベントシーケンスの 1 つです。
-
AudioContextが作成されます。 -
メインスコープで、
context.audioWorkletにスクリプトモジュールの追加を要求します。 -
まだ存在しないため、新しい
AudioWorkletGlobalScopeがコンテキストに関連付けられて作成されます。これは、AudioWorkletProcessorクラス定義が評価されるグローバルスコープです。(以降の呼び出しでは、以前に作成されたこのスコープが 使用されます。) -
インポートされたスクリプトが、新しく作成されたグローバルスコープ内で実行されます。
-
インポートされたスクリプトの実行の一部として、
AudioWorkletProcessorが、AudioWorkletGlobalScope内のキー(上の図では"custom")の下に登録されます。 これにより、グローバルスコープとAudioContextの両方のマップが設定されます。 -
addModule()呼び出しの Promise が解決されます。 -
メインスコープで、ユーザーが指定したキーと オプション辞書を使用して
AudioWorkletNodeが作成されます。 -
ノードの作成の一部として、このキーを使用して、 インスタンス化する正しい
AudioWorkletProcessorサブクラスを検索します。 -
AudioWorkletProcessorサブクラスのインスタンスが、 同じオプション辞書の構造化クローンを使用して インスタンス化されます。このインスタンスは、以前に作成されたAudioWorkletNodeと対になります。
1.32.7. AudioWorklet の例
1.32.7.1. BitCrusher ノード
ビットクラッシングは、サンプル値を量子化する
(より低いビット深度をシミュレートする)ことと、時間分解能を量子化する
(より低いサンプルレートをシミュレートする)ことの両方によって、
オーディオストリームの品質を低下させる仕組みです。この例は、
AudioWorkletProcessor
内で AudioParam
(この場合は a-rate として扱われます)を
使用する方法を示します。
const context= new AudioContext(); context. audioWorklet. addModule( 'bitcrusher.js' ). then(() => { const osc= new OscillatorNode( context); const amp= new GainNode( context); // Worklet ノードを作成する。'BitCrusher' は、 // bitcrusher.js がインポートされたときに以前に登録された // AudioWorkletProcessor を識別する。オプションは対応する名前の // AudioParam を自動的に初期化する。 const bitcrusher= new AudioWorkletNode( context, 'bitcrusher' , { parameterData: { bitDepth: 8 } }); osc. connect( bitcrusher). connect( amp). connect( context. destination); osc. start(); });
class Bitcrusherextends AudioWorkletProcessor{ static get parameterDescriptors() { return [{ name: 'bitDepth' , defaultValue: 12 , minValue: 1 , maxValue: 16 }, { name: 'frequencyReduction' , defaultValue: 0.5 , minValue: 0 , maxValue: 1 }]; } constructor () { super (); this . _phase= 0 ; this . _lastSampleValue= 0 ; } process( inputs, outputs, parameters) { const input= inputs[ 0 ]; const output= outputs[ 0 ]; const bitDepth= parameters. bitDepth; const frequencyReduction= parameters. frequencyReduction; if ( bitDepth. length> 1 ) { for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { let step= Math. pow( 0.5 , bitDepth[ i]); // frequencyReduction 配列の長さが 1 の場合を処理するため、 // インデックス指定には剰余を使用する。 this . _phase+= frequencyReduction[ i% frequencyReduction. length]; if ( this . _phase>= 1.0 ) { this . _phase-= 1.0 ; this . _lastSampleValue= step* Math. floor( input[ channel][ i] / step+ 0.5 ); } output[ channel][ i] = this . _lastSampleValue; } } } else { // この呼び出しでは bitDepth が一定であることが分かっているため、 // step の計算をループの外に出すことができ、 // 多くの演算を節約できる。 const step= Math. pow( 0.5 , bitDepth[ 0 ]); for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { this . _phase+= frequencyReduction[ i% frequencyReduction. length]; if ( this . _phase>= 1.0 ) { this . _phase-= 1.0 ; this . _lastSampleValue= step* Math. floor( input[ channel][ i] / step+ 0.5 ); } output[ channel][ i] = this . _lastSampleValue; } } } // 値を返す必要はない。このノードのライフタイムは、その // 入力接続だけに依存する。 } }; registerProcessor( 'bitcrusher' , Bitcrusher);
注: AudioWorkletProcessor
クラスの定義では、
作者が提供したコンストラクターが this でない明示的な戻り値を持つ場合、
または super() を適切に呼び出さない場合、
InvalidStateError
が投げられます。
1.32.7.2. VU メーターノード
この単純な音量メーターの例は、
ネイティブな AudioNode
のように動作し、
コンストラクターオプションを受け取り、
AudioWorkletNode
と
AudioWorkletProcessor
の間のスレッド間通信(非同期)をカプセル化する
AudioWorkletNode
サブクラスを作成する方法をさらに示します。
このノードは出力を使用しません。
/* vumeter-node.js: メイングローバルスコープ */ export default class VUMeterNodeextends AudioWorkletNode{ constructor ( context, updateIntervalInMS) { super ( context, 'vumeter' , { numberOfInputs: 1 , numberOfOutputs: 0 , channelCount: 1 , processorOptions: { updateIntervalInMS: updateIntervalInMS|| 16.67 } }); // AudioWorkletNode 内の状態 this . _updateIntervalInMS= updateIntervalInMS; this . _volume= 0 ; // AudioWorkletProcessor から更新された値を処理する this . port. onmessage= event=> { if ( event. data. volume) this . _volume= event. data. volume; } this . port. start(); } get updateInterval() { return this . _updateIntervalInMS; } set updateInterval( updateIntervalInMS) { this . _updateIntervalInMS= updateIntervalInMS; this . port. postMessage({ updateIntervalInMS: updateIntervalInMS}); } draw() { // 音量値に基づいて VU メーターを描画する // |this._updateIntervalInMS| ミリ秒ごとに。 } };
/* vumeter-processor.js: AudioWorkletGlobalScope */ const SMOOTHING_FACTOR= 0.9 ; const MINIMUM_VALUE= 0.00001 ; registerProcessor( 'vumeter' , class extends AudioWorkletProcessor{ constructor ( options) { super (); this . _volume= 0 ; this . _updateIntervalInMS= options. processorOptions. updateIntervalInMS; this . _nextUpdateFrame= this . _updateIntervalInMS; this . port. onmessage= event=> { if ( event. data. updateIntervalInMS) this . _updateIntervalInMS= event. data. updateIntervalInMS; } } get intervalInFrames() { return this . _updateIntervalInMS/ 1000 * sampleRate; } process( inputs, outputs, parameters) { const input= inputs[ 0 ]; // 入力はモノラルへダウンミックスされることに注意。ただし、入力が // 接続されていない場合は、0 チャンネルが渡される。 if ( input. length> 0 ) { const samples= input[ 0 ]; let sum= 0 ; let rms= 0 ; // 二乗和を計算する。 for ( let i= 0 ; i< samples. length; ++ i) sum+= samples[ i] * samples[ i]; // RMS レベルを計算し、音量を更新する。 rms= Math. sqrt( sum/ samples. length); this . _volume= Math. max( rms, this . _volume* SMOOTHING_FACTOR); // 音量プロパティを更新し、メインスレッドと同期する。 this . _nextUpdateFrame-= samples. length; if ( this . _nextUpdateFrame< 0 ) { this . _nextUpdateFrame+= this . intervalInFrames; this . port. postMessage({ volume: this . _volume}); } } // 音量がしきい値を上回る場合は処理を続け、 // 入力を切断してもメーターが平滑化された値の計算を // 直ちに停止しないようにする。 return this . _volume>= MINIMUM_VALUE; } });
/* index.js: メイングローバルスコープ、エントリーポイント */ import VUMeterNodefrom './vumeter-node.js' ; const context= new AudioContext(); context. audioWorklet. addModule( 'vumeter-processor.js' ). then(() => { const oscillator= new OscillatorNode( context); const vuMeterNode= new VUMeterNode( context, 25 ); oscillator. connect( vuMeterNode); oscillator. start(); function drawMeter() { vuMeterNode. draw(); requestAnimationFrame( drawMeter); } drawMeter(); });
1.33.
AudioPlaybackStats
インターフェイス
AudioContext
を通じて再生されるオーディオのアンダーランおよびレイテンシー統計を提供します。
オーディオが再生デバイスへ時間どおりに届けられない場合、 オーディオアンダーランが発生します。これにより再生信号に不連続が生じ、 一般に「グリッチ」と呼ばれる、聞き取れる「クリック」音が発生します。 こうしたグリッチはユーザー体験に悪影響を与えるため、発生した場合に アプリケーションが検出し、再生を改善するための何らかの処置を 取れることが有用です。
AudioPlaybackStats
はオーディオ統計を報告する専用オブジェクトであり、
AudioContext
の
AudioDestinationNode
および関連付けられたオーディオ出力デバイスを介した再生経路について、
オーディオアンダーランと再生レイテンシーの統計を報告します。これにより、
アプリケーションは次の理由で発生し得るアンダーランを測定できます:
-
オーディオグラフが複雑すぎて、システムが時間どおりにオーディオを生成できず、 アンダーランが発生する。
-
何らかの外部問題によってアンダーランが発生する。このような問題の例:
-
同じ再生デバイスへオーディオを再生している別のプログラムが正常に動作していない。
-
システム全体で CPU が過負荷になっている。
-
サーマルスロットリングによってシステムが過負荷になっている。
-
アンダーランは、アンダーランフレームと アンダーランイベントによって定義されます:
-
アンダーラン フレームとは、出力デバイスによって再生されたものの、
AudioContextから提供されなかったオーディオフレームです。 これは、再生経路が出力デバイスへオーディオフレームを 時間どおりに提供できなかった場合に発生し、その場合でも何かを再生する必要があります。注: アンダーランフレームは通常、無音です。
-
アンダーラン イベントとは、連続する アンダーランフレーム のシーケンスの再生です。 アンダーランイベントの継続時間は、 アンダーラン フレームのシーケンスの合計継続時間です。
[Exposed =Window ,SecureContext ]interface AudioPlaybackStats {readonly attribute double underrunDuration ;readonly attribute unsigned long underrunEvents ;readonly attribute double totalDuration ;readonly attribute double averageLatency ;readonly attribute double minimumLatency ;readonly attribute double maximumLatency ;undefined resetLatency (); [Default ]object (); };toJSON
各 AudioContext
は正確に 1 つの AudioPlaybackStats
を持ちます。
AudioPlaybackStats
には次の内部スロットがあります:
[[audio context]]-
この
AudioPlaybackStatsインスタンスが関連付けられているAudioContext。 作成時に所有元のAudioContextに初期化されます。 [[underrun duration]]-
最後の統計更新時点までに
[[audio context]]の再生で発生したすべての アンダーランイベントの合計継続時間を表す double。 0 に初期化されます。 [[underrun events]]-
最後の統計更新時点までに
[[audio context]]の再生で発生した アンダーランイベントの合計数を表す int。 0 に初期化されます。 [[total duration]]-
最後の統計更新時点までの
[[audio context]]の再生におけるすべてのフレームの合計継続時間(秒)を表す double で、[[underrun duration]]+currentTime [[average latency]]-
現在追跡中の区間にわたる[[audio context]]の平均オーディオ出力レイテンシーを表す double。 [[minimum latency]]-
現在追跡中の区間にわたる[[audio context]]の最小オーディオ出力レイテンシーを表す double。 0 に初期化されます。 [[maximum latency]]-
現在追跡中の区間にわたる[[audio context]]の最大オーディオ出力レイテンシーを表す double。 0 に初期化されます。 [[latency reset time]]-
レイテンシー統計が最後にリセットされた時刻を表す double。これは
currentTimeのクロックドメイン内にあります。 0 に初期化されます。currently tracked intervalは、[[latency reset time]]から現在のcurrentTimeまでの区間です。
1.33.1. 属性
注: これらの属性は、特定の条件下で 1 秒に 1 回だけ更新されます。詳細については、§ 1.33.3 統計の更新および § 1.33.4.2 緩和策を参照してください。
underrunDuration, 型は double、読み取り専用-
[[underrun duration]]内部スロットの値を返します。注: このメトリックは、
totalDurationと組み合わせて、AudioContextによって提供されなかった再生済みメディアの割合を 計算するために使用できます。
underrunEvents, 型は unsigned long、読み取り専用-
[[underrun events]]内部スロットの値を返します。
totalDuration, 型は double、読み取り専用-
[[total duration]]内部スロットの値を返します。
averageLatency, 型は double、読み取り専用-
[[average latency]]内部スロットの値を返します。
minimumLatency, 型は double、読み取り専用-
[[minimum latency]]内部スロットの値を返します。
maximumLatency, 型は double、読み取り専用-
[[maximum latency]]内部スロットの値を返します。
1.33.2. メソッド
resetLatency()-
レイテンシー統計を追跡する区間の開始を 現在時刻に設定します。
resetLatencyが呼び出されたとき、次の手順を実行します:-
[[latency reset time]]をcurrentTimeに設定します。 -
currentLatency を、
[[audio context]]によって最後に再生されたフレームの再生レイテンシーとし、 まだフレームが再生されていない場合は 0 とします。 -
[[average latency]]を currentLatency に設定します。 -
[[minimum latency]]を currentLatency に設定します。 -
[[maximum latency]]を currentLatency に設定します。
-
1.33.3. 統計の更新
-
[[audio context]]が実行中でない場合、これらの手順を中止します。 -
canUpdate を false とします。
-
document を、現在の this の 関連するグローバルオブジェクトの関連付けられた Documentとします。 document が完全にアクティブで、document の 可視性状態が
"visible"の場合、 canUpdate を true に設定します。 -
permission を、"microphone" アクセスに関連付けられた権限の 権限状態とします。 permission が "granted" の場合、canUpdate を true に設定します。
-
canUpdate が false の場合、これらの手順を中止します。
-
[[underrun duration]]を、[[audio context]]が構築されてからその再生で発生した すべての アンダーランイベント の合計継続時間 (秒)に設定します。 -
[[underrun events]]を、[[audio context]]が構築されてからその再生で発生した アンダーランイベント の合計数に設定します。 -
[[total duration]]を[[underrun duration]]+[[audio context]].currentTimeに設定します。 -
[[average latency]]を、現在追跡中の区間にわたる[[audio context]]の再生の平均再生レイテンシー(秒)に設定します。 -
[[minimum latency]]を、現在追跡中の区間にわたる[[audio context]]の再生の最小再生レイテンシー(秒)に設定します。 -
[[maximum latency]]を、現在追跡中の区間にわたる[[audio context]]の再生の最大再生レイテンシー(秒)に設定します。
1.33.4.
AudioPlaybackStats
のプライバシーに関する考慮事項
1.33.4.1. リスク
オーディオアンダーラン情報は、協調する 2 つのサイト間で クロスサイト隠れチャネルを形成するために使用される可能性があります。 一方のサイトが意図的にオーディオグリッチを発生させることで (たとえば非常に高い CPU 使用率を発生させることで)情報を送信し、 もう一方のサイトがこれらのグリッチを検出できます。注: この隠れチャネルは特定のシステム特性に 依存します。 通常、共有の直列化点(OS やブラウザーの オーディオミキサーなど)と、その点から実質的に同期するコールバックが必要であり、 負荷の急増を平坦化する中間バッファリングがないことが必要です。
1.33.4.2. 緩和策
このような隠れチャネルの使用を抑制するため、API は次の 緩和策を実装します。-
API が返す値は、1 秒に 1 回を超えて 更新されてはなりません。
-
API は、次の基準の少なくとも 1 つを満たすサイトに 制限されなければなりません:
-
サイトが getUserMedia 権限を取得している。
注: その理由は、サイトが getUserMedia 権限を取得している場合、マイクを使用してグリッチ情報を受信したり、 効率的に通信したりできるため、
AudioPlaybackStatsが提供する情報へのアクセスが冗長になるからです。これらの方法には、 マイク信号の途切れによるグリッチの検出や、 人間には聞こえない正弦波を使用した通信が含まれます。マイクへのアクセスが この点で将来より安全になった場合、この条件は再検討されるべきです。 -
文書が完全にアクティブで、その 可視性状態が
"visible"である。注: 協調するどちらのサイトにも マイク権限がないと仮定すると、 この基準により、隠れ信号を受信するサイトは 可視でなければならず、隠れチャネルを利用できる条件が制限されます。 サイトが可視でない間に、隠れチャネルを使用して 相互に通信することを不可能にします。
-
2. 処理モデル
2.1. 背景
この節は非規範的です。
低レイテンシーを必要とするリアルタイムオーディオシステムは、 多くの場合コールバック関数を使用して実装されます。再生を途切れさせないために さらにオーディオを計算する必要があるとき、オペレーティングシステムが プログラムをコールバックします。このようなコールバックは理想的には 高優先度スレッド(多くの場合、システム上で最高優先度)で呼び出されます。 これは、オーディオを扱うプログラムが このコールバックからのみコードを実行することを意味します。スレッド境界を越えたり、 レンダリングスレッドとコールバックの間にバッファリングを追加したりすると、 自然にレイテンシーが増加したり、システムがグリッチに弱くなったりします。
このため、Web プラットフォーム上で非同期 操作を実行する従来の方法であるイベントループは、 スレッドが継続的に実行されるわけではないため、ここでは機能しません。 さらに、従来の実行コンテキスト(Window と Worker)からは、 不要で潜在的にブロッキングする多数の操作が利用可能であり、 許容可能なレベルのパフォーマンスを実現するうえで望ましくありません。
また、Worker モデルでは、スクリプト実行コンテキストごとに
専用スレッドを作成する必要がありますが、通常はすべての AudioNode
が同じ実行コンテキストを共有します。
注: この節では、最終結果がどのようになるべきかを 指定しており、どのように実装すべきかを指定しているわけではありません。 特に、メッセージキューを使用する代わりに、 メモリ操作が並べ替えられない限り、 実装者はスレッド間で共有されるメモリを使用できます。
2.2. 制御スレッドとレンダリングスレッド
Web Audio API は、制御スレッドと レンダリングスレッドを使用して 実装されなければなりません。
制御スレッドは、
AudioContext
がインスタンス化され、作者が
オーディオグラフを操作するスレッドです。つまり、
BaseAudioContext
に対する操作が呼び出されるスレッドです。レンダリング
スレッド
は、制御スレッドからの呼び出しに応じて、
実際のオーディオ出力が計算されるスレッドです。AudioContext
のオーディオを計算する場合は
リアルタイムのコールバックベースのオーディオスレッドであり得ますし、
OfflineAudioContext
のオーディオを計算する場合は通常のスレッドであり得ます。
制御スレッドは、 [HTML] で説明されている従来のイベントループを使用します。
レンダリングスレッド は、オーディオグラフの レンダリングの節で説明されている専用のレンダリングループを使用します。
制御 スレッドから レンダリング スレッドへの通信は、制御メッセージの受け渡しを使用して行われます。 逆方向の通信は、通常のイベントループ タスクを使用して行われます。
各 AudioContext
には単一の 制御
メッセージキュー
があり、これは レンダリングスレッド上で実行される操作である
制御メッセージのリストです。
制御メッセージをキューに入れるとは、
メッセージを BaseAudioContext
の 制御メッセージキューの末尾に追加することを意味します。
注: たとえば、
AudioBufferSourceNode
source 上で start() を正常に呼び出すと、
関連付けられた BaseAudioContext
の 制御メッセージ
キューに 制御
メッセージが追加されます。
制御メッセージは、 制御メッセージ キュー内で挿入時刻順に並べられます。 したがって、最も古いメッセージは、 制御メッセージキューの先頭にあるものです。
-
QC を新しい空の 制御メッセージ キューとします。
-
QA のすべての 制御メッセージを QC へ移動します。
-
QB のすべての 制御メッセージを QA へ移動します。
-
QC のすべての 制御メッセージを QB へ移動します。
2.3. 非同期操作
AudioNode
のメソッド呼び出しは実質的に非同期であり、
同期部分と非同期部分の 2 段階で
行われなければなりません。各メソッドでは、実行の一部が
制御スレッド上で行われ
(たとえば、無効なパラメーターの場合に例外を投げる)、
一部は レンダリング
スレッド上で行われます(たとえば、AudioParam
の値を変更する)。
AudioNode
および
BaseAudioContext
に対する各操作の説明では、
同期節には ⌛ が付けられます。それ以外の
すべての操作は、[HTML] で説明されているように、
並列に実行されます。
同期節は 制御スレッド上で直ちに実行されます。 失敗した場合、メソッドの実行は中止され、 例外が投げられる可能性があります。成功した場合、 レンダリングスレッド上で 実行される操作をエンコードした 制御 メッセージが、この レンダリングスレッドの 制御メッセージ キューに追加されます。
同期節と非同期節の他のイベントに対する順序は 同じでなければなりません。同期節と非同期節がそれぞれ ASync と AAsync、 BSync と BAsync である 2 つの操作 A と B があり、 A が B より前に発生する場合、 ASync は BSync より前に発生し、 AAsync は BAsync より前に発生します。言い換えると、同期節と 非同期節を並べ替えることはできません。
2.4. サポートされるサンプルレート
実装は 3000 Hz 以上 768000 Hz 以下のサンプルレートを
サポートしなければなりません。この
範囲外のサンプルレートが指定された場合、NotSupportedError
を投げなければなりません。
2.5. サポートされるレンダー量子サイズ
実装は、1 サンプルフレームからコンテキストのサンプルレートの 6 倍までの
[[render quantum size]]
をサポートしなければなりません。コンテキストのサンプルレートの 6 倍が
整数でない場合は、最も近い整数へ切り捨てます。
この範囲外の [[render quantum size]]
が指定された場合、NotSupportedError
を投げなければなりません。
ScriptProcessorNode
インターフェイスを最大バッファーサイズ 16384、
サポートされる最低サンプルレート 3000 Hz で使用するアプリケーションを
サポートするために選択されました。
コンテキストのサンプルレートが 3000 Hz の場合、サポートされる範囲は [1,
18000] です。サンプルレートが高いほど、上限も高くなります。
2.6. オーディオグラフのレンダリング
オーディオグラフのレンダリングはサンプルフレームのブロック単位で行われ、
各ブロックのサイズは BaseAudioContext
のライフタイム中、一定のままです。ブロック内の
サンプルフレーム数は レンダー量子サイズと呼ばれ、ブロック
自体は レンダー
量子と呼ばれます。既定値は 128 で、
renderSizeHint
を設定することで構成できます。
特定のスレッド上でアトミックに発生する操作は、 別のスレッド上で他の アトミック 操作が実行されていない場合にのみ実行できます。
BaseAudioContext
G から、制御メッセージ
キュー
Q を使用してオーディオのブロックをレンダリングするアルゴリズムは、
複数の手順で構成され、
グラフのレンダリングアルゴリズムでさらに詳しく説明されます。
AudioContext
の レンダリングスレッドは、
一定間隔で周期的に呼び出される
システムレベルの
オーディオコールバックによって駆動されます。
各呼び出しには システムレベルのオーディオコールバックバッファー
サイズがあり、これは次の システムレベルのオーディオコールバックが到着する前に
時間どおりに計算する必要がある、変動するサンプルフレーム数です。
負荷値は、
各 システムレベルのオーディオ
コールバックについて、その実行時間を、
システムレベルの
オーディオコールバックバッファーサイズを sampleRate
で割った値で除算することによって計算されます。
理想的には 負荷値は 1.0 未満であり、 これはオーディオのレンダリングに要した時間が、 その再生に要した時間より短かったことを意味します。オーディオバッファー アンダーランは、この 負荷値が 1.0 より大きい場合に発生します。つまり、 システムはリアルタイムに十分な速度でオーディオをレンダリングできませんでした。
システムレベルのオーディオコールバックおよび 負荷
値の概念は、OfflineAudioContext
には適用されないことに注意してください。
オーディオコールバックも 制御メッセージキュー内のタスクとしてキューに入れられます。
UA は、要求されたバッファーサイズを満たすためにレンダー量子を処理し、
このタスクを完了するため、次のアルゴリズムを実行しなければなりません。
制御メッセージ
キューに加えて、各 AudioContext
には通常の タスク
キューがあり、制御スレッドからレンダリングスレッドへ投稿されるタスクのために
関連付けられたタスクキュー
と呼ばれます。
レンダー量子の処理後には追加のマイクロタスクチェックポイントが実行され、
AudioWorkletProcessor
の process メソッドの実行中にキューへ追加された可能性のある
マイクロタスクが実行されます。
AudioWorkletNode
から投稿されるすべてのタスクは、関連付けられた BaseAudioContext
の 関連付けられたタスクキューへ投稿されます。
-
BaseAudioContextの内部スロット[[current frame]]を 0 に設定します。また、currentTimeも 0 に設定します。
-
render result を
falseとします。 -
制御メッセージキューを処理します。
-
Qrendering を空の 制御メッセージ キューとします。Qrendering を現在の 制御メッセージキューと アトミックに交換します。
-
Qrendering にメッセージが存在する間、 次の手順を実行します:
-
-
BaseAudioContextの 関連付けられたタスクキューを処理します。-
task queue を、
BaseAudioContextの 関連付けられたタスクキューとします。 -
task count を task queue 内のタスク数とします。
-
task count が 0 でない間、次の手順を実行します:
-
oldest task を task queue 内の最初の実行可能なタスクとし、 task queue から削除します。
-
レンダリングループの現在実行中のタスクを oldest task に設定します。
-
oldest task の手順を実行します。
-
レンダリングループの現在実行中のタスクを
nullに戻します。 -
task count を 1 減らします。
-
マイクロタスクチェックポイントを実行します。
-
-
-
レンダー量子を処理します。
-
BaseAudioContextの[[rendering thread state]]がrunningでない場合、false を返します。 -
BaseAudioContextの処理対象となるAudioNodeを順序付けします。-
ordered node list を、
AudioNodeとAudioListenerの空のリストとします。 この順序付けアルゴリズムが終了すると、AudioNodeとAudioListenerの順序付けされたリストが含まれます。 -
nodes を、この
BaseAudioContextによって作成され、 まだ生存しているすべてのノードの集合とします。 -
AudioListenerを nodes に追加します。 -
cycle breakers を空の
DelayNodeの集合とします。これは 循環の一部であるすべてのDelayNodeを含むことになります。 -
nodes 内の各
AudioNodenode について:-
node が循環の一部である
DelayNodeの場合、これを cycle breakers に追加し、nodes から削除します。
-
-
cycle breakers 内の各
DelayNodedelay について:-
delayWriter と delayReader を、それぞれ delay の DelayWriter と DelayReader とします。 delayWriter と delayReader を nodes に追加します。delay をすべての入力および 出力から切断します。
注: これにより 循環が切断されます。
DelayNodeが 循環内にある場合、循環内のディレイラインは 1 レンダー量子未満には できないため、その 2 つの端を別々に扱うことができます。
-
-
nodes に循環が含まれる場合、その循環の一部である すべての
AudioNodeをミュートし、 nodes から削除します。 -
nodes 内のすべての要素を未マークとみなします。 nodes に未マークの要素が存在する間:
-
nodes 内の要素 node を選択します。
-
node を訪問します。
-
-
ordered node list の順序を逆にします。
-
-
このブロックについて
AudioListenerのAudioParamの値を計算します。 -
ordered node list 内の各
AudioNodeについて:-
この
AudioNodeの各AudioParamについて、次の手順を実行します:-
この
AudioParamにAudioNodeが接続されている場合、 このAudioParamに接続されたすべてのAudioNodeによって読み取り可能にされたバッファーを 合計し、 結果のバッファーをモノラルチャンネルにダウンミックスして、 このバッファーを 入力 AudioParam バッファーと呼びます。 -
このブロックについて、この
AudioParamの値を計算します。 -
制御 メッセージをキューに入れ、この
AudioParamの[[current value]]スロットを § 1.6.3 値の計算に従って設定します。
-
-
この
AudioNodeの入力にAudioNodeが接続されている場合、 このAudioNodeに接続されたすべてのAudioNodeによって読み取り可能にされたバッファーを 合計します。 結果のバッファーは 入力バッファーと呼ばれます。 このAudioNodeの入力チャンネル数と一致するように アップミックスまたはダウンミックスします。 -
この
AudioNodeが ソースノードの場合、 オーディオのブロックを計算し、 読み取り可能にします。 -
この
AudioNodeがAudioWorkletNodeの場合、次のサブステップを実行します:-
processor を、
AudioWorkletNodeに関連付けられたAudioWorkletProcessorインスタンスとします。 -
O を processor に対応する ECMAScript オブジェクトとします。
-
processCallback を未初期化の変数とします。
-
completion を未初期化の変数とします。
-
スクリプトを実行する準備を、 現在の設定オブジェクトを使用して行います。
-
コールバックを実行する準備を、 現在の設定オブジェクトを使用して行います。
-
getResult を Get(O, "process") とします。
-
getResult が abrupt completion の場合、completion を getResult に設定し、return とラベル付けされた手順へ移動します。
-
processCallback を getResult.[[Value]] に設定します。
-
! IsCallable(processCallback) が
falseの場合:-
completion を新しい Completion {[[Type]]: throw, [[Value]]: 新しく作成された TypeError オブジェクト, [[Target]]: empty} に設定します。
-
return とラベル付けされた手順へ移動します。
-
-
[[callable process]]をtrueに設定します。 -
次のサブステップを実行します:
-
args を、
inputs、outputs、 およびparametersからなる Web IDL 引数リストとします。 -
esArgs を、args を ECMAScript 引数 リストへ 変換した結果とします。
-
callResult を Call(processCallback, O, esArgs) とします。この操作は esArgs を使用して オーディオのブロックを計算します。 関数呼び出しに成功すると、
outputsを介して渡されたFloat32Arrayの要素のコピーを含むバッファーが 読み取り可能にされます。 この呼び出し内で解決されたPromiseは、AudioWorkletGlobalScopeのマイクロタスクキューに追加されます。 -
callResult が abrupt completion の場合、completion を callResult に設定し、 return とラベル付けされた手順へ移動します。
-
processor の アクティブ ソースフラグを ToBoolean(callResult.[[Value]]) に設定します。
-
-
Return: この時点で、 completion は ECMAScript の completion 値に設定されています。
-
コールバックの実行後に クリーンアップを、現在の設定 オブジェクトを使用して行います。
-
スクリプトの 実行後にクリーンアップを、現在の設定 オブジェクトを使用して行います。
-
completion が abrupt completion の場合:
-
[[callable process]]をfalseに設定します。 -
processor の アクティブソースフラグを
falseに設定します。 -
タスクをキューに入れ、 制御スレッドで、 関連付けられた
AudioWorkletNodeに対してErrorEventを使用し、processorerrorという名前のイベントを 発火します。
-
-
-
-
この
AudioNodeが デスティネーションノードの場合、 このAudioNodeの入力を記録します。
-
-
次の手順をアトミックに 実行します:
-
[[current frame]]を レンダー量子サイズだけ増加させます。 -
currentTimeを、[[current frame]]をsampleRateで割った値に設定します。
-
-
render result を
trueに設定します。
-
-
render result を返します。
AudioNode
をミュートするとは、
このオーディオブロックのレンダリング中、その
出力が無音でなければならないことを意味します。
AudioNode
からバッファーを
読み取り可能にするとは、
この AudioNode
に接続された他の
AudioNode
が安全に
読み取れる状態にすることを意味します。
注: たとえば、実装は新しいバッファーを 割り当てることも、 より高度な仕組みを使用して、現在未使用になった既存のバッファーを 再利用することもできます。
AudioNode
の入力を記録する
とは、この AudioNode
の入力データを将来の
使用のためにコピーすることを意味します。
オーディオの
ブロックを計算するとは、
この AudioNode
のアルゴリズムを実行して、
[[render quantum size]]
個のサンプルフレームを生成することを意味します。
入力
バッファーを処理するとは、
入力
バッファーと、この
AudioNode
の AudioParam
の値を入力として使用して、
AudioNode
のアルゴリズムを実行することを意味します。
2.7. AudioContext
での中断の処理
中断とは、
AudioContext
のオーディオ再生を停止する必要があるときにユーザーエージェントによって生成される
イベントです。たとえば、別のアプリケーションが
オーディオ出力ハードウェアへの排他的アクセスを要求した場合、ユーザーエージェントは
中断を生成することがあります。
中断が発生したとき、
ユーザーエージェントは AudioContext
を中断するための制御メッセージをキューに入れなければなりません。
context という
AudioContext
                を中断する
-
context の
[[rendering thread state]]がclosedまたはinterruptedの場合、 これらの手順を中止します。 -
context の
[[rendering thread state]]がrunningの場合:-
システム リソースの解放を試みます。
-
次の手順を実行するためにメディア要素タスクをキューに入れます:
-
context の
[[control thread state]]をinterruptedに設定します。 -
context の
[[state before interruption]]スロットを "running" に設定します。 -
context で
statechangeという名前のイベントを発火します。
-
-
-
context の
[[rendering thread state]]がsuspendedの場合:-
次の手順を実行するためにメディア要素タスクをキューに入れます:
-
context の
[[control thread state]]をinterruptedに設定します。 -
context の
[[state before interruption]]スロットを "suspended" に設定します。
-
-
-
context の
[[rendering thread state]]をinterruptedに設定します。
注: AudioContext
が suspended
の場合、
ユーザーのアクティビティを過剰に共有すること(たとえば、電話の着信時や画面が
ロックされたとき)を避けるプライバシー上の理由から、statechange
イベントは発火されません。
中断が終了すると、
ユーザーエージェントは AudioContext
の中断を終了する
AudioContext
context の
中断を終了するための
制御メッセージ
を実行することは、レンダリング
スレッド上で次の手順を実行することを意味します:
-
context の
[[rendering thread state]]がinterruptedでない場合、 これらの手順を中止します。 -
context の
[[state before interruption]]が "running" の場合:-
システムリソースの取得を試みます。
-
AudioContext上の[[rendering thread state]]を "running" に設定します。 -
オーディオグラフのレンダリングを開始します。
-
次の手順を実行するためにメディア要素タスクをキューに入れます:
-
AudioContextのstate属性がまだ "running" でない場合:-
context の
[[control thread state]]を "running" に設定します。 -
context で
statechangeという名前のイベントを発火します。
-
-
-
-
context の
[[state before interruption]]が "suspended" の場合-
AudioContext上の[[rendering thread state]]をsuspendedに設定します。 -
次の手順を実行するためにメディア要素タスクをキューに入れます:
-
context の
[[control thread state]]をsuspendedに設定します。
-
-
-
context の
[[state before interruption]]をnullに設定します。
2.8. AudioContext
におけるシステムオーディオリソースからのエラーの処理
AudioContext
audioContext は、オーディオシステムリソースエラーが発生した場合、
レンダリングスレッド上で次の手順を実行します。
-
audioContext の
[[rendering thread state]]がrunningまたはinterruptedの場合:-
システム リソースの解放を試みます。
-
audioContext の
[[rendering thread state]]をsuspendedに設定します。 -
次の手順を実行するためにメディア要素タスクをキューに入れます:
-
audioContext の
[[suspended by user]]をfalseに設定します。 -
audioContext の
[[control thread state]]をsuspendedに設定します。 -
audioContext で
statechangeという名前のイベントを発火します。
-
これらの手順を中止します。
-
-
audioContext の
[[rendering thread state]]がsuspendedの場合:-
次の手順を実行するためにメディア要素タスクをキューに入れます:
-
注: システムオーディオリソースエラーの例として、
AudioContext
のアクティブなレンダリング中に外部またはワイヤレスのオーディオデバイスが
切断される場合があります。
2.9. 文書のアンロード
BaseAudioContext
を使用する文書について、追加の文書アンロード
クリーンアップ手順が定義されます:
-
関連するグローバルオブジェクトが 文書に関連付けられた Window と同じである各
AudioContextおよびOfflineAudioContextについて、[[pending promises]]のすべての Promise をInvalidStateErrorで拒否します。 -
すべての
decoding threadを停止します。 -
AudioContextまたはOfflineAudioContextをclose()するための制御メッセージをキューに入れます。
3. 動的ライフタイム
3.1. 背景
注: AudioContext
と AudioNode
のライフタイム特性の規範的な説明は、
AudioContext のライフタイムおよび AudioNode のライフタイムで説明されています。
この節は非規範的です。
静的なルーティング構成を作成できることに加えて、 ライフタイムが限られた動的に割り当てられるボイスに対して、 カスタムエフェクトルーティングを行える必要もあります。 この説明では、こうした短命なボイスを「ノート」と呼ぶことにします。 多くのオーディオアプリケーションはノートの概念を取り入れており、 例としてドラムマシン、シーケンサー、ゲームプレイに応じて 多数のワンショットサウンドがトリガーされる 3D ゲームがあります。
従来のソフトウェアシンセサイザーでは、ノートは 利用可能なリソースのプールから動的に割り当てられ、解放されます。 MIDI ノートオンメッセージを受信するとノートが割り当てられます。 ノートがサンプルデータの末尾に達した(ループしない場合)、 エンベロープのサステインフェーズが 0 に達した、 または MIDI ノートオフメッセージによってエンベロープのリリースフェーズへ移行し、 再生を終えたときに解放されます。 MIDI ノートオフの場合、ノートはすぐには解放されず、 リリースエンベロープフェーズが終了したときにのみ解放されます。 任意の時点で多数のノートが再生されている可能性がありますが、 新しいノートがルーティンググラフへ追加され、 古いノートが解放されるため、ノートの集合は常に変化します。
オーディオシステムは、個々の「ノート」イベントに対する
ルーティンググラフの一部の解体を自動的に処理します。「ノート」は
AudioBufferSourceNode
で表され、
他の処理ノードへ直接接続できます。ノートの再生が
終了すると、コンテキストは AudioBufferSourceNode
への参照を自動的に解放し、
それにより接続先ノードへの参照も解放され、以降も同様に続きます。
ノードはグラフから自動的に切断され、
参照がなくなると削除されます。動的なボイス間で共有され、
長寿命であるグラフ内のノードは明示的に管理できます。
複雑に聞こえますが、これらはすべて追加の処理なしに
自動的に行われます。
3.2. 例
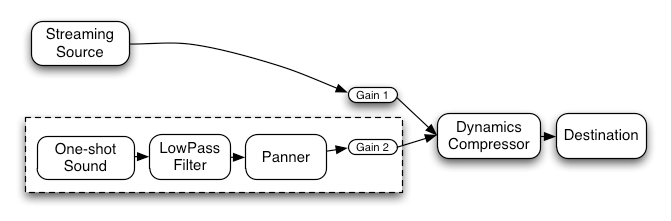
ローパスフィルター、パンナー、2 番目のゲインノードは ワンショットサウンドから直接接続されています。そのため、再生が終了すると コンテキストはそれら(点線内のすべて)を自動的に解放します。 ワンショットサウンドおよび接続されたノードへの参照が なくなると、それらは直ちにグラフから削除され、 破棄されます。ストリーミングソースはグローバル参照を持ち、 明示的に切断されるまで接続されたままです。 JavaScript では次のようになります:
let context= 0 ; let compressor= 0 ; let gainNode1= 0 ; let streamingAudioSource= 0 ; // ルーティンググラフの「長寿命」部分の初期設定 function setupAudioContext() { context= new AudioContext(); compressor= context. createDynamicsCompressor(); gainNode1= context. createGain(); // ストリーミングオーディオソースを作成する。 const audioElement= document. getElementById( 'audioTagID' ); streamingAudioSource= context. createMediaElementSource( audioElement); streamingAudioSource. connect( gainNode1); gainNode1. connect( compressor); compressor. connect( context. destination); } // 後で何らかのユーザー操作(通常はマウスまたはキーイベント)に応じて // ワンショットサウンドを再生できる。 function playSound() { const oneShotSound= context. createBufferSource(); oneShotSound. buffer= dogBarkingBuffer; // フィルター、パンナー、ゲインノードを作成する。 const lowpass= context. createBiquadFilter(); const panner= context. createPanner(); const gainNode2= context. createGain(); // 接続を行う oneShotSound. connect( lowpass); lowpass. connect( panner); panner. connect( gainNode2); gainNode2. connect( compressor); // 0.75 秒後に再生する(即時再生するには 0 を渡す) oneShotSound. start( context. currentTime+ 0.75 ); }
4. チャンネルのアップミックスとダウンミックス
この節は規範的です。
AudioNode の入力には、そこへのすべての接続からのチャンネルを結合するための
ミキシング
規則があります。単純な例として、入力がモノラル出力と
ステレオ出力から接続されている場合、通常はモノラル接続が
ステレオへアップミックスされ、ステレオ接続と合計されます。
しかし当然、各 AudioNode
のすべての入力について、正確な ミキシング
規則を定義することが重要です。
すべての入力の既定のミキシング規則は、
特に非常に一般的なモノラルおよびステレオストリームの場合に、
詳細をあまり気にせず「そのまま動作」するよう選択されています。
もちろん、特にマルチチャンネルなどの高度なユースケースでは、
規則を変更できます。
いくつかの用語を定義すると、アップミックスとは、 より少ないチャンネル数のストリームを、 より多いチャンネル数のストリームへ変換する処理を指します。ダウンミックスとは、 より多いチャンネル数のストリームを、 より少ないチャンネル数のストリームへ変換する処理を指します。
AudioNode
の入力は、この入力に接続されたすべての出力を
ミックスする必要があります。この処理の一部として、
任意の時点での入力の実際のチャンネル数を表す内部値
computedNumberOfChannels を計算します。
AudioNode
の各入力について、実装は次を
行わなければなりません:
-
computedNumberOfChannels を計算します。
-
入力への各接続について:
-
ノードの
channelInterpretation属性で指定されたChannelInterpretation値に従って、接続を computedNumberOfChannels へ アップミックスまたはダウンミックスします。 -
他の接続からの、他のすべてのミックス済みストリームと ミックスします。これは、各接続について手順 1 で アップミックスまたはダウンミックス された対応する各チャンネルを単純に合計するものです。
-
4.1. スピーカーチャンネルレイアウト
channelInterpretation
が
"speakers"
の場合、
特定のチャンネルレイアウトについて
アップミックスとダウンミックスが定義されます。
モノラル(1 チャンネル)、ステレオ(2 チャンネル)、クアッド(4 チャンネル)、 および 5.1(6 チャンネル)をサポートしなければなりません。この仕様の将来のバージョンでは、 その他のチャンネルレイアウトがサポートされる可能性があります。
4.2. チャンネル順序
チャンネル順序は次の表で定義されます。個々の マルチチャンネル形式は、すべての中間チャンネルをサポートしない場合があります。 実装は、存在しないチャンネルを飛ばしながら、 以下で定義された順序で提供されるチャンネルを提示しなければなりません。
| 順序 | ラベル | モノラル | ステレオ | クアッド | 5.1 |
|---|---|---|---|---|---|
| 0 | SPEAKER_FRONT_LEFT | 0 | 0 | 0 | 0 |
| 1 | SPEAKER_FRONT_RIGHT | 1 | 1 | 1 | |
| 2 | SPEAKER_FRONT_CENTER | 2 | |||
| 3 | SPEAKER_LOW_FREQUENCY | 3 | |||
| 4 | SPEAKER_BACK_LEFT | 2 | 4 | ||
| 5 | SPEAKER_BACK_RIGHT | 3 | 5 | ||
| 6 | SPEAKER_FRONT_LEFT_OF_CENTER | ||||
| 7 | SPEAKER_FRONT_RIGHT_OF_CENTER | ||||
| 8 | SPEAKER_BACK_CENTER | ||||
| 9 | SPEAKER_SIDE_LEFT | ||||
| 10 | SPEAKER_SIDE_RIGHT | ||||
| 11 | SPEAKER_TOP_CENTER | ||||
| 12 | SPEAKER_TOP_FRONT_LEFT | ||||
| 13 | SPEAKER_TOP_FRONT_CENTER | ||||
| 14 | SPEAKER_TOP_FRONT_RIGHT | ||||
| 15 | SPEAKER_TOP_BACK_LEFT | ||||
| 16 | SPEAKER_TOP_BACK_CENTER | ||||
| 17 | SPEAKER_TOP_BACK_RIGHT |
4.3. 入力および出力チャンネル数に対するテールタイムの影響
AudioNode
が 0 でない テールタイムと、
入力チャンネル数に依存する出力チャンネル
数を持つ場合、入力チャンネル数が変化するときには、
AudioNode
の テールタイムを考慮しなければなりません。
入力チャンネル数が減少する場合、 より多いチャンネル数で受信された入力が出力へ 影響しなくなった時点で、出力チャンネル数を変更しなければなりません。
入力チャンネル数が増加する場合、動作は
AudioNode
の型に依存します:
-
DelayNodeまたはDynamicsCompressorNodeの場合、より多いチャンネル 数で受信された入力が出力へ影響し始めたときに、 出力チャンネル数を増加させなければなりません。 -
テールタイムを持つその他の
AudioNodeの場合、出力 チャンネル数を直ちに増加させなければなりません。注:
ConvolverNodeの場合、これはインパルス 応答がモノラルである場合にのみ適用されます。それ以外の場合、ConvolverNodeは入力チャンネル数に関係なく、常にステレオ 信号を出力します。
注: 直感的には、これにより処理の一部として ステレオ情報が失われることを防ぎます。つまり、異なるチャンネル数の複数の入力レンダー量子が 1 つの出力レンダー量子に寄与する場合、 出力レンダー量子のチャンネル数は入力レンダー量子の入力チャンネル数の 上位集合になります。
4.4. スピーカーレイアウトのアップミックス
モノラルのアップミックス:

    1 -> 2 : モノラルからステレオへアップミックス
        output.L = input;
        output.R = input;

    1 -> 4 : モノラルからクアッドへアップミックス
        output.L = input;
        output.R = input;
        output.SL = 0;
        output.SR = 0;

    1 -> 5.1 : モノラルから 5.1 へアップミックス
        output.L = 0;
        output.R = 0;
        output.C = input; // センターチャンネルに入れる
        output.LFE = 0;
        output.SL = 0;
        output.SR = 0;

ステレオのアップミックス:

    2 -> 4 : ステレオからクアッドへアップミックス
        output.L = input.L;
        output.R = input.R;
        output.SL = 0;
        output.SR = 0;

    2 -> 5.1 : ステレオから 5.1 へアップミックス
        output.L = input.L;
        output.R = input.R;
        output.C = 0;
        output.LFE = 0;
        output.SL = 0;
        output.SR = 0;

クアッドのアップミックス:

    4 -> 5.1 : クアッドから 5.1 へアップミックス
        output.L = input.L;
        output.R = input.R;
        output.C = 0;
        output.LFE = 0;
        output.SL = input.SL;
        output.SR = input.SR;
4.5. スピーカーレイアウトのダウンミックス
たとえば、5.1 のソース素材を処理しながら ステレオで再生する場合、ダウンミックスが必要になります。
モノラルのダウンミックス:

    2 -> 1 : ステレオからモノラルへ
        output = 0.5 * (input.L + input.R);

    4 -> 1 : クアッドからモノラルへ
        output = 0.25 * (input.L + input.R + input.SL + input.SR);

    5.1 -> 1 : 5.1 からモノラルへ
        output = sqrt(0.5) * (input.L + input.R) + input.C + 0.5 * (input.SL + input.SR)

ステレオのダウンミックス:

    4 -> 2 : クアッドからステレオへ
        output.L = 0.5 * (input.L + input.SL);
        output.R = 0.5 * (input.R + input.SR);

    5.1 -> 2 : 5.1 からステレオへ
        output.L = L + sqrt(0.5) * (input.C + input.SL)
        output.R = R + sqrt(0.5) * (input.C + input.SR)

クアッドのダウンミックス:

    5.1 -> 4 : 5.1 からクアッドへ
        output.L = L + sqrt(0.5) * input.C
        output.R = R + sqrt(0.5) * input.C
        output.SL = input.SL
        output.SR = input.SR
4.6. チャンネル規則の例
// ゲインノードを明示的な 2 チャンネル(ステレオ)に設定する。 gain. channelCount= 2 ; gain. channelCountMode= "explicit" ; gain. channelInterpretation= "speakers" ; // 2 つのステレオ出力バスを持つ DJ アプリ向けに「ハードウェア出力」を 4 チャンネルに設定する。 context. destination. channelCount= 4 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "discrete" ; // カスタムマルチチャンネルスピーカー配列向けに「ハードウェア出力」を 8 チャンネルに設定する // カスタムマトリックスミキシングを使用する。 context. destination. channelCount= 8 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "discrete" ; // HTMLAudioElement を再生するために「ハードウェア出力」を 5.1 に設定する。 context. destination. channelCount= 6 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "speakers" ; // 明示的にモノラルへダウンミックスする。 gain. channelCount= 1 ; gain. channelCountMode= "explicit" ; gain. channelInterpretation= "speakers" ;
5. オーディオ信号値
5.1. オーディオサンプル形式
リニアパルス 符号変調(リニア PCM)は、 オーディオ値が一定間隔でサンプリングされ、連続する 2 つの値の間の 量子化レベルが線形に均一である形式を表します。
この仕様で信号値がスクリプトへ公開される場合、それらは
リニア 32 ビット浮動小数点パルス符号変調形式(リニア 32 ビット float
PCM)であり、多くの場合 Float32Array
オブジェクトの形式です。
5.2. レンダリング
任意のオーディオグラフのデスティネーションノードにおける
すべてのオーディオ信号の範囲は、公称上 [-1, 1] です。この範囲外の
信号値、または NaN、正の無限大、負の
無限大の値のオーディオレンディションは、この仕様では未定義です。
6. 空間化/パンニング
6.1. 背景
現代の 3D ゲームで一般的に要求される機能は、 3D 空間内で複数のオーディオソースを動的に空間化し、移動できることです。 たとえば OpenAL にはこの機能があります。
PannerNode
を使用すると、オーディオストリームを
AudioListener
に対して空間内に空間化または配置できます。
BaseAudioContext
は単一の
AudioListener
を含みます。
パンナーとリスナーの両方は、右手系のデカルト座標系を使用した
3D 空間内の位置を持ちます。座標系で使用される単位は定義されておらず、
定義する必要もありません。これらの座標から計算される効果は、
メートルやフィートなど特定の単位に依存せず不変だからです。
PannerNode
オブジェクト(ソースストリームを表す)は、
音がどの方向へ投射されるかを表す向きベクトルを持ちます。
さらに、音の指向性の程度を表すサウンドコーンを持ちます。
たとえば、音は無指向性であることができ、その場合は向きに関係なく
どこからでも聞こえます。または、より指向性を持ち、
リスナーの方を向いている場合にのみ聞こえることもあります。
AudioListener
オブジェクト(人の耳を表す)は、
人がどの方向を向いているかを表す forward および up ベクトルを持ちます。
空間化の座標系は下の図に示され、
既定値も表示されています。AudioListener
と PannerNode
の位置は、より見やすくするために
既定位置から移動されています。

レンダリング中、PannerNode
は方位角と仰角を計算します。これらの値は、
空間化効果をレンダリングするために実装によって内部的に使用されます。
これらの値がどのように使用されるかの詳細については、パンニングアルゴリズムの節を
参照してください。
6.2. 方位角と仰角
PannerNode
の方位角と仰角を計算するために、
次のアルゴリズムを使用しなければなりません。
実装は、以下の各 AudioParam
が "a-rate"
か "k-rate"
かを適切に考慮しなければなりません。
// |context| を BaseAudioContext、|panner| を // |context| で作成された PannerNode とする。 // ソース-リスナーベクトルを計算する。 const listener= context. listener; const sourcePosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); const sourceListener= sourcePosition. diff( listenerPosition). normalize(); if ( sourceListener. magnitude== 0 ) { // ソースとリスナーが同じ点にある退化ケースを処理する。 azimuth= 0 ; elevation= 0 ; return ; } // 軸を揃える。 const listenerForward= new Vec3( listener. forwardX. value, listener. forwardY. value, listener. forwardZ. value); const listenerUp= new Vec3( listener. upX. value, listener. upY. value, listener. upZ. value); const listenerRight= listenerForward. cross( listenerUp); if ( listenerRight. magnitude== 0 ) { // リスナーの 'up' と 'forward' ベクトルが線形 // 従属で、'right' を決定できない場合を処理する azimuth= 0 ; elevation= 0 ; return ; } // リスナーの right、forward に直交する単位ベクトルを決定する const listenerRightNorm= listenerRight. normalize(); const listenerForwardNorm= listenerForward. normalize(); const up= listenerRightNorm. cross( listenerForwardNorm); const upProjection= sourceListener. dot( up); const projectedSource= sourceListener. diff( up. scale( upProjection)). normalize(); azimuth= 180 * Math. acos( projectedSource. dot( listenerRightNorm)) / Math. PI; // ソースがリスナーの前方または後方にある。 const frontBack= projectedSource. dot( listenerForwardNorm); if ( frontBack< 0 ) azimuth= 360 - azimuth; // 方位角をリスナーの "right" ではなく "forward" ベクトルに対する値にする。 if (( azimuth>= 0 ) && ( azimuth<= 270 )) azimuth= 90 - azimuth; else azimuth= 450 - azimuth; elevation= 90 - 180 * Math. acos( sourceListener. dot( up)) / Math. PI; if ( elevation> 90 ) elevation= 180 - elevation; else if ( elevation< - 90 ) elevation= - 180 - elevation;
6.3. パンニングアルゴリズム
モノラルからステレオおよびステレオからステレオへのパンニングを サポートしなければなりません。入力へのすべての接続がモノラルの場合は モノラルからステレオへの処理を使用します。それ以外の場合は ステレオからステレオへの処理を使用します。
6.3.1. PannerNode "equalpower" パンニング
これは、基本的ではあるものの妥当な結果を提供する、
単純で比較的低コストのアルゴリズムです。
PannerNode
の panningModel
属性が
"equalpower"
に設定されている場合に使用され、その場合は仰角
の値は無視されます。このアルゴリズムは、
automationRate
で指定された適切なレートを使用して実装されなければなりません。
PannerNode
の AudioParam
または AudioListener
の AudioParam
のいずれかが
"a-rate"
である場合、
a-rate 処理を使用しなければなりません。
-
この
AudioNodeによって計算される各サンプルについて:-
azimuth を、方位角と 仰角の節で計算された値とします。
-
azimuth 値をまず、次のように 範囲 [-90, 90] 内に収めます:
// まず、方位角を許容範囲 [-180, 180] にクランプする。 azimuth= max( - 180 , azimuth); azimuth= min( 180 , azimuth); // 次に範囲 [-90, 90] に折り返す。 if ( azimuth< - 90 ) azimuth= - 180 - azimuth; else if ( azimuth> 90 ) azimuth= 180 - azimuth; -
モノラル入力の場合、azimuth から 正規化値 x を次のように計算します:
x
= ( azimuth+ 90 ) / 180 ; またはステレオ入力の場合:
if ( azimuth<= 0 ) { // -90 -> 0 // 方位角の値を [-90, 0] 度から範囲 [-90, 90] へ変換する。 x= ( azimuth+ 90 ) / 90 ; } else { // 0 -> 90 // 方位角の値を [0, 90] 度から範囲 [-90, 90] へ変換する。 x= azimuth/ 90 ; } -
左および右のゲイン値を次のように計算します:
gainL
= cos( x* Math. PI/ 2 ); gainR= sin( x* Math. PI/ 2 ); -
モノラル入力の場合、ステレオ出力を次のように計算します:
outputL
= input* gainL; outputR= input* gainR; それ以外のステレオ入力の場合、出力を次のように計算します:
if ( azimuth<= 0 ) { outputL= inputL+ inputR* gainL; outputR= inputR* gainR; } else { outputL= inputL* gainL; outputR= inputR+ inputL* gainR; } -
距離の計算が 距離 効果で説明され、コーンゲインが サウンドコーンで説明されているとおり、 距離ゲインとコーンゲインを適用します:
let distance= distance(); let distanceGain= distanceModel( distance); let totalGain= coneGain() * distanceGain(); outputL= totalGain* outputL; outputR= totalGain* outputR;
-
6.3.2. PannerNode "HRTF" パンニング(ステレオのみ)
これには、さまざまな方位角と仰角で記録された HRTF (頭部伝達関数)インパルス応答の集合が必要です。 実装には高度に最適化された畳み込み関数が必要です。 "equalpower" より多少コストが高いものの、 より知覚的に空間化された音を提供します。
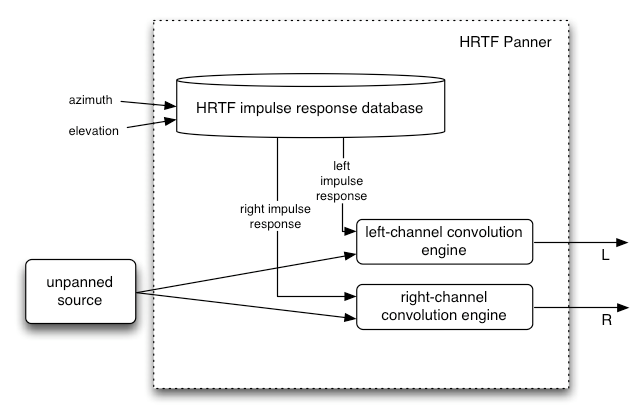
6.3.3. StereoPannerNode パンニング
StereoPannerNode
について、
次のアルゴリズムを
実装しなければなりません。
-
この
AudioNodeによって計算される各サンプルについて-
pan を、この
StereoPannerNodeのpanAudioParamの computedValue とします。 -
pan を [-1, 1] にクランプします。
pan
= max( - 1 , pan); pan= min( 1 , pan); -
pan 値を [0, 1] に正規化して x を計算します。モノラル入力の場合:
x
= ( pan+ 1 ) / 2 ; ステレオ入力の場合:
if ( pan<= 0 ) x= pan+ 1 ; else x= pan; -
左および右のゲイン値を次のように計算します:
gainL
= cos( x* Math. PI/ 2 ); gainR= sin( x* Math. PI/ 2 ); -
モノラル入力の場合、ステレオ出力を次のように計算します:
outputL
= input* gainL; outputR= input* gainR; それ以外のステレオ入力の場合、出力を次のように計算します:
if ( pan<= 0 ) { outputL= inputL+ inputR* gainL; outputR= inputR* gainR; } else { outputL= inputL* gainL; outputR= inputR+ inputL* gainR; }
-
6.4. 距離効果
近い音ほど大きく、遠い音ほど
小さくなります。音の音量がリスナーからの
距離に応じて正確にどのように変化するかは、distanceModel
属性に依存します。
オーディオレンダリング中、パンナーとリスナーの位置に基づいて 次のように距離値が計算されます:
function distance( panner) { const pannerPosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listener= context. listener; const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); return pannerPosition. diff( listenerPosition). magnitude; }
その後、distance を使用して、
distanceModel
属性に依存する distanceGain を計算します。
各距離モデルについてどのように計算されるかの詳細は、DistanceModelType
の節を参照してください。
処理の一部として、PannerNode
は入力オーディオ信号を distanceGain でスケーリング/乗算し、
遠い音を小さく、近い音を大きくします。
6.5. サウンドコーン
リスナーと各音源には、それぞれどの方向を向いているかを表す 向きベクトルがあります。各音源の音の投射特性は、 ソースの向きベクトルに対するソース/リスナー角度の関数として 音の強度を表す内側と外側の「コーン」によって記述されます。 したがって、リスナーを直接向いている音源は、 軸外を向いている場合より大きく聞こえます。 音源は無指向性にすることもできます。
次の図は、リスナーに対するソースの
コーンの関係を示します。図では、
coneInnerAngle
= 50coneOuterAngle
= 120

ソース(PannerNode)
とリスナーを指定して、
コーン効果によるゲイン寄与を計算するために、次のアルゴリズムを
使用しなければなりません:
function coneGain() { const sourceOrientation= new Vec3( source. orientationX, source. orientationY, source. orientationZ); if ( sourceOrientation. magnitude== 0 || (( source. coneInnerAngle== 360 ) && ( source. coneOuterAngle== 360 ))) return 1 ; // コーンが指定されていない - ユニティゲイン // 正規化されたソース-リスナーベクトル const sourcePosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); const sourceToListener= sourcePosition. diff( listenerPosition). normalize(); const normalizedSourceOrientation= sourceOrientation. normalize(); // ソースの向きベクトルとソース-リスナーベクトルの間の角度 const angle= 180 * Math. acos( sourceToListener. dot( normalizedSourceOrientation)) / Math. PI; const absAngle= Math. abs( angle); // API は半角ではなく全角なので、ここで 2 で割る const absInnerAngle= Math. abs( source. coneInnerAngle) / 2 ; const absOuterAngle= Math. abs( source. coneOuterAngle) / 2 ; let gain= 1 ; if ( absAngle<= absInnerAngle) { // 減衰なし gain= 1 ; } else if ( absAngle>= absOuterAngle) { // 最大減衰 gain= source. coneOuterGain; } else { // 内側コーンと外側コーンの間 // 内側 -> 外側で、x は 0 -> 1 へ変化する const x= ( absAngle- absInnerAngle) / ( absOuterAngle- absInnerAngle); gain= ( 1 - x) + source. coneOuterGain* x; } return gain; }
7. パフォーマンスに関する考慮事項
7.1. レイテンシー
Web アプリケーションでは、マウスやキーボードの イベント(keydown、mousedown など)から音が聞こえるまでの 時間遅延が重要です。
この時間遅延はレイテンシーと呼ばれ、複数の要因 (入力デバイスのレイテンシー、内部バッファリングのレイテンシー、DSP 処理 レイテンシー、出力デバイスのレイテンシー、ユーザーの耳と スピーカーとの距離など)によって生じ、累積します。このレイテンシーが大きいほど、 ユーザー体験の満足度は低下します。極端な場合、 音楽制作やゲームプレイが不可能になることがあります。中程度の レベルでも、タイミングに影響し、音が遅れている、 またはゲームの応答が鈍いという印象を与えることがあります。 音楽アプリケーションではタイミングの問題がリズムに影響します。 ゲームでは、タイミングの問題がゲームプレイの精度に影響します。 対話型アプリケーションでは、非常に低いアニメーションフレームレートの場合と ほぼ同様に、一般にユーザー体験を損ないます。 アプリケーションによっては、妥当なレイテンシーは 3〜6 ミリ秒程度から 25〜50 ミリ秒程度までです。
実装は一般に、全体的なレイテンシーを最小化するよう努めます。
全体的なレイテンシーを最小化することに加え、実装は一般に
AudioContext
の currentTime と
AudioProcessingEvent
の playbackTime の差を最小化するよう努めます。
ScriptProcessorNode
が非推奨になることで、
この考慮事項は時間とともに重要性が低下します。
さらに、一部の AudioNode
は、オーディオグラフの一部の経路に
レイテンシーを追加することがあります。特に:
-
AudioWorkletNodeは内部でバッファリングするスクリプトを実行でき、 信号経路に遅延を追加します。 -
DelayNodeの役割は、制御されたレイテンシー 時間を追加することです。 -
BiquadFilterNodeおよびIIRFilterNodeのフィルター 設計は、因果的なフィルタリング処理の自然な結果として、 入力サンプルを遅延させることがあります。 -
ConvolverNodeは、インパルスによっては、 畳み込み処理の自然な結果として入力サンプルを遅延させることがあります。 -
DynamicsCompressorNodeには、信号経路に遅延を生じさせる 先読みアルゴリズムがあります。 -
MediaStreamAudioSourceNode、MediaStreamTrackAudioSourceNodeおよびMediaStreamAudioDestinationNodeは、実装によっては、 遅延を追加するバッファーを内部に追加することがあります。 -
ScriptProcessorNodeは、制御スレッドとレンダリングスレッドの間に バッファーを持つことがあります。 -
WaveShaperNodeは、オーバーサンプリング時に、使用する オーバーサンプリング手法によっては信号経路に遅延を追加します。
7.2. オーディオバッファーのコピー
AudioBuffer
に対して 内容を取得する
操作が実行される場合、通常は操作全体を
チャンネルデータのコピーなしで実装できます。
特に、最後の手順は次回の
getChannelData()
呼び出し時に遅延して実行するべきです。
これは、途中に getChannelData()
がない、連続する 内容を取得する操作のシーケンス
(たとえば、複数の
AudioBufferSourceNode
が同じ
AudioBuffer
を再生する場合)を、
割り当てやコピーなしで実装できることを意味します。
実装は追加の最適化を行えます。つまり、
AudioBuffer
上で getChannelData()
が呼び出されたとき、
新しい ArrayBuffer
がまだ割り当てられていないものの、
AudioBuffer
に対する以前の 内容を取得する操作のすべての呼び出し元が
AudioBuffer
のデータの使用を停止している場合、
生のデータバッファーを新しい
AudioBuffer
で使用するために再利用でき、
チャンネルデータの再割り当てやコピーを回避できます。
7.3. AudioParam の遷移
AudioParam
の value
属性を直接設定する際に自動的な平滑化は行われませんが、
一部のパラメーターでは、値を直接設定するより
滑らかな遷移の方が望ましい場合があります。
小さい timeConstant を指定して
setTargetAtTime()
メソッドを使用すると、
作者は滑らかな遷移を実現できます。
7.4. オーディオのグリッチ
オーディオグリッチは、通常の連続した オーディオストリームが中断されることで発生し、大きなクリック音やポップ音を生じさせます。 これはマルチメディアシステムの致命的な障害と見なされ、 回避しなければなりません。オーディオストリームをハードウェアへ 配信する役割を持つスレッドの問題、たとえば、 スレッドが適切な優先度や時間制約を持たないことによる スケジューリングレイテンシーによって発生することがあります。 また、オーディオ DSP が CPU の速度でリアルタイムに実行可能な量を超える 処理を行おうとすることによっても発生します。
8. プライバシーに関する考慮事項
自己レビュー質問票: セキュリティとプライバシー § 質問に従います:
-
この仕様は個人を特定できる情報を扱いますか?
Web Audio API を使用して聴力検査を実施し、 人に聞こえる周波数範囲(これは年齢とともに低下します)を 明らかにすることは可能です。ただし、能動的な参加が必要なため、 ユーザーが認識し同意することなくこれを行う方法を想定するのは困難です。
-
この仕様は高価値データを扱いますか?
いいえ。クレジットカード情報などは Web Audio では使用されません。 Web Audio を使用して音声データを処理または解析することは可能であり、 これはプライバシー上の懸念となる可能性がありますが、ユーザーの マイクへのアクセスは
getUserMedia()を介した権限ベースです。 -
この仕様は、ブラウジングセッションをまたいで持続する オリジン用の新しい状態を導入しますか?
いいえ。AudioWorklet はブラウジングセッションをまたいで持続しません。
-
この仕様は、永続的なクロスオリジン状態を Web に公開しますか?
はい。サポートされるオーディオサンプルレートと出力デバイスのチャンネル数が公開されます。
AudioContextを参照してください。 -
この仕様は、現在アクセスできないその他のデータを オリジンに公開しますか?
はい。利用可能な
AudioNodeに関するさまざまな情報を提供する際、Web Audio API はAudioNodeインターフェイスを使用する任意のページに対し、 クライアントの特徴的な機能(オーディオハードウェアのサンプルレートなど)に関する情報を 公開する可能性があります。さらに、AnalyserNodeまたはScriptProcessorNodeインターフェイスを通じてタイミング 情報を収集できます。この情報はその後、 クライアントのフィンガープリントを作成するために使用される可能性があります。Princeton CITP の Web Transparency and Accountability Project の研究では、
DynamicsCompressorNodeとOscillatorNodeを使用して クライアントからエントロピーを収集し、デバイスをフィンガープリントできることが示されています。 これは、異なる実装間の DSP アーキテクチャ、リサンプリング戦略、丸めのトレードオフにおける、 小さく通常は聞き取れない差異によるものです。 使用される正確なコンパイラーフラグや CPU アーキテクチャ (ARM 対 x86)も、このエントロピーに寄与します。しかし実際には、これは「プラットフォーム Y 上で実行されている ブラウザー X」といった、より簡単な方法(User Agent 文字列)ですでに容易に取得できる情報を 推測できるだけです。ただし、追加のフィンガープリンティングの可能性を減らすため、 任意のノードの出力から生じ得るフィンガープリンティングの問題を緩和する措置を ブラウザーが講じることを要求します。
クロックのずれによるフィンガープリンティングは、 Steven J Murdoch と Sebastian Zander によって 説明されています。これは
getOutputTimestampから判断できる可能性があります。 ずれに基づくフィンガープリンティングは Nakibly らによって HTML についても実証されています。 クロック解像度とドリフトに関するさらなる情報については、 High Resolution Time § 10. プライバシーに関する考慮事項の節を参照してください。レイテンシーによるフィンガープリンティングも可能であり、
baseLatencyおよびoutputLatencyからこれを推測できる可能性があります。 緩和策には、正確な ずれが誤って報告されるようジッター(ディザリング)や量子化を追加することが含まれます。 ただし、ほとんどのオーディオシステムは、WebAudio が生成したオーディオを 他のオーディオまたはビデオソース、あるいは視覚的な合図 (たとえばゲーム、オーディオ録音、音楽制作環境)と同期させるため、 低レイテンシーを目指していることに注意してください。 過度なレイテンシーは使いやすさを低下させ、 アクセシビリティ上の問題になる可能性があります。AudioContextのサンプルレートによるフィンガープリンティングも可能です。 これを最小限にするため、次の手順を推奨します:-
44.1 kHz と 48 kHz を既定のレートとして許可し、 システムは最適な適用性に応じてそのどちらかを選択します。 (当然、オーディオデバイスがネイティブに 44.1 の場合は 44.1 が選択されるなどしますが、 システムは最も「互換性のある」レートを選択することもあります。たとえば、 システムがネイティブに 96kHz の場合、 44.1kHz ではなく 48kHz が選択される可能性があります。
-
ネイティブに異なるレートを使用するデバイスについては、 リサンプリングされたオーディオによって追加のバッテリー消費が生じる可能性があるとしても、 システムはこれら 2 つのレートのいずれかへリサンプリングするべきです。 (ここでも、システムは最も互換性のあるレートを選択します。たとえば、 ネイティブシステムが 16kHz の場合、48kHz が選択されると予想されます。)
-
ブラウザーは、デバイス上のブラウザーでフラグを設定するなどして、 ネイティブレートの使用を強制するユーザー向け手段を提供すると予想されます (ただし必須ではありません)。 この設定は API には公開されません。
-
AudioContextのコンストラクターで異なるレートを明示的に要求できることも、 想定される動作です (これはすでに仕様に含まれており、通常は要求された sampleRate でオーディオレンダリングを行い、その後デバイス出力へアップサンプリング またはダウンサンプリングします)。 そして、そのレートがネイティブにサポートされている場合、 レンダリングをそのまま渡すことができます。 これにより、ユーザーの介入なしでアプリがより高いレートでレンダリングできます (ただし、オーディオ出力でダウンサンプリングされていないことは Web Audio から観測できません)。たとえば、MediaDevicesの機能が(ユーザーの介入によって)読み取られ、 より高いレートがサポートされることを示している場合です。
AudioContextのレンダー量子サイズによるフィンガープリンティングは、"hardware"ヒントを使用した場合に可能です。これは ユーザーの既定のオーディオハードウェアバッファー サイズに関する情報を公開するためです。このリスクを最小化するため、renderQuantumSizeは、AudioContextが"running"状態へ遷移するまで 0 を返します。AudioContextが"running"状態へ遷移した後は、 実際のレンダー量子サイズが返されます。実行中の AudioContext はAudioWorkletのタイミングを介してユーザーのオーディオハードウェアバッファーサイズを推測するために使用できるため、 これは新しい情報を公開しません。AudioContextの出力チャンネル数によるフィンガープリンティングも可能です。maxChannelCountは 2 (ステレオ)に設定することを推奨します。ステレオは圧倒的に最も一般的な チャンネル数です。 -
-
この仕様は、オリジンにユーザーの 位置へのアクセスを許可しますか?
いいえ。
-
この仕様は、オリジンにユーザーのデバイス上の センサーへのアクセスを許可しますか?
直接には許可しません。現在、この文書ではオーディオ入力は 規定されていませんが、クライアントマシンのオーディオ入力または マイクへのアクセスを取得することになります。その場合、 適切な方法でユーザーに権限を求める必要があり、おそらく
getUserMedia()API を介します。さらに、 Media Capture and Streams 仕様のセキュリティおよびプライバシーに関する考慮事項にも 注意するべきです。特に、周囲のオーディオを解析したり一意のオーディオを再生したりすると、 部屋単位のユーザー位置、さらには異なるユーザーや デバイスが同じ部屋を同時に占有していることを特定できる可能性があります。 オーディオ出力とオーディオ入力の両方へのアクセスにより、 1 つのブラウザー内で本来分離されているコンテキスト間の通信が可能になることもあります。
-
この仕様は、オリジンにユーザーの ローカルコンピューティング環境の側面へのアクセスを許可しますか?
直接には許可しません。要求されたすべてのサンプルレートがサポートされ、 必要な場合はアップサンプリングされます。 Media Capture and Streams を使用して、 MediaTrackSupportedConstraints でサポートされているオーディオサンプルレートを調査することは可能です。 これには明示的なユーザーの同意が必要です。 これはわずかなフィンガープリンティング情報を提供します。しかし、 実際にはほとんどのコンシューマーおよびプロシューマー向けデバイスは、 2 つの標準化されたサンプルレートのいずれかを使用します。44.1kHz (元々 CD で使用)と 48kHz(元々 DAT で使用)です。 リソースが非常に制約されたデバイスは音声品質の 11kHz サンプルレートを サポートする場合があり、より高級なデバイスは 88.2、96、 さらにはオーディオファイル向けの 192kHz レートをサポートすることがよくあります。
すべての実装に、48kHz のような単一の広くサポートされた レートへのアップサンプリングを要求すると、特段の利点なく CPU コストが増加し、 高級デバイスに低いレートの使用を要求すると、 Web Audio がプロフェッショナル用途には不適切だと見なされるだけです。
-
この仕様は一時的な識別子を Web に公開しますか?
いいえ。
-
この仕様はファーストパーティコンテキストと サードパーティコンテキストで動作を区別しますか?
いいえ。
-
この仕様は、ユーザーエージェントの 「シークレット」モードでどのように動作するべきですか?
異なる動作はしません。
-
この仕様はユーザーのローカルデバイスへデータを永続化しますか?
いいえ。
-
この仕様には「セキュリティに関する考慮事項」と 「プライバシーに関する考慮事項」の節がありますか?
はい(現在読んでいるものです)。
9. セキュリティに関する考慮事項
自己レビュー質問票: セキュリティとプライバシー § 質問に従います:
-
この仕様は、新しいスクリプト実行/読み込み 機構を有効にしますか?
いいえ。ただし、[HTML] で定義されているスクリプト実行方法を 使用します。
-
この仕様は、オリジンに他のデバイスへのアクセスを許可しますか?
通常、他のネットワーク接続デバイスへのアクセスは許可しません (高級録音スタジオの例外として Dante ネットワーク接続 デバイスが考えられますが、通常これらは別の専用ネットワークを使用します)。 必然的に、ユーザーのオーディオ出力デバイス または複数のデバイスへのアクセスは許可します。それらはコンピューターとは別の装置である場合があります。
音声または音で作動するデバイスの場合、Web Audio API が 他のデバイスの制御に使用される可能性があります。 さらに、音で作動するデバイスが近超音波周波数に敏感である場合、 そのような制御は聞き取れない可能性があります。 この可能性は HTML にも存在し、 <audio> または <video> 要素を通じて実現できます。 一般的なオーディオサンプリングレートでは、設計上、 超音波情報のための余裕はほとんどありません:
人間の聴覚の上限は通常 20kHz とされています。 44.1kHz のサンプリングレートでは、ナイキスト限界は 22.05kHz です。 真のブリックウォールフィルターは物理的に実現できないため、 20kHz から 22.05kHz の間の領域は、ナイキストを超えるすべての周波数を 強く減衰させる急峻なロールオフフィルターに使用されます。
48kHz のサンプリングレートでも、20kHz から 24kHz の帯域では 急速な減衰があります(ただし通過帯域での位相リップル エラーを回避しやすくなります)。
-
この仕様は、オリジンにユーザーエージェントのネイティブ UI を ある程度制御することを許可しますか?
UI に音声アシスタントやスクリーンリーダーのようなオーディオ要素がある場合、 Web Audio API を使用してネイティブ UI の側面を模倣し、 攻撃をローカルシステムイベントらしく見せる可能性があります。 この可能性は HTML にも存在し、 <audio> 要素を通じて実現できます。
-
この仕様は、既定のセキュリティ 特性のダウングレードを許可しますか?
いいえ。
10. 要件とユースケース
[webaudio-usecases]を参照してください。
11. 仕様コードの共通定義
この節では、この仕様内で使用される JavaScript コードが利用する 共通の関数とクラスについて説明します。
// 3 次元ベクトルクラス。 class Vec3{ // 3 つの座標から構築する。 constructor ( x, y, z) { this . x= x; this . y= y; this . z= z; } // 別のベクトルとの内積。 dot( v) { return ( this . x* v. x) + ( this . y* v. y) + ( this . z* v. z); } // 別のベクトルとの外積。 cross( v) { return new Vec3(( this . y* v. z) - ( this . z* v. y), ( this . z* v. x) - ( this . x* v. z), ( this . x* v. y) - ( this . y* v. x)); } // 別のベクトルとの差。 diff( v) { return new Vec3( this . x- v. x, this . y- v. y, this . z- v. z); } // このベクトルの大きさを取得する。 get magnitude() { return Math. sqrt( dot( this )); } // このベクトルにスカラーを掛けたコピーを取得する。 scale( s) { return new Vec3( this . x* s, this . y* s, this . z* s); } // このベクトルを正規化したコピーを取得する。 normalize() { const m= magnitude; if ( m== 0 ) { return new Vec3( 0 , 0 , 0 ); } return scale( 1 / m); } }
12. 変更履歴
12.1. 2024年11月05日の最初の公開作業草案以降
- PR 2688: 投機的 PR プレビューの修正
- PR 2686: プライバシーに関する考慮事項とセキュリティに関する考慮事項を 別々の節に分割
- PR 2679: Slack 登録リンクを追加
- PR 2676: expected-errs.txt の形式を更新
- PR 2675: OfflineAudioContext の増分/チャンクレンダリング
- PR 2667: レンダー量子サイズの範囲制約と renderSizeHint の処理を規定
- PR 2657: 実装に [3000, 768000] Hz のサンプルレート範囲のサポートを要求
- PR 2656: expected-errs.txt を修正
- PR 2654: 基本的な誤字を修正
- PR 2633: interrupted 状態と sink ID のエラー処理を追加
- PR 2617: currentTime の文言を改訂
13. 謝辞
この仕様は W3C Audio Working Group の共同作業によるものです。
ワーキンググループの現メンバー、元メンバー、および仕様への貢献者は
(執筆時点で、アルファベット順)次のとおりです:
Adenot, Paul (Mozilla Foundation) - 仕様共同編集者;
Akhgari, Ehsan (Mozilla Foundation);
Becker, Steven (Microsoft Corporation);
Berkovitz, Joe (Invited Expert, affiliated with Noteflight/Hal Leonard) - 2013年9月から
2017年12月まで WG 共同議長;
Bossart, Pierre (Intel Corporation);
Borins, Myles (Google, Inc);
Buffa, Michel (NSAU);
Caceres, Marcos (Invited Expert);
Cardoso, Gabriel (INRIA);
Carlson, Eric (Apple, Inc);
Chen, Bin (Baidu, Inc);
Choi, Hongchan (Google, Inc) - 仕様共同編集者;
Collichio, Lisa (Qualcomm);
Geelnard, Marcus (Opera Software);
Gehring, Todd (Dolby Laboratories);
Goode, Adam (Google, Inc);
Gregan, Matthew (Mozilla Foundation);
Hikawa, Kazuo (AMEI);
Hofmann, Bill (Dolby Laboratories);
Jägenstedt, Philip (Google, Inc);
Jeong, Paul Changjin (HTML5 Converged Technology Forum);
Kalliokoski, Jussi (Invited Expert);
Lee, WonSuk (Electronics and Telecommunications Research Institute);
Kakishita, Masahiro (AMEI);
Kawai, Ryoya (AMEI);
Kostiainen, Anssi (Intel Corporation);
Lilley, Chris (W3C Staff);
Lowis, Chris (Invited Expert) - 2012年12月から2013年9月まで WG 共同議長、British
Broadcasting Corporation 所属;
MacDonald, Alistair (W3C Invited Experts) — 2011年3月から2012年7月まで WG 共同議長;
Mandyam, Giridhar (Qualcomm Innovation Center, Inc);
Michel, Thierry (W3C/ERCIM);
Nair, Varun (Facebook);
Needham, Chris (British Broadcasting Corporation);
Noble, Jer (Apple, Inc);
O’Callahan, Robert(Mozilla Foundation);
Onumonu, Anthony (British Broadcasting Corporation);
Paradis, Matthew (British Broadcasting Corporation) - 2013年9月から現在まで WG 共同議長;
Pozdnyakov, Mikhail (Intel Corporation);
Raman, T.V. (Google, Inc);
Rogers, Chris (Google, Inc);
Schepers, Doug (W3C/MIT);
Schmitz, Alexander (JS Foundation);
Shires, Glen (Google, Inc);
Smith, Jerry (Microsoft Corporation);
Smith, Michael (W3C/Keio);
Thereaux, Olivier (British Broadcasting Corporation);
Toy, Raymond (Google, Inc.) - 2017年12月から現在まで WG 共同議長;
Toyoshima, Takashi (Google, Inc);
Troncy, Raphael (Institut Telecom);
Verdie, Jean-Charles (MStar Semiconductor, Inc.);
Wei, James (Intel Corporation);
Weitnauer, Michael (IRT);
Wilson, Chris (Google,Inc);
Zergaoui, Mohamed (INNOVIMAX)